


 首页
Moonshot AI 与清华大学为数据中心提出 PrfaaS 架构
由于大型语言模型(LLM)在推理过程中需要更强的计算能力,传统的服务架构因此面临瓶颈。 Moonshot AI 与清华大学的研究团队合作,推出了一种名为“预填充即服务”(Pre-filling as a Service,PrfaaS)的创新架构,旨在克服大型语言模型服务中数据中心和计算资源的限制。
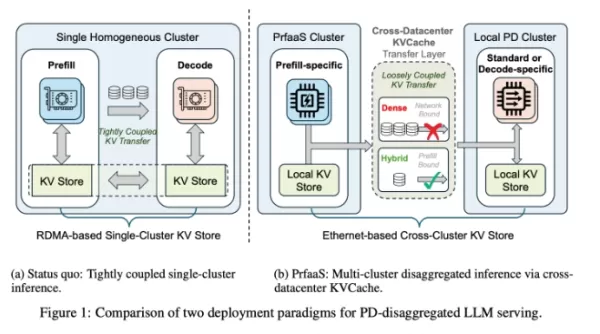
大型语言模型的推理过程通常分为两个阶段:预填充和解码。预填充阶段计算密集,模型在此阶段处理输入并创建键值缓存(KVCache);解码阶段则对内存带宽要求极高,会依次生成输出结果。 传统架构要求这两个阶段均在同一数据中心内进行,从而导致计算和带宽方面的限制。
PrfaaS 通过将预填充任务卸载至专用的高计算力集群,并利用标准以太网网络将生成的 KVCache 传输至本地解码集群,从而实现了高效的跨数据中心服务。研究表明,该架构可提升处理性能,服务吞吐量较传统模型提高了 54%。 实际案例研究也表明,该架构具有更低的延迟和更高的效率。
PrfaaS 架构将计算、网络和存储这三个主要子系统解耦,并分别进行独立管理。精确的路由机制确保了长请求的高效传输,避免了传统方法中因资源分配不均而导致的拥塞。此外,双时间尺度调度机制可适应多变的流量模式,进一步优化资源利用率。
随着跨数据中心推理需求的增长以及新硬件的不断涌现,PrfaaS 为未来的人工智能应用提供了一种极具前景的解决方案。
相关文章
 阿里视频发布万3.0,实现超长视频生成与多维度一致性
8月24日,阿里巴巴发布了万3.0,这是其最新的视频生成大模型。此次发布标志着阿里巴巴视频技术的重大飞跃,在时长、通用创作、参考处理以及真实世界模拟方面实现了显著提升。万3.0将单视频生成的时长扩展至30秒,在单个镜头内提供了更为丰富的叙事可能性。它还引入了对多种主流文件格式的支持——包括doc、xls、ppt、pdf和md——使得文本、表格和幻灯片能够直接转换为动态视觉内容。为了解决视觉不一致和风格漂移等常见挑战,万3.0在微观层面确保了高度的稳定性。它在角色外观、道具细节、音频设置、空间关系
MiniMax大模型误读姓名——稀宇科技:特定Token后训练不足
MiniMax 最近发布了一份技术报告,详细解释了其 M2 系列模型为何难以准确生成“马嘉祺”等特定名称。这一看似错误的现象凸显了当前大语言模型训练中存在的系统性缺陷。Token 偏移:被挤压的向量空间根本原因在于分词器(tokenizer),即文本处理的基本单位。例如,名称“马嘉祺”被拆分为两个 Token:“Ma”和“Jiaqi”。虽然模型在预训练阶段学习了这些 Token,但在随后的指令微调阶段出现了问题。在微调期间,Token “Jiaqi”在对话数据中出现的频率极低,因此几乎未接受任何
英伟达H200中国交易在特朗普与习近平峰会后得以保留,但结果与预期不符
特朗普总统前往北京,黄仁勋在最后一刻加入了代表团,两天后离京时仅就芯片出口的潜在进展发表了含糊其辞的言论。双方未达成任何协议。自特朗普于2025年12月首次批准销售以来,尚未有一颗英伟达H200芯片进入中国。 美国贸易代表杰米森·格里尔向彭博社证实,半导体限制措施甚至未被列入双边议程。在峰会的盛况之下,隐藏着更重大的转变。H200芯片的供应受阻并非源于华盛顿的拒绝;美国实际上已经批准了出口。 包括
相关专题推荐
设计与艺术
 顶级AI插画工具:更快地创作编辑类场景和封面插图
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
 10 个工具
 xix.ai
教育与学习
备考首选的顶尖AI辅导老师:练习数学、科学和英语
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
金融
用于个人财务管理的 AI 预算规划工具
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
健康养生
AI睡眠追踪助手:通过养成更好的睡前习惯来促进身体恢复
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
数据分析
用于产品和收入分析的 AI SQL 辅助工具
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
教育与学习
最佳的、兼具教学功能的AI作业助手:学习概念,而不仅仅是答案
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

 评论 (10)
0/500
![JuanJackson]()
Интересная архитектура PrfaS от Moonshot и Цинхуа для решения проблем с вычислительной мощностью LLM. Надеюсь, это поможет оптимизировать центры обработки данных! 🚀
![EricNelson]()
A arquitetura PrfaS proposta por Moonshot e Tsinghua é um passo interessante para resolver gargalos de computação em LLMs. Será que isso viabiliza data centers mais eficientes? 🤔
![WillieJones]()
La arquitectura PrfaS de Moonshot y Tsinghua parece una gran solución para los cuellos de botella en centros de datos con LLMs. ¡Esperamos ver resultados concretos pronto! 📈
![WillieRamirez]()
Moonshot AI und Tsinghua zeigen mit PrfaS einen vielversprechenden Ansatz gegen Rechenengpässe bei LLMs. Spannend zu sehen, wie diese Kooperation die Datenzukunft gestaltet! 🌐
![MateoAdams]()
대규모 LLM 추론에 필요한 컴퓨팅 파워를 위해 청화대와 Moonshot이 제안한 PrfaS 아키텍처가 흥미롭네요. 데이터 센터 병목 현상을 해결할 열쇠가 될지 주목됩니다! 🚀
![HarryNelson]()
Moonshot AI 和清華大學提出的 PrfaS 架構看起來很有潛力,特別是針對 LLM 推理時的算力瓶頸。不知道實際部署後效能如何,持續關注中!💻✨
由于大型语言模型(LLM)在推理过程中需要更强的计算能力,传统的服务架构因此面临瓶颈。 Moonshot AI 与清华大学的研究团队合作,推出了一种名为“预填充即服务”(Pre-filling as a Service,PrfaaS)的创新架构,旨在克服大型语言模型服务中数据中心和计算资源的限制。
大型语言模型的推理过程通常分为两个阶段:预填充和解码。预填充阶段计算密集,模型在此阶段处理输入并创建键值缓存(KVCache);解码阶段则对内存带宽要求极高,会依次生成输出结果。 传统架构要求这两个阶段均在同一数据中心内进行,从而导致计算和带宽方面的限制。
PrfaaS 通过将预填充任务卸载至专用的高计算力集群,并利用标准以太网网络将生成的 KVCache 传输至本地解码集群,从而实现了高效的跨数据中心服务。研究表明,该架构可提升处理性能,服务吞吐量较传统模型提高了 54%。 实际案例研究也表明,该架构具有更低的延迟和更高的效率。
PrfaaS 架构将计算、网络和存储这三个主要子系统解耦,并分别进行独立管理。精确的路由机制确保了长请求的高效传输,避免了传统方法中因资源分配不均而导致的拥塞。此外,双时间尺度调度机制可适应多变的流量模式,进一步优化资源利用率。
随着跨数据中心推理需求的增长以及新硬件的不断涌现,PrfaaS 为未来的人工智能应用提供了一种极具前景的解决方案。








 阿里视频发布万3.0,实现超长视频生成与多维度一致性
8月24日,阿里巴巴发布了万3.0,这是其最新的视频生成大模型。此次发布标志着阿里巴巴视频技术的重大飞跃,在时长、通用创作、参考处理以及真实世界模拟方面实现了显著提升。万3.0将单视频生成的时长扩展至30秒,在单个镜头内提供了更为丰富的叙事可能性。它还引入了对多种主流文件格式的支持——包括doc、xls、ppt、pdf和md——使得文本、表格和幻灯片能够直接转换为动态视觉内容。为了解决视觉不一致和风格漂移等常见挑战,万3.0在微观层面确保了高度的稳定性。它在角色外观、道具细节、音频设置、空间关系
 MiniMax大模型误读姓名——稀宇科技:特定Token后训练不足
MiniMax 最近发布了一份技术报告,详细解释了其 M2 系列模型为何难以准确生成“马嘉祺”等特定名称。这一看似错误的现象凸显了当前大语言模型训练中存在的系统性缺陷。Token 偏移:被挤压的向量空间根本原因在于分词器(tokenizer),即文本处理的基本单位。例如,名称“马嘉祺”被拆分为两个 Token:“Ma”和“Jiaqi”。虽然模型在预训练阶段学习了这些 Token,但在随后的指令微调阶段出现了问题。在微调期间,Token “Jiaqi”在对话数据中出现的频率极低,因此几乎未接受任何
 英伟达H200中国交易在特朗普与习近平峰会后得以保留,但结果与预期不符
特朗普总统前往北京,黄仁勋在最后一刻加入了代表团,两天后离京时仅就芯片出口的潜在进展发表了含糊其辞的言论。双方未达成任何协议。自特朗普于2025年12月首次批准销售以来,尚未有一颗英伟达H200芯片进入中国。 美国贸易代表杰米森·格里尔向彭博社证实,半导体限制措施甚至未被列入双边议程。在峰会的盛况之下,隐藏着更重大的转变。H200芯片的供应受阻并非源于华盛顿的拒绝;美国实际上已经批准了出口。 包括
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
10 个工具
xix.ai
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

Интересная архитектура PrfaS от Moonshot и Цинхуа для решения проблем с вычислительной мощностью LLM. Надеюсь, это поможет оптимизировать центры обработки данных! 🚀
A arquitetura PrfaS proposta por Moonshot e Tsinghua é um passo interessante para resolver gargalos de computação em LLMs. Será que isso viabiliza data centers mais eficientes? 🤔
La arquitectura PrfaS de Moonshot y Tsinghua parece una gran solución para los cuellos de botella en centros de datos con LLMs. ¡Esperamos ver resultados concretos pronto! 📈
Moonshot AI und Tsinghua zeigen mit PrfaS einen vielversprechenden Ansatz gegen Rechenengpässe bei LLMs. Spannend zu sehen, wie diese Kooperation die Datenzukunft gestaltet! 🌐
대규모 LLM 추론에 필요한 컴퓨팅 파워를 위해 청화대와 Moonshot이 제안한 PrfaS 아키텍처가 흥미롭네요. 데이터 센터 병목 현상을 해결할 열쇠가 될지 주목됩니다! 🚀
Moonshot AI 和清華大學提出的 PrfaS 架構看起來很有潛力,特別是針對 LLM 推理時的算力瓶頸。不知道實際部署後效能如何,持續關注中!💻✨












