


 Heim
Moonshot AI und die Tsinghua-Universität schlagen eine PrfaaS-Architektur für Rechenzentren vor
Da große Sprachmodelle (LLMs) beim Schlussfolgern immer mehr Rechenleistung benötigen, stoßen herkömmliche Servicearchitekturen an ihre Grenzen. Moonshot AI hat in Zusammenarbeit mit einem Forschungsteam der Tsinghua-Universität eine neuartige Architektur namens „Pre-filling as a Service“ (PrfaaS) vorgestellt, die darauf abzielt, die Einschränkungen von Rechenzentren und Rechenressourcen bei LLM-Diensten zu überwinden.
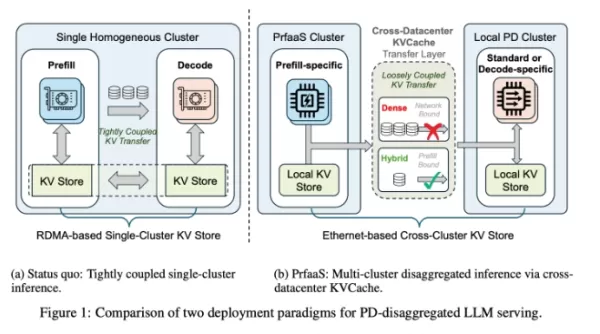
Der Schlussfolgerungsprozess großer Sprachmodelle gliedert sich im Allgemeinen in zwei Phasen: das „Pre-Filling“ und die Dekodierung. Das „Pre-Filling“ ist rechenintensiv: Dabei verarbeitet das Modell die Eingabe und erstellt einen Schlüssel-Wert-Cache (KVCache). Die Dekodierung ist speicherbandbreitenintensiv und erzeugt sequenziell Ausgaben. Bei herkömmlichen Konfigurationen müssen beide Phasen innerhalb desselben Rechenzentrums stattfinden, was zu Einschränkungen hinsichtlich Rechenleistung und Bandbreite führt.
PrfaaS ermöglicht einen effizienten datenzentrumsübergreifenden Dienst, indem es Pre-Filling-Aufgaben auf dedizierte Cluster mit hoher Rechenleistung auslagert und ein Standard-Ethernet-Netzwerk nutzt, um den generierten KVCache an lokale Dekodierungscluster zu übertragen. Forschungsergebnisse zeigen, dass diese Architektur die Verarbeitungsleistung steigert und im Vergleich zu herkömmlichen Modellen eine Steigerung des Dienstdurchsatzes um 54 % erzielt. Fallstudien aus der Praxis belegen zudem geringere Latenzzeiten und höhere Effizienz.
Die PrfaaS-Architektur entkoppelt die drei Hauptsubsysteme – Rechenleistung, Netzwerk und Speicher – und verwaltet jedes davon unabhängig. Ein präziser Routing-Mechanismus gewährleistet die effiziente Übertragung langer Anfragen und verhindert so Überlastungen durch eine ungleichmäßige Ressourcenzuweisung, wie sie bei herkömmlichen Ansätzen auftritt. Darüber hinaus passt sich ein Scheduling-Mechanismus mit zwei Zeitskalen an schwankende Verkehrsmuster an und optimiert so die Ressourcennutzung weiter.
Angesichts der steigenden Nachfrage nach datenzentrumsübergreifenden Schlussfolgerungen und der kontinuierlichen Entwicklung neuer Hardware bietet PrfaaS eine vielversprechende Lösung für zukünftige KI-Anwendungen.
Verwandter Artikel
 AliVideo stellt Wan3.0 vor und liefert ultra-lange Video-Generierung sowie multidimensionale Konsistenz
Am 24. August stellte Alibaba Wan3.0 vor, sein neuestes großes Video-Generierungsmodell. Diese Veröffentlichung stellt einen bedeutenden Fortschritt in Alibabas Videotechnologie dar und bietet erhebliche Verbesserungen in Bezug auf Dauer, universelle
MiniMax-Großmodell spricht Namen falsch aus – Xiyu Technology: Unzureichendes Training nach bestimmten Token
MiniMax hat kürzlich einen technischen Bericht veröffentlicht, der detailliert erläutert, warum seine M2-Modellserie Schwierigkeiten hatte, spezifische Namen wie „Ma Jiaqi“ korrekt zu generieren. Dieser scheinbare Fehler hebt einen systemischen Mange
Das Nvidia-H200-Geschäft in China übersteht den Trump-Xi-Gipfel, jedoch nicht wie erwartet.
Präsident Trump reiste nach Peking, wobei Jensen Huang in letzter Minute der Delegation beitrat und zwei Tage später mit vagen Äußerungen zu möglichen Entwicklungen bei Chipexporten abreiste. Es kam zu keinem Deal. Seit Trump im Dezember 2025 den Ver
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 Die besten KI-Illustrationstools: Redaktionelle Szenen und Cover-Grafiken schneller erstellen
Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
 10 Tools
 xix.ai
Bildung und Lernen
Die besten KI-Nachhilfelehrer für die Prüfungsvorbereitung: Üben Sie Mathematik, Naturwissenschaften und Englisch
Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai
Finanzen
KI-Budgetplanungstools für das persönliche Geldmanagement
2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai
Gesundheit Wellness
KI-gestützte Schlafüberwachungsassistenten: Verbessern Sie Ihre Erholung durch bessere Gewohnheiten vor dem Schlafengehen
2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai
Datenanalyse
KI-gestützte SQL-Copilots für Produkt- und Umsatzanalysen
Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai
Bildung und Lernen
Die besten KI-Hausaufgabenhelfer, die wirklich etwas vermitteln: Lerne Konzepte, nicht nur Antworten
2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai

 Kommentare (10)
![JuanJackson]()
Интересная архитектура PrfaS от Moonshot и Цинхуа для решения проблем с вычислительной мощностью LLM. Надеюсь, это поможет оптимизировать центры обработки данных! 🚀
![EricNelson]()
A arquitetura PrfaS proposta por Moonshot e Tsinghua é um passo interessante para resolver gargalos de computação em LLMs. Será que isso viabiliza data centers mais eficientes? 🤔
![WillieJones]()
La arquitectura PrfaS de Moonshot y Tsinghua parece una gran solución para los cuellos de botella en centros de datos con LLMs. ¡Esperamos ver resultados concretos pronto! 📈
![WillieRamirez]()
Moonshot AI und Tsinghua zeigen mit PrfaS einen vielversprechenden Ansatz gegen Rechenengpässe bei LLMs. Spannend zu sehen, wie diese Kooperation die Datenzukunft gestaltet! 🌐
![MateoAdams]()
대규모 LLM 추론에 필요한 컴퓨팅 파워를 위해 청화대와 Moonshot이 제안한 PrfaS 아키텍처가 흥미롭네요. 데이터 센터 병목 현상을 해결할 열쇠가 될지 주목됩니다! 🚀
![HarryNelson]()
Moonshot AI 和清華大學提出的 PrfaS 架構看起來很有潛力,特別是針對 LLM 推理時的算力瓶頸。不知道實際部署後效能如何,持續關注中!💻✨
Da große Sprachmodelle (LLMs) beim Schlussfolgern immer mehr Rechenleistung benötigen, stoßen herkömmliche Servicearchitekturen an ihre Grenzen. Moonshot AI hat in Zusammenarbeit mit einem Forschungsteam der Tsinghua-Universität eine neuartige Architektur namens „Pre-filling as a Service“ (PrfaaS) vorgestellt, die darauf abzielt, die Einschränkungen von Rechenzentren und Rechenressourcen bei LLM-Diensten zu überwinden.
Der Schlussfolgerungsprozess großer Sprachmodelle gliedert sich im Allgemeinen in zwei Phasen: das „Pre-Filling“ und die Dekodierung. Das „Pre-Filling“ ist rechenintensiv: Dabei verarbeitet das Modell die Eingabe und erstellt einen Schlüssel-Wert-Cache (KVCache). Die Dekodierung ist speicherbandbreitenintensiv und erzeugt sequenziell Ausgaben. Bei herkömmlichen Konfigurationen müssen beide Phasen innerhalb desselben Rechenzentrums stattfinden, was zu Einschränkungen hinsichtlich Rechenleistung und Bandbreite führt.
PrfaaS ermöglicht einen effizienten datenzentrumsübergreifenden Dienst, indem es Pre-Filling-Aufgaben auf dedizierte Cluster mit hoher Rechenleistung auslagert und ein Standard-Ethernet-Netzwerk nutzt, um den generierten KVCache an lokale Dekodierungscluster zu übertragen. Forschungsergebnisse zeigen, dass diese Architektur die Verarbeitungsleistung steigert und im Vergleich zu herkömmlichen Modellen eine Steigerung des Dienstdurchsatzes um 54 % erzielt. Fallstudien aus der Praxis belegen zudem geringere Latenzzeiten und höhere Effizienz.
Die PrfaaS-Architektur entkoppelt die drei Hauptsubsysteme – Rechenleistung, Netzwerk und Speicher – und verwaltet jedes davon unabhängig. Ein präziser Routing-Mechanismus gewährleistet die effiziente Übertragung langer Anfragen und verhindert so Überlastungen durch eine ungleichmäßige Ressourcenzuweisung, wie sie bei herkömmlichen Ansätzen auftritt. Darüber hinaus passt sich ein Scheduling-Mechanismus mit zwei Zeitskalen an schwankende Verkehrsmuster an und optimiert so die Ressourcennutzung weiter.
Angesichts der steigenden Nachfrage nach datenzentrumsübergreifenden Schlussfolgerungen und der kontinuierlichen Entwicklung neuer Hardware bietet PrfaaS eine vielversprechende Lösung für zukünftige KI-Anwendungen.








 AliVideo stellt Wan3.0 vor und liefert ultra-lange Video-Generierung sowie multidimensionale Konsistenz
Am 24. August stellte Alibaba Wan3.0 vor, sein neuestes großes Video-Generierungsmodell. Diese Veröffentlichung stellt einen bedeutenden Fortschritt in Alibabas Videotechnologie dar und bietet erhebliche Verbesserungen in Bezug auf Dauer, universelle
 MiniMax-Großmodell spricht Namen falsch aus – Xiyu Technology: Unzureichendes Training nach bestimmten Token
MiniMax hat kürzlich einen technischen Bericht veröffentlicht, der detailliert erläutert, warum seine M2-Modellserie Schwierigkeiten hatte, spezifische Namen wie „Ma Jiaqi“ korrekt zu generieren. Dieser scheinbare Fehler hebt einen systemischen Mange
 Das Nvidia-H200-Geschäft in China übersteht den Trump-Xi-Gipfel, jedoch nicht wie erwartet.
Präsident Trump reiste nach Peking, wobei Jensen Huang in letzter Minute der Delegation beitrat und zwei Tage später mit vagen Äußerungen zu möglichen Entwicklungen bei Chipexporten abreiste. Es kam zu keinem Deal. Seit Trump im Dezember 2025 den Ver

Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai

2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai

2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai

Интересная архитектура PrfaS от Moonshot и Цинхуа для решения проблем с вычислительной мощностью LLM. Надеюсь, это поможет оптимизировать центры обработки данных! 🚀
A arquitetura PrfaS proposta por Moonshot e Tsinghua é um passo interessante para resolver gargalos de computação em LLMs. Será que isso viabiliza data centers mais eficientes? 🤔
La arquitectura PrfaS de Moonshot y Tsinghua parece una gran solución para los cuellos de botella en centros de datos con LLMs. ¡Esperamos ver resultados concretos pronto! 📈
Moonshot AI und Tsinghua zeigen mit PrfaS einen vielversprechenden Ansatz gegen Rechenengpässe bei LLMs. Spannend zu sehen, wie diese Kooperation die Datenzukunft gestaltet! 🌐
대규모 LLM 추론에 필요한 컴퓨팅 파워를 위해 청화대와 Moonshot이 제안한 PrfaS 아키텍처가 흥미롭네요. 데이터 센터 병목 현상을 해결할 열쇠가 될지 주목됩니다! 🚀
Moonshot AI 和清華大學提出的 PrfaS 架構看起來很有潛力,特別是針對 LLM 推理時的算力瓶頸。不知道實際部署後效能如何,持續關注中!💻✨












