


 Maison
Moonshot AI et l'université de Tsinghua proposent une architecture PrfaaS pour les centres de données
Les grands modèles linguistiques (LLM) nécessitant une puissance de calcul accrue lors des processus de raisonnement, les architectures de services traditionnelles se heurtent à des goulots d’étranglement. Moonshot AI, en collaboration avec une équipe de recherche de l’université de Tsinghua, a présenté une architecture novatrice appelée « Pre-filling as a Service » (PrfaaS), destinée à surmonter les contraintes liées aux centres de données et aux ressources de calcul dans les services LLM.
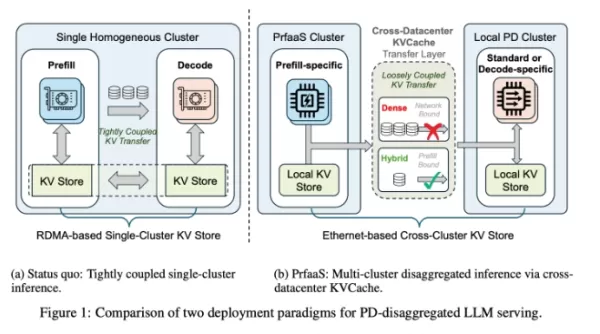
Le processus de raisonnement des grands modèles linguistiques se divise généralement en deux phases : le pré-remplissage et le décodage. Le pré-remplissage est une opération très gourmande en ressources de calcul, au cours de laquelle le modèle traite les données d’entrée et crée un cache clé-valeur (KVCache). Le décodage, quant à lui, sollicite fortement la bande passante mémoire et génère des résultats de manière séquentielle. Les configurations traditionnelles exigent que ces deux étapes se déroulent au sein du même centre de données, ce qui entraîne des contraintes en termes de puissance de calcul et de bande passante.
PrfaaS permet un service inter-centres de données efficace en déchargeant les tâches de préremplissage vers des clusters dédiés à haute puissance de calcul, tout en utilisant un réseau Ethernet standard pour transférer le KVCache généré vers les clusters de décodage locaux. Des recherches indiquent que cette architecture améliore les performances de traitement, permettant une augmentation de 54 % du débit du service par rapport aux modèles traditionnels. Des études de cas concrets démontrent également une latence réduite et une efficacité accrue.
L’architecture PrfaaS dissocie les trois sous-systèmes principaux — calcul, réseau et stockage — en les gérant chacun de manière indépendante. Un mécanisme de routage précis assure une transmission efficace des requêtes longues, empêchant ainsi la congestion due à une répartition inégale des ressources, comme c’est le cas dans les approches traditionnelles. De plus, un mécanisme de planification à double échelle de temps s’adapte aux variations des modèles de trafic, optimisant encore davantage l’utilisation des ressources.
Alors que la demande en matière de raisonnement inter-centres de données ne cesse de croître et que de nouveaux matériels continuent d’apparaître, PrfaaS offre une solution prometteuse pour les futures applications d’IA.
Article connexe
 AliVideo dévoille Wan3.0, offrant une génération de vidéos ultra-longues et une cohérence multidimensionnelle
Le 24 août, Alibaba a dévoilé Wan3.0, son dernier modèle de génération vidéo à grande échelle. Cette version représente une avancée majeure pour la technologie vidéo d’Alibaba, offrant des améliorations significatives en termes de durée, de création
MiniMax Grand Modèle Mal Prononce les Noms - Xiyu Technology : Entraînement Insuffisant Après des Jetons Spécifiques
MiniMax a récemment publié un rapport technique détaillant les raisons pour lesquelles ses modèles de la série M2 ont eu du mal à générer avec précision des noms spécifiques tels que « Ma Jiaqi ». Cette erreur apparente met en lumière une faille syst
L'accord entre Nvidia et la Chine concernant le H200 survit au sommet Trump-Xi, mais pas comme prévu
Le président Trump s’est rendu à Pékin, Jensen Huang ayant rejoint la délégation à la dernière minute, et est reparti deux jours plus tard en se contentant de remarques vagues sur d’éventuelles évolut
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (10)
![JuanJackson]()
Интересная архитектура PrfaS от Moonshot и Цинхуа для решения проблем с вычислительной мощностью LLM. Надеюсь, это поможет оптимизировать центры обработки данных! 🚀
![EricNelson]()
A arquitetura PrfaS proposta por Moonshot e Tsinghua é um passo interessante para resolver gargalos de computação em LLMs. Será que isso viabiliza data centers mais eficientes? 🤔
![WillieJones]()
La arquitectura PrfaS de Moonshot y Tsinghua parece una gran solución para los cuellos de botella en centros de datos con LLMs. ¡Esperamos ver resultados concretos pronto! 📈
![WillieRamirez]()
Moonshot AI und Tsinghua zeigen mit PrfaS einen vielversprechenden Ansatz gegen Rechenengpässe bei LLMs. Spannend zu sehen, wie diese Kooperation die Datenzukunft gestaltet! 🌐
![MateoAdams]()
대규모 LLM 추론에 필요한 컴퓨팅 파워를 위해 청화대와 Moonshot이 제안한 PrfaS 아키텍처가 흥미롭네요. 데이터 센터 병목 현상을 해결할 열쇠가 될지 주목됩니다! 🚀
![HarryNelson]()
Moonshot AI 和清華大學提出的 PrfaS 架構看起來很有潛力,特別是針對 LLM 推理時的算力瓶頸。不知道實際部署後效能如何,持續關注中!💻✨
Les grands modèles linguistiques (LLM) nécessitant une puissance de calcul accrue lors des processus de raisonnement, les architectures de services traditionnelles se heurtent à des goulots d’étranglement. Moonshot AI, en collaboration avec une équipe de recherche de l’université de Tsinghua, a présenté une architecture novatrice appelée « Pre-filling as a Service » (PrfaaS), destinée à surmonter les contraintes liées aux centres de données et aux ressources de calcul dans les services LLM.
Le processus de raisonnement des grands modèles linguistiques se divise généralement en deux phases : le pré-remplissage et le décodage. Le pré-remplissage est une opération très gourmande en ressources de calcul, au cours de laquelle le modèle traite les données d’entrée et crée un cache clé-valeur (KVCache). Le décodage, quant à lui, sollicite fortement la bande passante mémoire et génère des résultats de manière séquentielle. Les configurations traditionnelles exigent que ces deux étapes se déroulent au sein du même centre de données, ce qui entraîne des contraintes en termes de puissance de calcul et de bande passante.
PrfaaS permet un service inter-centres de données efficace en déchargeant les tâches de préremplissage vers des clusters dédiés à haute puissance de calcul, tout en utilisant un réseau Ethernet standard pour transférer le KVCache généré vers les clusters de décodage locaux. Des recherches indiquent que cette architecture améliore les performances de traitement, permettant une augmentation de 54 % du débit du service par rapport aux modèles traditionnels. Des études de cas concrets démontrent également une latence réduite et une efficacité accrue.
L’architecture PrfaaS dissocie les trois sous-systèmes principaux — calcul, réseau et stockage — en les gérant chacun de manière indépendante. Un mécanisme de routage précis assure une transmission efficace des requêtes longues, empêchant ainsi la congestion due à une répartition inégale des ressources, comme c’est le cas dans les approches traditionnelles. De plus, un mécanisme de planification à double échelle de temps s’adapte aux variations des modèles de trafic, optimisant encore davantage l’utilisation des ressources.
Alors que la demande en matière de raisonnement inter-centres de données ne cesse de croître et que de nouveaux matériels continuent d’apparaître, PrfaaS offre une solution prometteuse pour les futures applications d’IA.








 AliVideo dévoille Wan3.0, offrant une génération de vidéos ultra-longues et une cohérence multidimensionnelle
Le 24 août, Alibaba a dévoilé Wan3.0, son dernier modèle de génération vidéo à grande échelle. Cette version représente une avancée majeure pour la technologie vidéo d’Alibaba, offrant des améliorations significatives en termes de durée, de création
 MiniMax Grand Modèle Mal Prononce les Noms - Xiyu Technology : Entraînement Insuffisant Après des Jetons Spécifiques
MiniMax a récemment publié un rapport technique détaillant les raisons pour lesquelles ses modèles de la série M2 ont eu du mal à générer avec précision des noms spécifiques tels que « Ma Jiaqi ». Cette erreur apparente met en lumière une faille syst
 L'accord entre Nvidia et la Chine concernant le H200 survit au sommet Trump-Xi, mais pas comme prévu
Le président Trump s’est rendu à Pékin, Jensen Huang ayant rejoint la délégation à la dernière minute, et est reparti deux jours plus tard en se contentant de remarques vagues sur d’éventuelles évolut

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

Интересная архитектура PrfaS от Moonshot и Цинхуа для решения проблем с вычислительной мощностью LLM. Надеюсь, это поможет оптимизировать центры обработки данных! 🚀
A arquitetura PrfaS proposta por Moonshot e Tsinghua é um passo interessante para resolver gargalos de computação em LLMs. Será que isso viabiliza data centers mais eficientes? 🤔
La arquitectura PrfaS de Moonshot y Tsinghua parece una gran solución para los cuellos de botella en centros de datos con LLMs. ¡Esperamos ver resultados concretos pronto! 📈
Moonshot AI und Tsinghua zeigen mit PrfaS einen vielversprechenden Ansatz gegen Rechenengpässe bei LLMs. Spannend zu sehen, wie diese Kooperation die Datenzukunft gestaltet! 🌐
대규모 LLM 추론에 필요한 컴퓨팅 파워를 위해 청화대와 Moonshot이 제안한 PrfaS 아키텍처가 흥미롭네요. 데이터 센터 병목 현상을 해결할 열쇠가 될지 주목됩니다! 🚀
Moonshot AI 和清華大學提出的 PrfaS 架構看起來很有潛力,特別是針對 LLM 推理時的算力瓶頸。不知道實際部署後效能如何,持續關注中!💻✨












