


 Hogar
Moonshot AI y la Universidad de Tsinghua proponen una arquitectura PrfaaS para centros de datos
Dado que los modelos de lenguaje a gran escala (LLM) requieren una mayor potencia computacional durante el razonamiento, las arquitecturas de servicio convencionales se enfrentan a cuellos de botella. Moonshot AI, en colaboración con un equipo de investigación de la Universidad de Tsinghua, ha presentado una novedosa arquitectura denominada «Pre-filling as a Service» (PrfaaS), destinada a superar las limitaciones de los centros de datos y los recursos informáticos en los servicios de LLM.
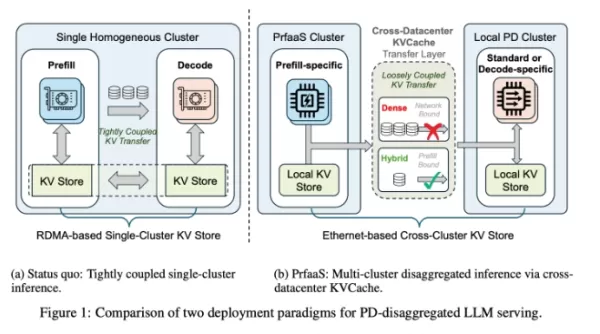
El proceso de razonamiento de los modelos de lenguaje a gran escala se divide generalmente en dos fases: el pre-relleno y la decodificación. El pre-relleno requiere un gran esfuerzo computacional, ya que el modelo procesa la entrada y crea una caché de clave-valor (KVCache). La decodificación consume mucho ancho de banda de memoria, ya que genera resultados de forma secuencial. Las configuraciones tradicionales requieren que ambas etapas se desarrollen dentro del mismo centro de datos, lo que genera limitaciones en cuanto a computación y ancho de banda.
PrfaaS permite un servicio eficiente entre centros de datos al descargar las tareas de prellenado a clústeres dedicados de alta potencia computacional, utilizando una red Ethernet estándar para transferir la KVCache generada a los clústeres de decodificación locales. Las investigaciones indican que esta arquitectura potencia el rendimiento del procesamiento, logrando un aumento del 54 % en el rendimiento del servicio con respecto a los modelos tradicionales. Los estudios de casos reales también muestran una menor latencia y una mayor eficiencia.
La arquitectura PrfaaS desacopla los tres subsistemas principales —computación, redes y almacenamiento— y gestiona cada uno de ellos de forma independiente. Un mecanismo de enrutamiento preciso garantiza la transmisión eficiente de solicitudes largas, evitando la congestión derivada de una asignación desigual de recursos, como ocurre en los enfoques tradicionales. Además, un mecanismo de programación de doble escala temporal se adapta a los patrones de tráfico variables, optimizando aún más el uso de los recursos.
A medida que crece la demanda de razonamiento entre centros de datos y sigue surgiendo nuevo hardware, PrfaaS ofrece una solución prometedora para las futuras aplicaciones de IA.
Artículo relacionado
 AliVideo presenta Wan3.0, ofreciendo generación de vídeo ultra largo y consistencia multidimensional
El 24 de agosto, Alibaba presentó Wan3.0, su último modelo de generación de video a gran escala. Este lanzamiento representa un avance importante en la tecnología de video de Alibaba, ofreciendo mejoras significativas en duración, creación universal,
MiniMax Grandes Modelos Pronuncian Incorrectamente Nombres - Xiyu Technology: Entrenamiento Insuficiente Después de Tokens Específicos
MiniMax publicó recientemente un informe técnico que detalla por qué sus modelos de la serie M2 tuvieron dificultades para generar con precisión nombres específicos como "Ma Jiaqi". Este aparente error destaca una falla sistémica en el entrenamiento
El acuerdo de Nvidia con China para el H200 sobrevive a la cumbre Trump-Xi, pero no como se esperaba
El presidente Trump viajó a Pekín con Jensen Huang uniéndose a la delegación en el último momento, partiendo dos días después con declaraciones vagas sobre posibles desarrollos en la exportación de chips. No se concretó ningún acuerdo. Desde que Trum
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (10)
0/500
![JuanJackson]()
Интересная архитектура PrfaS от Moonshot и Цинхуа для решения проблем с вычислительной мощностью LLM. Надеюсь, это поможет оптимизировать центры обработки данных! 🚀
![EricNelson]()
A arquitetura PrfaS proposta por Moonshot e Tsinghua é um passo interessante para resolver gargalos de computação em LLMs. Será que isso viabiliza data centers mais eficientes? 🤔
![WillieJones]()
La arquitectura PrfaS de Moonshot y Tsinghua parece una gran solución para los cuellos de botella en centros de datos con LLMs. ¡Esperamos ver resultados concretos pronto! 📈
![WillieRamirez]()
Moonshot AI und Tsinghua zeigen mit PrfaS einen vielversprechenden Ansatz gegen Rechenengpässe bei LLMs. Spannend zu sehen, wie diese Kooperation die Datenzukunft gestaltet! 🌐
![MateoAdams]()
대규모 LLM 추론에 필요한 컴퓨팅 파워를 위해 청화대와 Moonshot이 제안한 PrfaS 아키텍처가 흥미롭네요. 데이터 센터 병목 현상을 해결할 열쇠가 될지 주목됩니다! 🚀
![HarryNelson]()
Moonshot AI 和清華大學提出的 PrfaS 架構看起來很有潛力,特別是針對 LLM 推理時的算力瓶頸。不知道實際部署後效能如何,持續關注中!💻✨
Dado que los modelos de lenguaje a gran escala (LLM) requieren una mayor potencia computacional durante el razonamiento, las arquitecturas de servicio convencionales se enfrentan a cuellos de botella. Moonshot AI, en colaboración con un equipo de investigación de la Universidad de Tsinghua, ha presentado una novedosa arquitectura denominada «Pre-filling as a Service» (PrfaaS), destinada a superar las limitaciones de los centros de datos y los recursos informáticos en los servicios de LLM.
El proceso de razonamiento de los modelos de lenguaje a gran escala se divide generalmente en dos fases: el pre-relleno y la decodificación. El pre-relleno requiere un gran esfuerzo computacional, ya que el modelo procesa la entrada y crea una caché de clave-valor (KVCache). La decodificación consume mucho ancho de banda de memoria, ya que genera resultados de forma secuencial. Las configuraciones tradicionales requieren que ambas etapas se desarrollen dentro del mismo centro de datos, lo que genera limitaciones en cuanto a computación y ancho de banda.
PrfaaS permite un servicio eficiente entre centros de datos al descargar las tareas de prellenado a clústeres dedicados de alta potencia computacional, utilizando una red Ethernet estándar para transferir la KVCache generada a los clústeres de decodificación locales. Las investigaciones indican que esta arquitectura potencia el rendimiento del procesamiento, logrando un aumento del 54 % en el rendimiento del servicio con respecto a los modelos tradicionales. Los estudios de casos reales también muestran una menor latencia y una mayor eficiencia.
La arquitectura PrfaaS desacopla los tres subsistemas principales —computación, redes y almacenamiento— y gestiona cada uno de ellos de forma independiente. Un mecanismo de enrutamiento preciso garantiza la transmisión eficiente de solicitudes largas, evitando la congestión derivada de una asignación desigual de recursos, como ocurre en los enfoques tradicionales. Además, un mecanismo de programación de doble escala temporal se adapta a los patrones de tráfico variables, optimizando aún más el uso de los recursos.
A medida que crece la demanda de razonamiento entre centros de datos y sigue surgiendo nuevo hardware, PrfaaS ofrece una solución prometedora para las futuras aplicaciones de IA.








 AliVideo presenta Wan3.0, ofreciendo generación de vídeo ultra largo y consistencia multidimensional
El 24 de agosto, Alibaba presentó Wan3.0, su último modelo de generación de video a gran escala. Este lanzamiento representa un avance importante en la tecnología de video de Alibaba, ofreciendo mejoras significativas en duración, creación universal,
 MiniMax Grandes Modelos Pronuncian Incorrectamente Nombres - Xiyu Technology: Entrenamiento Insuficiente Después de Tokens Específicos
MiniMax publicó recientemente un informe técnico que detalla por qué sus modelos de la serie M2 tuvieron dificultades para generar con precisión nombres específicos como "Ma Jiaqi". Este aparente error destaca una falla sistémica en el entrenamiento
 El acuerdo de Nvidia con China para el H200 sobrevive a la cumbre Trump-Xi, pero no como se esperaba
El presidente Trump viajó a Pekín con Jensen Huang uniéndose a la delegación en el último momento, partiendo dos días después con declaraciones vagas sobre posibles desarrollos en la exportación de chips. No se concretó ningún acuerdo. Desde que Trum

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

Интересная архитектура PrfaS от Moonshot и Цинхуа для решения проблем с вычислительной мощностью LLM. Надеюсь, это поможет оптимизировать центры обработки данных! 🚀
A arquitetura PrfaS proposta por Moonshot e Tsinghua é um passo interessante para resolver gargalos de computação em LLMs. Será que isso viabiliza data centers mais eficientes? 🤔
La arquitectura PrfaS de Moonshot y Tsinghua parece una gran solución para los cuellos de botella en centros de datos con LLMs. ¡Esperamos ver resultados concretos pronto! 📈
Moonshot AI und Tsinghua zeigen mit PrfaS einen vielversprechenden Ansatz gegen Rechenengpässe bei LLMs. Spannend zu sehen, wie diese Kooperation die Datenzukunft gestaltet! 🌐
대규모 LLM 추론에 필요한 컴퓨팅 파워를 위해 청화대와 Moonshot이 제안한 PrfaS 아키텍처가 흥미롭네요. 데이터 센터 병목 현상을 해결할 열쇠가 될지 주목됩니다! 🚀
Moonshot AI 和清華大學提出的 PrfaS 架構看起來很有潛力,特別是針對 LLM 推理時的算力瓶頸。不知道實際部署後效能如何,持續關注中!💻✨












