


 首頁
Moonshot AI 與清華大學為資料中心提出 PrfaaS 架構
由於大型語言模型(LLM)在推理過程中需要更多的運算能力,傳統的服務架構因而面臨瓶頸。 Moonshot AI 與清華大學的研究團隊合作,推出了一種名為「預填充即服務」(Pre-filling as a Service, PrfaaS)的創新架構,旨在克服大型語言模型服務在資料中心與運算資源方面的限制。
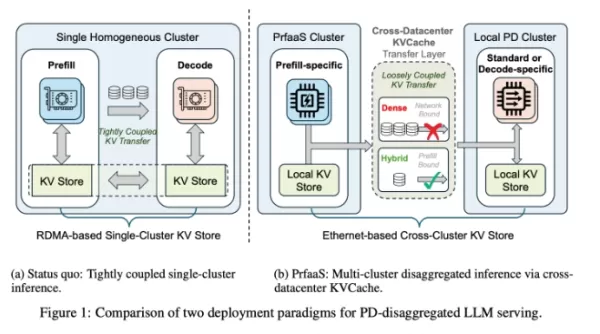
大型語言模型的推理過程通常分為兩個階段:預填充與解碼。預填充階段運算量極大,模型會在此階段處理輸入並建立鍵值快取(KVCache);解碼階段則對記憶體頻寬需求極高,會依序產生輸出結果。 傳統架構要求這兩階段均在同一座資料中心內進行,導致運算與頻寬受到限制。
PrfaaS 透過將預填充任務卸載至專用高運算叢集,並利用標準乙太網路將生成的 KVCache 傳輸至本地解碼叢集,從而實現高效的跨資料中心服務。研究顯示,此架構可提升處理效能,相較於傳統模型,服務吞吐量提高了 54%。 實際案例研究也顯示其延遲更低且效率更高。
PrfaaS 架構將三大子系統——運算、網路與儲存——解耦,並分別獨立管理。精確的路由機制確保長請求能高效傳輸,避免傳統方法中因資源分配不均而導致的擁塞。此外,雙時標排程機制能適應多變的流量模式,進一步優化資源利用率。
隨著跨資料中心推理需求日益增長,且新硬體持續問世,PrfaaS 為未來的人工智慧應用提供了極具前景的解決方案。
相關文章
 阿里影片釋出萬3.0,實現超長影片生成與多維度一致性
8月24日,阿里巴巴釋出了萬3.0,這是其最新的影片生成大模型。此次釋出標誌著阿里巴巴影片技術的重大飛躍,在時長、通用創作、參考處理以及真實世界模擬方面實現了顯著提升。萬3.0將單影片生成的時長擴充套件至30秒,在單個鏡頭內提供了更為豐富的敘事可能性。它還引入了對多種主流檔案格式的支援——包括doc、xls、ppt、pdf和md——使得文字、表格和幻燈片能夠直接轉換為動態視覺內容。為了解決視覺不一致和風格漂移等常見挑戰,萬3.0在微觀層面確保了高度的穩定性。它在角色外觀、道具細節、音訊設定、空間關係
MiniMax大模型誤讀姓名——稀宇科技:特定Token後訓練不足
MiniMax 最近釋出了一份技術報告,詳細解釋了其 M2 系列模型為何難以準確生成“馬嘉祺”等特定名稱。這一看似錯誤的現象凸顯了當前大語言模型訓練中存在的系統性缺陷。Token 偏移:被擠壓的向量空間根本原因在於分詞器(tokenizer),即文字處理的基本單位。例如,名稱“馬嘉祺”被拆分為兩個 Token:“Ma”和“Jiaqi”。雖然模型在預訓練階段學習了這些 Token,但在隨後的指令微調階段出現了問題。在微調期間,Token “Jiaqi”在對話資料中出現的頻率極低,因此幾乎未接受任何
Nvidia H200 在中國的交易雖在川普與習近平峰會後倖存下來,但結果與預期不符
川普總統前往北京,黃仁勳在最後一刻加入代表團,兩天後離京時僅就晶片出口的潛在進展發表了含糊其辭的言論。雙方並未達成任何協議。自川普於2025年12月首次授權銷售以來,尚未有任何一顆Nvidia H200晶片進入中國。 美國貿易代表傑米森·格里爾向《彭博社》證實,半導體限制措施甚至未被列入雙邊議程中討論。在峰會的盛況之下,隱藏著更重大的轉變。H200的供應受阻並非源於華府的拒絕;美國其實早已核准了出
相關專題推薦
設計與藝術
 頂尖 AI 插畫工具:更快地創作編輯畫面與封面插圖
2026 年最新高評分 AI 插畫工具:我們精心挑選的清單收錄了功能強大、設計出色的工具,能助您快速創作出令人驚豔的編輯場景與吸睛的封面藝術。每項選項均經過嚴格的實際測試,並提供免費版與付費版的比較,協助您找到最適合您工作流程的工具。 立即嘗試這些不可錯過的解決方案,釋放您的人工智慧優勢,並提升您的創意生產力。現在就前往 XIX.AI 探索吧。
 10 個工具
 xix.ai
教育與學習
頂尖 AI 補習老師助您備考:練習數學、科學和英語
2026 年最新、評價最高的考試備考 AI 輔導工具,盡在 XIX.AI!我們精心挑選的清單收錄了多款強大且顛覆傳統的工具,提供免費與付費版本的比較、實際測試,以及每週更新的排行榜。這些工具能幫助您提升寫作效率、簡化複雜主題的學習,並釋放您的學術潛能。 立即探索,發掘最適合您的備考工具,並從今天開始創作,釋放您的 AI 優勢!
10 個工具
xix.ai
金融
用於個人財務管理的 AI 預算規劃工具
2026 年最新最佳頂級評分 AI 預算規劃工具,專為個人財務管理打造,現已登陸 XIX.AI!本精選合集收錄了強大且具顛覆性的解決方案,助您開展實際測試、理解消費習慣,並制定個性化計劃以提升生產力。享受免費與付費版的對比及詳細排名。這些必試工具旨在簡化財務管理,助您釋放 AI 優勢。立即探索!
11 個工具
xix.ai
健康與養生
AI 睡眠追蹤助手:透過更佳的睡前習慣提升恢復效果
2026 年最新精選、評價最高的 AI 睡眠追蹤助手,助您獲得最佳恢復效果。這份全面更新的每週指南收錄了強大的工具,提供實際測試報告、免費與付費版本的比較,以及詳細排名,協助您找到必試的解決方案,以提升睡眠品質並培養更好的就寢習慣。 立即造訪 XIX.AI,解鎖您的 AI 優勢。
10 個工具
xix.ai
數據分析
用於產品與營收分析的 AI SQL 協作助手
2026 年最新最佳、評價最高的 AI SQL 輔助工具,專為產品與營收分析打造! XIX.AI 精心甄選了一系列強大且顛覆業界的必試工具,這些工具均經過實戰測試,並透過每週更新的排行榜進行評比。這些工具能透過加速資料分析、簡化複雜查詢,並產生精準洞察來推動更明智的商業決策,從而大幅提升使用者生產力。立即探索,發掘最適合您的工具,釋放您的 AI 優勢!
14 個工具
xix.ai
教育與學習
最佳的「教學型」AI 作業輔助工具:學習概念,而不僅是答案
2026 年最新最佳高評價 AI 作業輔助工具:不僅提供答案,更教授核心概念。專為學生打造的強大工具,必試精選清單,每週更新,免費與付費版本比較,實際測試,精準排名,助您充分發揮學習潛能。立即探索,發掘最適合您的工具,讓學習更聰明。
10 個工具
xix.ai

 評論 (10)
0/500
![JuanJackson]()
Интересная архитектура PrfaS от Moonshot и Цинхуа для решения проблем с вычислительной мощностью LLM. Надеюсь, это поможет оптимизировать центры обработки данных! 🚀
![EricNelson]()
A arquitetura PrfaS proposta por Moonshot e Tsinghua é um passo interessante para resolver gargalos de computação em LLMs. Será que isso viabiliza data centers mais eficientes? 🤔
![WillieJones]()
La arquitectura PrfaS de Moonshot y Tsinghua parece una gran solución para los cuellos de botella en centros de datos con LLMs. ¡Esperamos ver resultados concretos pronto! 📈
![WillieRamirez]()
Moonshot AI und Tsinghua zeigen mit PrfaS einen vielversprechenden Ansatz gegen Rechenengpässe bei LLMs. Spannend zu sehen, wie diese Kooperation die Datenzukunft gestaltet! 🌐
![MateoAdams]()
대규모 LLM 추론에 필요한 컴퓨팅 파워를 위해 청화대와 Moonshot이 제안한 PrfaS 아키텍처가 흥미롭네요. 데이터 센터 병목 현상을 해결할 열쇠가 될지 주목됩니다! 🚀
![HarryNelson]()
Moonshot AI 和清華大學提出的 PrfaS 架構看起來很有潛力,特別是針對 LLM 推理時的算力瓶頸。不知道實際部署後效能如何,持續關注中!💻✨
由於大型語言模型(LLM)在推理過程中需要更多的運算能力,傳統的服務架構因而面臨瓶頸。 Moonshot AI 與清華大學的研究團隊合作,推出了一種名為「預填充即服務」(Pre-filling as a Service, PrfaaS)的創新架構,旨在克服大型語言模型服務在資料中心與運算資源方面的限制。
大型語言模型的推理過程通常分為兩個階段:預填充與解碼。預填充階段運算量極大,模型會在此階段處理輸入並建立鍵值快取(KVCache);解碼階段則對記憶體頻寬需求極高,會依序產生輸出結果。 傳統架構要求這兩階段均在同一座資料中心內進行,導致運算與頻寬受到限制。
PrfaaS 透過將預填充任務卸載至專用高運算叢集,並利用標準乙太網路將生成的 KVCache 傳輸至本地解碼叢集,從而實現高效的跨資料中心服務。研究顯示,此架構可提升處理效能,相較於傳統模型,服務吞吐量提高了 54%。 實際案例研究也顯示其延遲更低且效率更高。
PrfaaS 架構將三大子系統——運算、網路與儲存——解耦,並分別獨立管理。精確的路由機制確保長請求能高效傳輸,避免傳統方法中因資源分配不均而導致的擁塞。此外,雙時標排程機制能適應多變的流量模式,進一步優化資源利用率。
隨著跨資料中心推理需求日益增長,且新硬體持續問世,PrfaaS 為未來的人工智慧應用提供了極具前景的解決方案。








 阿里影片釋出萬3.0,實現超長影片生成與多維度一致性
8月24日,阿里巴巴釋出了萬3.0,這是其最新的影片生成大模型。此次釋出標誌著阿里巴巴影片技術的重大飛躍,在時長、通用創作、參考處理以及真實世界模擬方面實現了顯著提升。萬3.0將單影片生成的時長擴充套件至30秒,在單個鏡頭內提供了更為豐富的敘事可能性。它還引入了對多種主流檔案格式的支援——包括doc、xls、ppt、pdf和md——使得文字、表格和幻燈片能夠直接轉換為動態視覺內容。為了解決視覺不一致和風格漂移等常見挑戰,萬3.0在微觀層面確保了高度的穩定性。它在角色外觀、道具細節、音訊設定、空間關係
 MiniMax大模型誤讀姓名——稀宇科技:特定Token後訓練不足
MiniMax 最近釋出了一份技術報告,詳細解釋了其 M2 系列模型為何難以準確生成“馬嘉祺”等特定名稱。這一看似錯誤的現象凸顯了當前大語言模型訓練中存在的系統性缺陷。Token 偏移:被擠壓的向量空間根本原因在於分詞器(tokenizer),即文字處理的基本單位。例如,名稱“馬嘉祺”被拆分為兩個 Token:“Ma”和“Jiaqi”。雖然模型在預訓練階段學習了這些 Token,但在隨後的指令微調階段出現了問題。在微調期間,Token “Jiaqi”在對話資料中出現的頻率極低,因此幾乎未接受任何
 Nvidia H200 在中國的交易雖在川普與習近平峰會後倖存下來,但結果與預期不符
川普總統前往北京,黃仁勳在最後一刻加入代表團,兩天後離京時僅就晶片出口的潛在進展發表了含糊其辭的言論。雙方並未達成任何協議。自川普於2025年12月首次授權銷售以來,尚未有任何一顆Nvidia H200晶片進入中國。 美國貿易代表傑米森·格里爾向《彭博社》證實,半導體限制措施甚至未被列入雙邊議程中討論。在峰會的盛況之下,隱藏著更重大的轉變。H200的供應受阻並非源於華府的拒絕;美國其實早已核准了出

2026 年最新高評分 AI 插畫工具:我們精心挑選的清單收錄了功能強大、設計出色的工具,能助您快速創作出令人驚豔的編輯場景與吸睛的封面藝術。每項選項均經過嚴格的實際測試,並提供免費版與付費版的比較,協助您找到最適合您工作流程的工具。 立即嘗試這些不可錯過的解決方案,釋放您的人工智慧優勢,並提升您的創意生產力。現在就前往 XIX.AI 探索吧。
10 個工具
xix.ai

2026 年最新、評價最高的考試備考 AI 輔導工具,盡在 XIX.AI!我們精心挑選的清單收錄了多款強大且顛覆傳統的工具,提供免費與付費版本的比較、實際測試,以及每週更新的排行榜。這些工具能幫助您提升寫作效率、簡化複雜主題的學習,並釋放您的學術潛能。 立即探索,發掘最適合您的備考工具,並從今天開始創作,釋放您的 AI 優勢!
10 個工具
xix.ai

2026 年最新最佳頂級評分 AI 預算規劃工具,專為個人財務管理打造,現已登陸 XIX.AI!本精選合集收錄了強大且具顛覆性的解決方案,助您開展實際測試、理解消費習慣,並制定個性化計劃以提升生產力。享受免費與付費版的對比及詳細排名。這些必試工具旨在簡化財務管理,助您釋放 AI 優勢。立即探索!
11 個工具
xix.ai

2026 年最新精選、評價最高的 AI 睡眠追蹤助手,助您獲得最佳恢復效果。這份全面更新的每週指南收錄了強大的工具,提供實際測試報告、免費與付費版本的比較,以及詳細排名,協助您找到必試的解決方案,以提升睡眠品質並培養更好的就寢習慣。 立即造訪 XIX.AI,解鎖您的 AI 優勢。
10 個工具
xix.ai

2026 年最新最佳、評價最高的 AI SQL 輔助工具,專為產品與營收分析打造! XIX.AI 精心甄選了一系列強大且顛覆業界的必試工具,這些工具均經過實戰測試,並透過每週更新的排行榜進行評比。這些工具能透過加速資料分析、簡化複雜查詢,並產生精準洞察來推動更明智的商業決策,從而大幅提升使用者生產力。立即探索,發掘最適合您的工具,釋放您的 AI 優勢!
14 個工具
xix.ai

2026 年最新最佳高評價 AI 作業輔助工具:不僅提供答案,更教授核心概念。專為學生打造的強大工具,必試精選清單,每週更新,免費與付費版本比較,實際測試,精準排名,助您充分發揮學習潛能。立即探索,發掘最適合您的工具,讓學習更聰明。
10 個工具
xix.ai

Интересная архитектура PrfaS от Moonshot и Цинхуа для решения проблем с вычислительной мощностью LLM. Надеюсь, это поможет оптимизировать центры обработки данных! 🚀
A arquitetura PrfaS proposta por Moonshot e Tsinghua é um passo interessante para resolver gargalos de computação em LLMs. Será que isso viabiliza data centers mais eficientes? 🤔
La arquitectura PrfaS de Moonshot y Tsinghua parece una gran solución para los cuellos de botella en centros de datos con LLMs. ¡Esperamos ver resultados concretos pronto! 📈
Moonshot AI und Tsinghua zeigen mit PrfaS einen vielversprechenden Ansatz gegen Rechenengpässe bei LLMs. Spannend zu sehen, wie diese Kooperation die Datenzukunft gestaltet! 🌐
대규모 LLM 추론에 필요한 컴퓨팅 파워를 위해 청화대와 Moonshot이 제안한 PrfaS 아키텍처가 흥미롭네요. 데이터 센터 병목 현상을 해결할 열쇠가 될지 주목됩니다! 🚀
Moonshot AI 和清華大學提出的 PrfaS 架構看起來很有潛力,特別是針對 LLM 推理時的算力瓶頸。不知道實際部署後效能如何,持續關注中!💻✨












