


 首页
Meitun LongCat 推出 LoHoSearch,而 BrowseComp 的得分已跌至 30% 以下
过去一年中,搜索智能体(Search Agent)的能力在很大程度上由 BrowseComp 基准测试所定义。然而,该基准测试正逐渐失去其相关性——它在短短十个月内将模型性能从 30% 提升至 90%,但其价值正在迅速衰减。7 月 17 日,美团旗下 LongCat 推出了更为严格的评估标准 LoHoSearch,旨在重新激发搜索智能体开发领域的实质性进展。
LoHoSearch 的挑战并非人工构建,而是从包含 762 万个实体的维基百科知识图谱中自动生成。由于这些任务是机器生成的,它们达到了人类标注员无法一致复制的搜索空间和结构复杂性的水平。简而言之,之前的基准测试受限于人为设计的上限,而 LoHoSearch 将问题生成委托给知识图谱,从而有效地消除了这一上限。
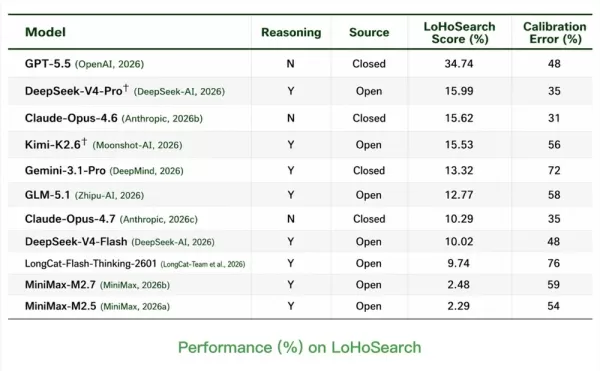
结果令人震惊。在 11 个领先模型中,最高分仅为 34.74%,紧随其后的三个模型得分在 15% 至 16% 之间。相比之下,这些相同的模型在 BrowseComp 上的得分约为 90%。这一差距凸显了当前搜索智能体的真正局限性。值得注意的是,上下文策略的收益递减:在 LoHoSearch 上表现最佳的上下文方法仅使分数提高了 6.8 个百分点,而在 BrowseComp 上则提高了 14 个百分点。这表明,在这个新基准测试下,依靠提示工程和上下文工程来弥补能力差距在很大程度上是无效的。
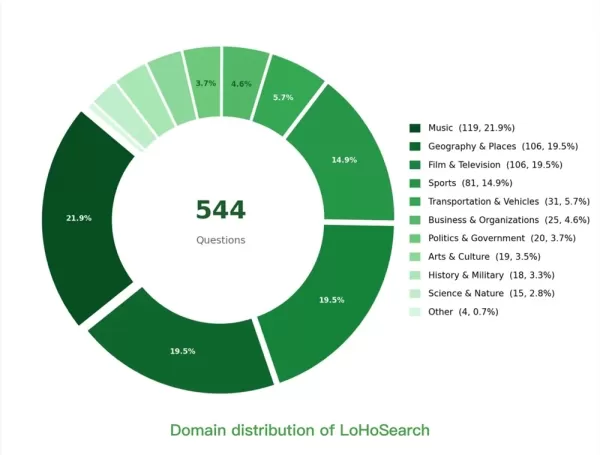
LoHoSearch 包含涵盖 11 个领域的 544 个问题,以树状图和图状图格式呈现,并已开源。随着旧基准测试趋于停滞,搜索智能体的真正挑战才刚刚开始,而 LoHoSearch 可能很快将成为不可或缺的评估标准。
相关文章
 Senspeech X2.5 双星:首个在端侧实现百万级 Token 上下文,完全使用国产算力训练
9月1日,科大讯飞全资子公司思元星火正式推出并开源两款端侧通用大模型:星火X2.5-4B和星火X2.5-1.7B。这两款模型是业界首批原生支持高达100万Token上下文长度的模型,并完全开放模型权重、代码仓库及部署文档。百万级上下文支持,小模型也能“读完一本书”两款模型均采用混合注意力架构,针对智能体、代码、数学及指令遵循等核心能力进行了优化,在同类规模的行业级开源模型中展现出领先的综合性能。在上下文能力方面,星火X2.5-4B和星火X2.5-1.7B基于万亿级Token的高质量数据进行了训练
MiniMax 发布 M3,一款超越 GPT-5.5 的国产 AI 大模型
中国的AI领域迎来了重大技术飞跃,随着稀宇科技(Xiyu Technology)最新大型语言模型MiniMax M3的正式推出。这一先进系统结合了最先进的编码能力,并支持高达100万token的超长上下文窗口。值得注意的是,它原生支持多模态输入,包括图像和视频处理,以及计算机桌面交互,使其成为中国首个整合这三项关键能力的开源模型。标准化基准测试中的卓越表现在严格的SWE-Bench Pro编程评估中,MiniMax M3获得了59.0%的分数,超越了GPT-5.5和Gemini 3.1 Pro,
印度要求来电显示应用程序与电信运营商共享垃圾数据
印度扩大了其反垃圾短信法规,要求来电显示和电话管理应用程序与电信运营商共享用户垃圾报告,这一举措导致知名垃圾阻止应用程序提供商 Truecaller 将该政策标记为反竞争。周五,印度电信监管机构印度电信管理局(TRAI)更新了规范商业通信的规则。这些更新强制要求允许用户将电话标记为垃圾或 junk 的来电 ID 和电话管理应用程序,将这些报告传输到由电信运营商运营的基于区块链的平台。该平台监控商业通信并执行反垃圾协议。根据 TRAI 的说法,这一修改旨在扩大可用于打击垃圾短信发送者的垃圾报告
相关专题推荐
音乐创作
 用于生成歌词与旋律构思的 AI 歌曲创作工具
2026年最新、最优秀、评分最高的用于生成歌词与旋律灵感的AI作曲工具现已在XIX.AI上亮相!这份精心挑选的合集汇集了诸多功能强大且具有颠覆性意义的工具,它们均经过严格的实际应用测试,能够提供精准的歌词与旋律建议。您可以查看免费版本与付费版本的对比信息、详细的排名数据,还能发现那些能显著提升您创作效率的必备工具。立即探索,找到最适合您需求的方案吧!
 8 个工具
 xix.ai
健康养生
ChatGPT 膳食规划应用:用于营养素追踪、购物清单和每周备餐
2026年最新最佳ChatGPT膳食规划应用:经过精心筛选、广受好评、必试的强大工具,可帮助您追踪营养素摄入、管理购物清单并进行每周备餐,彻底改变您的饮食规划方式。XIX.AI基于实际测试结果提供每周更新的排行榜,其中包含免费版与付费版的详细对比信息。立即发现最适合您的工具,提升工作效率,释放AI带来的竞争优势。立即探索!
9 个工具
xix.ai
视频创作
适用于短视频内容的AI视频脚本工具
2026年最新、最佳、评分最高的短视频AI脚本工具!XIX.AI精心甄选了一系列功能强大、颠覆行业的必试工具,这些工具均经过严格的实际测试。 您将看到每周更新的详细排行榜、免费与付费版本的对比信息,以及有助于提升工作效率、在创作高质量短视频内容时发挥AI优势的深度解析。立即探索,找到最适合您的工具!
10 个工具
xix.ai
漫画创作
适用于分镜式叙事的AI漫画分镜工具
2026年最新最佳AI漫画分镜工具,专为分镜式叙事打造!这份精心精选的高评分合集汇集了功能强大、颠覆传统的解决方案,可帮助创作者提升写作效率并突破创作瓶颈。 您将在此找到详尽的免费版与付费版对比分析、实际测试结果以及官方排名,助您做出明智选择。XIX.AI 还提供了专家见解。立即探索,发现能将生动故事呈现得栩栩如生的完美工具!238 个字符
9 个工具
xix.ai
视频创作
最佳用于短视频内容的AI视频生成工具
2026 年最新、最佳、最受好评的 AI 短视频生成工具已上线,收录于 XIX.AI 精选合集。这些强大的变革性工具经过严格的真实世界测试,提供全面的免费与付费对比及详细排名,助您找到完美选项。无论您需要快速制作高质量短视频,还是提升各项任务的生产力,这些必试方案均能带来卓越成果。立即探索,发现您的理想工具,释放 AI 优势。
9 个工具
xix.ai
设计与艺术
最佳 AI 绘画生成工具:探索灵感板、风格及视觉方向
2026年最新最佳AI艺术生成工具排行榜为您呈现了那些评分最高的工具,它们能够帮助您打造令人惊叹的构思板、探索多种不同的风格,并确定视觉创作方向。XIX.AI精心整理了一份包含经过严格实际测试、具备强大功能且能带来颠覆性体验的工具清单。您还可以查看免费版与付费版的对比信息,从而找到最适合提升创意工作流程的工具。立即探索,让AI助力您的艺术创作更上一层楼。
10 个工具
xix.ai

 评论 (0)
0/500
过去一年中,搜索智能体(Search Agent)的能力在很大程度上由 BrowseComp 基准测试所定义。然而,该基准测试正逐渐失去其相关性——它在短短十个月内将模型性能从 30% 提升至 90%,但其价值正在迅速衰减。7 月 17 日,美团旗下 LongCat 推出了更为严格的评估标准 LoHoSearch,旨在重新激发搜索智能体开发领域的实质性进展。
LoHoSearch 的挑战并非人工构建,而是从包含 762 万个实体的维基百科知识图谱中自动生成。由于这些任务是机器生成的,它们达到了人类标注员无法一致复制的搜索空间和结构复杂性的水平。简而言之,之前的基准测试受限于人为设计的上限,而 LoHoSearch 将问题生成委托给知识图谱,从而有效地消除了这一上限。
结果令人震惊。在 11 个领先模型中,最高分仅为 34.74%,紧随其后的三个模型得分在 15% 至 16% 之间。相比之下,这些相同的模型在 BrowseComp 上的得分约为 90%。这一差距凸显了当前搜索智能体的真正局限性。值得注意的是,上下文策略的收益递减:在 LoHoSearch 上表现最佳的上下文方法仅使分数提高了 6.8 个百分点,而在 BrowseComp 上则提高了 14 个百分点。这表明,在这个新基准测试下,依靠提示工程和上下文工程来弥补能力差距在很大程度上是无效的。
LoHoSearch 包含涵盖 11 个领域的 544 个问题,以树状图和图状图格式呈现,并已开源。随着旧基准测试趋于停滞,搜索智能体的真正挑战才刚刚开始,而 LoHoSearch 可能很快将成为不可或缺的评估标准。








 Senspeech X2.5 双星:首个在端侧实现百万级 Token 上下文,完全使用国产算力训练
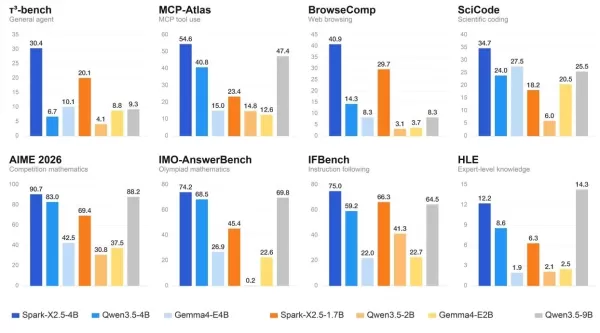
9月1日,科大讯飞全资子公司思元星火正式推出并开源两款端侧通用大模型:星火X2.5-4B和星火X2.5-1.7B。这两款模型是业界首批原生支持高达100万Token上下文长度的模型,并完全开放模型权重、代码仓库及部署文档。百万级上下文支持,小模型也能“读完一本书”两款模型均采用混合注意力架构,针对智能体、代码、数学及指令遵循等核心能力进行了优化,在同类规模的行业级开源模型中展现出领先的综合性能。在上下文能力方面,星火X2.5-4B和星火X2.5-1.7B基于万亿级Token的高质量数据进行了训练
 MiniMax 发布 M3,一款超越 GPT-5.5 的国产 AI 大模型
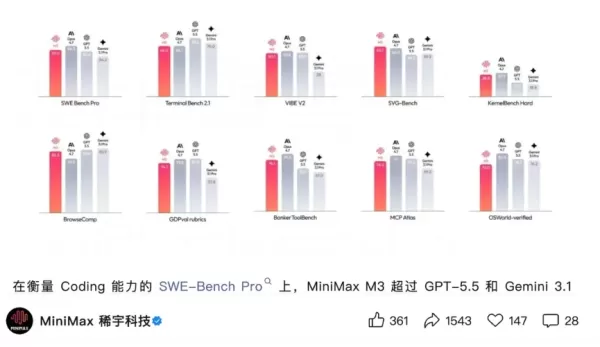
中国的AI领域迎来了重大技术飞跃,随着稀宇科技(Xiyu Technology)最新大型语言模型MiniMax M3的正式推出。这一先进系统结合了最先进的编码能力,并支持高达100万token的超长上下文窗口。值得注意的是,它原生支持多模态输入,包括图像和视频处理,以及计算机桌面交互,使其成为中国首个整合这三项关键能力的开源模型。标准化基准测试中的卓越表现在严格的SWE-Bench Pro编程评估中,MiniMax M3获得了59.0%的分数,超越了GPT-5.5和Gemini 3.1 Pro,
 印度要求来电显示应用程序与电信运营商共享垃圾数据
印度扩大了其反垃圾短信法规,要求来电显示和电话管理应用程序与电信运营商共享用户垃圾报告,这一举措导致知名垃圾阻止应用程序提供商 Truecaller 将该政策标记为反竞争。周五,印度电信监管机构印度电信管理局(TRAI)更新了规范商业通信的规则。这些更新强制要求允许用户将电话标记为垃圾或 junk 的来电 ID 和电话管理应用程序,将这些报告传输到由电信运营商运营的基于区块链的平台。该平台监控商业通信并执行反垃圾协议。根据 TRAI 的说法,这一修改旨在扩大可用于打击垃圾短信发送者的垃圾报告
2026年最新、最优秀、评分最高的用于生成歌词与旋律灵感的AI作曲工具现已在XIX.AI上亮相!这份精心挑选的合集汇集了诸多功能强大且具有颠覆性意义的工具,它们均经过严格的实际应用测试,能够提供精准的歌词与旋律建议。您可以查看免费版本与付费版本的对比信息、详细的排名数据,还能发现那些能显著提升您创作效率的必备工具。立即探索,找到最适合您需求的方案吧!
8 个工具
xix.ai
2026年最新最佳ChatGPT膳食规划应用:经过精心筛选、广受好评、必试的强大工具,可帮助您追踪营养素摄入、管理购物清单并进行每周备餐,彻底改变您的饮食规划方式。XIX.AI基于实际测试结果提供每周更新的排行榜,其中包含免费版与付费版的详细对比信息。立即发现最适合您的工具,提升工作效率,释放AI带来的竞争优势。立即探索!
9 个工具
xix.ai
2026年最新、最佳、评分最高的短视频AI脚本工具!XIX.AI精心甄选了一系列功能强大、颠覆行业的必试工具,这些工具均经过严格的实际测试。 您将看到每周更新的详细排行榜、免费与付费版本的对比信息,以及有助于提升工作效率、在创作高质量短视频内容时发挥AI优势的深度解析。立即探索,找到最适合您的工具!
10 个工具
xix.ai
2026年最新最佳AI漫画分镜工具,专为分镜式叙事打造!这份精心精选的高评分合集汇集了功能强大、颠覆传统的解决方案,可帮助创作者提升写作效率并突破创作瓶颈。 您将在此找到详尽的免费版与付费版对比分析、实际测试结果以及官方排名,助您做出明智选择。XIX.AI 还提供了专家见解。立即探索,发现能将生动故事呈现得栩栩如生的完美工具!238 个字符
9 个工具
xix.ai
2026 年最新、最佳、最受好评的 AI 短视频生成工具已上线,收录于 XIX.AI 精选合集。这些强大的变革性工具经过严格的真实世界测试,提供全面的免费与付费对比及详细排名,助您找到完美选项。无论您需要快速制作高质量短视频,还是提升各项任务的生产力,这些必试方案均能带来卓越成果。立即探索,发现您的理想工具,释放 AI 优势。
9 个工具
xix.ai
2026年最新最佳AI艺术生成工具排行榜为您呈现了那些评分最高的工具,它们能够帮助您打造令人惊叹的构思板、探索多种不同的风格,并确定视觉创作方向。XIX.AI精心整理了一份包含经过严格实际测试、具备强大功能且能带来颠覆性体验的工具清单。您还可以查看免费版与付费版的对比信息,从而找到最适合提升创意工作流程的工具。立即探索,让AI助力您的艺术创作更上一层楼。
10 个工具
xix.ai












