


 Maison
Meitun LongCat lance LoHoSearch alors que les scores de BrowseComp chutent en dessous de 30 %
Les capacités des agents de recherche ont été largement définies par BrowseComp au cours de la dernière année. Pourtant, ce benchmark perd de sa pertinence : il a fait passer les performances des modèles de 30 % à 90 % en seulement dix mois, et sa valeur diminue rapidement. Le 17 juillet, LongCat de Meituan a lancé une évaluation plus rigoureuse, LoHoSearch, conçue pour raviver une progression significative dans le développement des agents de recherche.
Les défis de LoHoSearch ne sont pas conçus manuellement, mais générés automatiquement à partir d’un graphe de connaissances Wikipedia contenant 7,62 millions d’entités. Étant générés par machine, ces tâches atteignent des niveaux d’espace de recherche et de complexité structurelle que les annotateurs humains ne pourraient jamais reproduire de manière cohérente. En bref, tandis que les benchmarks précédents étaient limités par des plafonds conçus par l’humain, LoHoSearch délègue la génération des questions au graphe de connaissances, éliminant ainsi cette limite supérieure.
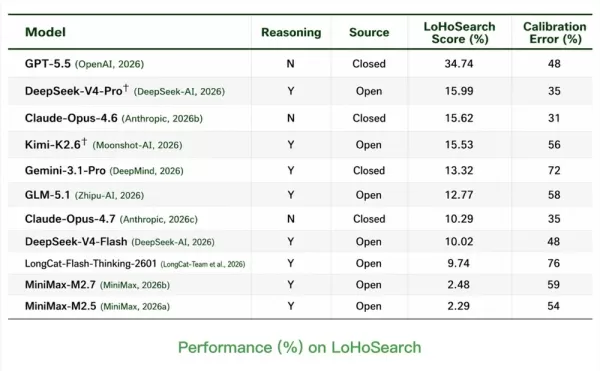
Les résultats sont sans équivoque. Parmi 11 modèles leaders, le score le plus élevé n’a atteint que 34,74 %, les trois suivants se situant entre 15 % et 16 %. En revanche, ces mêmes modèles obtiennent environ 90 % sur BrowseComp. Cet écart met en lumière les véritables limites des agents de recherche actuels. Il est notable que les stratégies contextuelles offrent des rendements décroissants : la meilleure approche contextuelle sur LoHoSearch a amélioré les scores de seulement 6,8 points de pourcentage, contre 14 points de pourcentage sur BrowseComp. Cela suggère que s’appuyer sur l’ingénierie des invites et du contexte pour combler les écarts de capacités est largement inefficace sous ce nouveau benchmark.
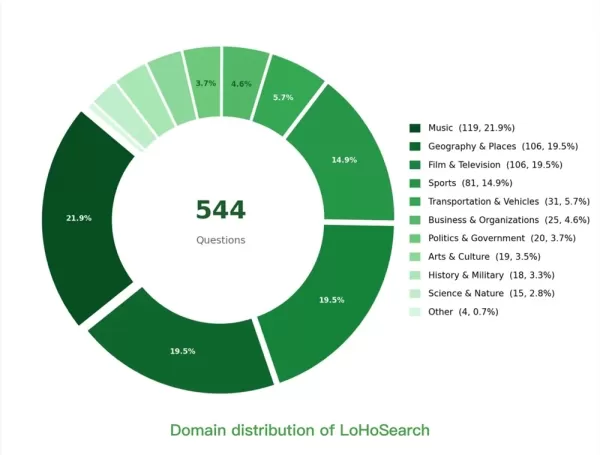
LoHoSearch comprend 544 questions couvrant 11 domaines, structurées sous forme d’arbres et de graphes, et a été open-sourcée. Alors que les anciens benchmarks stagnent, les vrais défis pour les agents de recherche font à peine leur apparition, et LoHoSearch pourrait bientôt devenir une norme d’évaluation essentielle.
Article connexe
 MiniMax dévoile M3, un grand modèle d'IA national qui surpasse GPT-5.5
Le secteur de l'intelligence artificielle en Chine a connu un bond technologique majeur avec le lancement officiel du dernier grand modèle de langage de Xiyu Technology, MiniMax M3. Ce système avancé combine une maîtrise du codage de pointe avec la p
L'Inde oblige les applications d'identification des appels à partager des données sur les appels indésirables avec les opérateurs de télécommunications
L’Inde a élargi sa réglementation anti-spam pour obliger les applications d’identification de l’appelant et de gestion des appels à partager avec les opérateurs de télécommunications les signalements d’abus reçus des utilisateurs, une mesure qui a co
La plateforme Qwen AI élargit sa matrice de modèles avec le lancement officiel de GLM-5.3 et DeepSeek-V4-Pro
La plateforme d’IA Qwen d’Alibaba Cloud (MaaS) a récemment élargi sa matrice de services de modèles, en intégrant le modèle phare GLM-5.3 de Zhipu et la version officielle de DeepSeek-V4-Pro. Les services API correspondants sont désormais accessibles
Recommandations de sujets spéciaux liés
Composition musicale
 Outils d’écriture de chansons par l’IA pour générer des idées de paroles et de mélodie
Les meilleures outils d’écriture de chansons par IA les plus récents et les mieux notés en 2026, destinés à générer des idées de paroles et de mélodies, sont disponibles sur XIX.AI ! Cette sélection rigoureusement choisie propose des solutions puissantes capables de transformer votre travail, ayant été soumises à des tests approfondis dans des conditions réelles afin de fournir des suggestions précises concernant les paroles et les mélodies. Obtenez une comparaison gratuite versus payante, consultez les classements détaillés, et découvrez des outils incontournables qui peuvent améliorer considérablement votre flux de travail créatif. Explorez dès maintenant pour trouver celui qui correspond parfaitement à vos besoins !
 8 outils
 xix.ai
Santé et bien-être
Applications de planification des repas basées sur ChatGPT pour le suivi des macronutriments, les listes de courses et la préparation hebdomadaire
2026 : les meilleures applications ChatGPT pour planifier vos repas. Découvrez les outils les mieux notés, incontournables et puissants, sélectionnés avec soin pour changer la donne en matière de suivi des macronutriments, de listes de courses et de préparation hebdomadaire. XIX.AI propose des classements mis à jour chaque semaine, basés sur des tests en conditions réelles, avec notamment des comparaisons détaillées entre les versions gratuites et payantes. Trouvez dès aujourd’hui l’outil idéal pour booster votre productivité et tirer pleinement parti de l’IA. Découvrez-les dès maintenant !
9 outils
xix.ai
Création vidéo
Outils de création de scripts vidéo basés sur l'IA pour les contenus courts
Les meilleurs outils de création de scripts vidéo basés sur l'IA pour les contenus courts en 2026 ! XIX.AI a sélectionné une gamme d'outils puissants et révolutionnaires, à essayer absolument, qui ont été soumis à des tests rigoureux en conditions réelles. Vous y trouverez des classements détaillés mis à jour chaque semaine, des comparaisons entre versions gratuites et payantes, ainsi que des conseils pour vous aider à booster votre productivité et à tirer pleinement parti de l’IA afin de créer du contenu court de haute qualité. Explorez-la dès maintenant pour découvrir l’outil qui vous convient le mieux !
10 outils
xix.ai
Création de bande dessinée
Outils d'IA pour la création de cases de bande dessinée destinés aux récits de type storyboard
2026 : les meilleurs outils d'IA pour créer des planches de BD, idéaux pour les récits de type storyboard ! Cette sélection triée sur le volet regroupe des solutions puissantes et révolutionnaires qui aident les créateurs à gagner en efficacité dans l'écriture et à surmonter les obstacles à la création. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, des tests en conditions réelles et des classements officiels pour vous guider dans votre choix. XIX.AI propose également des avis d'experts. Explorez-la dès maintenant pour découvrir l'outil idéal qui vous permettra de donner vie à des histoires captivantes ! 238 caractères
9 outils
xix.ai
Création vidéo
Meilleurs outils de génération vidéo par IA pour les contenus courts
2026 Derniers Meilleurs Outils de Génération de Vidéos par IA les mieux notés pour les contenus courts sont ici dans la collection sélectionnée de XIX.AI. Ces outils puissants et révolutionnaires ont été soumis à des tests rigoureux en conditions réelles, avec une comparaison complète entre les versions gratuites et payantes ainsi que des classements détaillés pour vous aider à trouver l’option parfaite. Que vous ayez besoin de créer rapidement des vidéos courtes de haute qualité ou d’améliorer votre productivité sur diverses tâches, ces solutions incontournables offrent des résultats exceptionnels. Explorez dès maintenant pour découvrir l’outil idéal et débloquer votre avantage par l’IA.
9 outils
xix.ai
Conception et art
Meilleurs générateurs d’art par IA : Découvrez des moodboards, des styles et des orientations visuelles
Le classement des meilleurs générateurs d’art IA de 2026 met en lumière les outils les plus appréciés pour créer des moodboards époustouflants, explorer divers styles et définir des directions visuelles. XIX.AI propose une liste sélectionnée d’options puissantes et révolutionnaires ayant réussi des tests rigoureux dans des conditions réelles. Consultez une comparaison gratuite et payante pour trouver celle qui correspond le mieux à vos besoins et améliorer ainsi votre flux de travail créatif. Découvrez dès maintenant comment tirer parti des avantages offerts par l’IA dans la création artistique.
10 outils
xix.ai

 commentaires (0)
Les capacités des agents de recherche ont été largement définies par BrowseComp au cours de la dernière année. Pourtant, ce benchmark perd de sa pertinence : il a fait passer les performances des modèles de 30 % à 90 % en seulement dix mois, et sa valeur diminue rapidement. Le 17 juillet, LongCat de Meituan a lancé une évaluation plus rigoureuse, LoHoSearch, conçue pour raviver une progression significative dans le développement des agents de recherche.
Les défis de LoHoSearch ne sont pas conçus manuellement, mais générés automatiquement à partir d’un graphe de connaissances Wikipedia contenant 7,62 millions d’entités. Étant générés par machine, ces tâches atteignent des niveaux d’espace de recherche et de complexité structurelle que les annotateurs humains ne pourraient jamais reproduire de manière cohérente. En bref, tandis que les benchmarks précédents étaient limités par des plafonds conçus par l’humain, LoHoSearch délègue la génération des questions au graphe de connaissances, éliminant ainsi cette limite supérieure.
Les résultats sont sans équivoque. Parmi 11 modèles leaders, le score le plus élevé n’a atteint que 34,74 %, les trois suivants se situant entre 15 % et 16 %. En revanche, ces mêmes modèles obtiennent environ 90 % sur BrowseComp. Cet écart met en lumière les véritables limites des agents de recherche actuels. Il est notable que les stratégies contextuelles offrent des rendements décroissants : la meilleure approche contextuelle sur LoHoSearch a amélioré les scores de seulement 6,8 points de pourcentage, contre 14 points de pourcentage sur BrowseComp. Cela suggère que s’appuyer sur l’ingénierie des invites et du contexte pour combler les écarts de capacités est largement inefficace sous ce nouveau benchmark.
LoHoSearch comprend 544 questions couvrant 11 domaines, structurées sous forme d’arbres et de graphes, et a été open-sourcée. Alors que les anciens benchmarks stagnent, les vrais défis pour les agents de recherche font à peine leur apparition, et LoHoSearch pourrait bientôt devenir une norme d’évaluation essentielle.








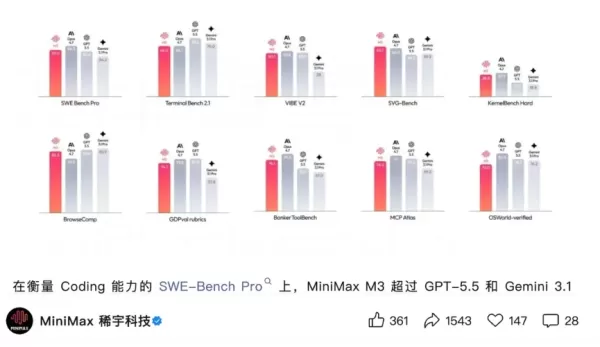 MiniMax dévoile M3, un grand modèle d'IA national qui surpasse GPT-5.5
Le secteur de l'intelligence artificielle en Chine a connu un bond technologique majeur avec le lancement officiel du dernier grand modèle de langage de Xiyu Technology, MiniMax M3. Ce système avancé combine une maîtrise du codage de pointe avec la p
 L'Inde oblige les applications d'identification des appels à partager des données sur les appels indésirables avec les opérateurs de télécommunications
L’Inde a élargi sa réglementation anti-spam pour obliger les applications d’identification de l’appelant et de gestion des appels à partager avec les opérateurs de télécommunications les signalements d’abus reçus des utilisateurs, une mesure qui a co
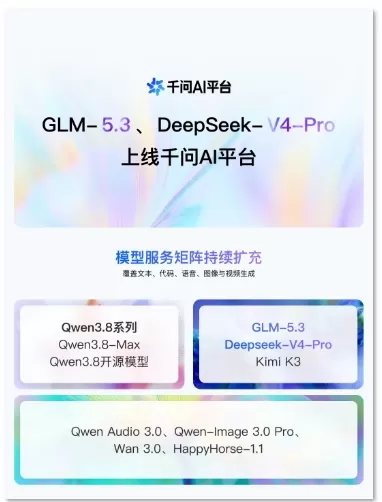 La plateforme Qwen AI élargit sa matrice de modèles avec le lancement officiel de GLM-5.3 et DeepSeek-V4-Pro
La plateforme d’IA Qwen d’Alibaba Cloud (MaaS) a récemment élargi sa matrice de services de modèles, en intégrant le modèle phare GLM-5.3 de Zhipu et la version officielle de DeepSeek-V4-Pro. Les services API correspondants sont désormais accessibles

Les meilleures outils d’écriture de chansons par IA les plus récents et les mieux notés en 2026, destinés à générer des idées de paroles et de mélodies, sont disponibles sur XIX.AI ! Cette sélection rigoureusement choisie propose des solutions puissantes capables de transformer votre travail, ayant été soumises à des tests approfondis dans des conditions réelles afin de fournir des suggestions précises concernant les paroles et les mélodies. Obtenez une comparaison gratuite versus payante, consultez les classements détaillés, et découvrez des outils incontournables qui peuvent améliorer considérablement votre flux de travail créatif. Explorez dès maintenant pour trouver celui qui correspond parfaitement à vos besoins !
8 outils
xix.ai

2026 : les meilleures applications ChatGPT pour planifier vos repas. Découvrez les outils les mieux notés, incontournables et puissants, sélectionnés avec soin pour changer la donne en matière de suivi des macronutriments, de listes de courses et de préparation hebdomadaire. XIX.AI propose des classements mis à jour chaque semaine, basés sur des tests en conditions réelles, avec notamment des comparaisons détaillées entre les versions gratuites et payantes. Trouvez dès aujourd’hui l’outil idéal pour booster votre productivité et tirer pleinement parti de l’IA. Découvrez-les dès maintenant !
9 outils
xix.ai

Les meilleurs outils de création de scripts vidéo basés sur l'IA pour les contenus courts en 2026 ! XIX.AI a sélectionné une gamme d'outils puissants et révolutionnaires, à essayer absolument, qui ont été soumis à des tests rigoureux en conditions réelles. Vous y trouverez des classements détaillés mis à jour chaque semaine, des comparaisons entre versions gratuites et payantes, ainsi que des conseils pour vous aider à booster votre productivité et à tirer pleinement parti de l’IA afin de créer du contenu court de haute qualité. Explorez-la dès maintenant pour découvrir l’outil qui vous convient le mieux !
10 outils
xix.ai

2026 : les meilleurs outils d'IA pour créer des planches de BD, idéaux pour les récits de type storyboard ! Cette sélection triée sur le volet regroupe des solutions puissantes et révolutionnaires qui aident les créateurs à gagner en efficacité dans l'écriture et à surmonter les obstacles à la création. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, des tests en conditions réelles et des classements officiels pour vous guider dans votre choix. XIX.AI propose également des avis d'experts. Explorez-la dès maintenant pour découvrir l'outil idéal qui vous permettra de donner vie à des histoires captivantes ! 238 caractères
9 outils
xix.ai

2026 Derniers Meilleurs Outils de Génération de Vidéos par IA les mieux notés pour les contenus courts sont ici dans la collection sélectionnée de XIX.AI. Ces outils puissants et révolutionnaires ont été soumis à des tests rigoureux en conditions réelles, avec une comparaison complète entre les versions gratuites et payantes ainsi que des classements détaillés pour vous aider à trouver l’option parfaite. Que vous ayez besoin de créer rapidement des vidéos courtes de haute qualité ou d’améliorer votre productivité sur diverses tâches, ces solutions incontournables offrent des résultats exceptionnels. Explorez dès maintenant pour découvrir l’outil idéal et débloquer votre avantage par l’IA.
9 outils
xix.ai

Le classement des meilleurs générateurs d’art IA de 2026 met en lumière les outils les plus appréciés pour créer des moodboards époustouflants, explorer divers styles et définir des directions visuelles. XIX.AI propose une liste sélectionnée d’options puissantes et révolutionnaires ayant réussi des tests rigoureux dans des conditions réelles. Consultez une comparaison gratuite et payante pour trouver celle qui correspond le mieux à vos besoins et améliorer ainsi votre flux de travail créatif. Découvrez dès maintenant comment tirer parti des avantages offerts par l’IA dans la création artistique.
10 outils
xix.ai












