


 Дом
Meitun LongCat запускает LoHoSearch, пока оценки BrowseComp падают ниже 30%
Возможности поисковых агентов в значительной степени определялись benchmarkом BrowseComp на протяжении последнего года. Однако этот тест теряет свою актуальность: он обеспечил рост производительности моделей с 30% до 90% всего за десять месяцев, и его ценность стремительно снижается. 17 июля компания Meituan представила более строгую систему оценки LoHoSearch, разработанную для того, чтобы заново стимулировать значимый прогресс в разработке поисковых агентов.
Задачи LoHoSearch не создаются вручную, а генерируются автоматически на основе графа знаний Wikipedia, содержащего 7,62 миллиона сущностей. Поскольку они создаются машиной, эти задачи достигают такого уровня пространства поиска и структурной сложности, который человеческие аннотаторы не могли бы воспроизвести последовательно. Короче говоря, если предыдущие benchmarkы ограничивались «потолком», заданным человеком, то LoHoSearch делегирует генерацию вопросов графу знаний, эффективно устраняя это верхнее ограничение.
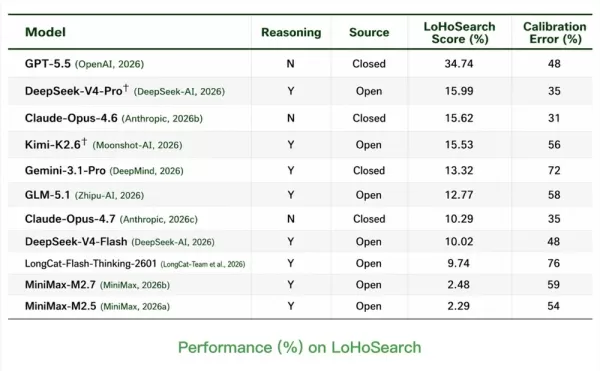
Результаты впечатляют. Среди 11 ведущих моделей максимальный балл составил лишь 34,74%, а следующие три модели набрали от 15% до 16%. Для сравнения, те же самые модели показывают около 90% на BrowseComp. Этот разрыв подчеркивает истинные ограничения современных поисковых агентов. Примечательно, что стратегии контекста дают убывающую отдачу: лучший подход к использованию контекста в LoHoSearch улучшил результаты всего на 6,8 процентных пункта, по сравнению с 14 процентными пунктами на BrowseComp. Это указывает на то, что полагаться на промпты и инженерную настройку контекста для преодоления разрыва в возможностях в основном неэффективно в рамках этого нового benchmarkа.
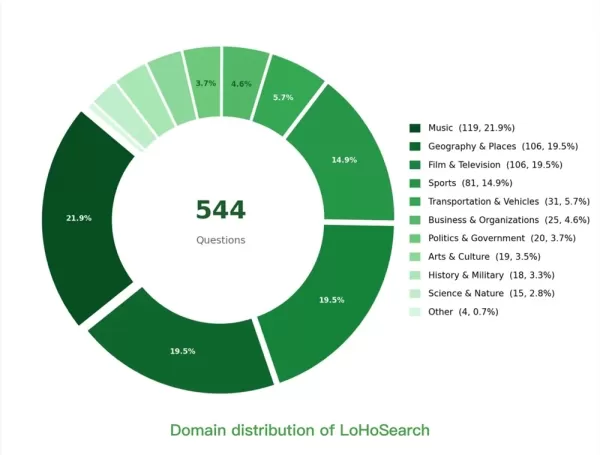
LoHoSearch включает 544 вопроса, охватывающих 11 областей знаний, структурированных в виде дерева и графа, и был опубликован с открытым исходным кодом. По мере того как старые benchmarkы достигают плато, реальные вызовы для поисковых агентов только начинаются, и LoHoSearch может вскоре стать необходимым стандартом оценки.
Связанная статья
 Senspeech X2.5 Twin Stars: первый миллион токенов контекста на периферии, полностью обученный с использованием отечественных вычислительных мощностей
1 сентября wholly-owned дочерняя компания iFLYTEK, Ciyuan Xinghuo, официально запустила и открыла исходный код двух краевых общих больших моделей: Xinghuo X2.5-4B и Xinghuo X2.5-1.7B. Эти модели первыми в своем роде нативно поддерживают длину контекс
MiniMax представляет M3, отечественную большую языковую модель, превосходящую GPT-5.5
В секторе искусственного интеллекта Китая произошел значительный технологический скачок с официальным запуском новейшей большой языковой модели MiniMax M3 от компании Xiyu Technology. Эта передовая система сочетает в себе современные возможности прог
В Индии обязывает приложения для определения номера телефона передавать данные о спаме операторам связи
Индия расширила свои правила борьбы со спамом, обязав приложения для определения номера и управления звонками передавать операторам связи данные о спам-звонках от пользователей. Это решение привело к тому, что Truecaller, известный поставщик приложен
Рекомендации по связанным специальным темам
Музыкальная композиция
 Инструменты для создания песен с помощью ИИ: идеи к текстам и мелодиям
В 2026 году на платформе XIX.AI собраны лучшие и наиболее высоко оценённые инструменты для создания песен с использованием ИИ, предназначенные для поиска идей к текстам и мелодиям. В этот тщательно отобранный набор входят мощные решения, прошедшие строгие тестирования в реальных условиях, которые позволяют давать точные предложения по текстам и мелодиям. Получите бесплатное сравнение бесплатных и платных версий, ознакомьтесь с подробными рейтингами и откройте для себя инструменты, которые значительно улучшат ваш творческий процесс. Исследуйте ассортимент прямо сейчас, чтобы найти оптимальный вариант для ваших нужд!
 8 инструментов
 xix.ai
Здоровье и благополучие
Приложения для планирования питания с ChatGPT: отслеживание макронутриентов, составление списков покупок и еженедельное приготовление еды
2026: Лучшие приложения для планирования питания с ChatGPT — подборка самых популярных и мощных инструментов, которые кардинально изменят ваш подход к отслеживанию макроэлементов, составлению списков покупок и еженедельному приготовлению еды. XIX.AI публикует еженедельно обновляемый рейтинг, основанный на реальных тестах, включая подробное сравнение бесплатных и платных версий. Найдите свой идеальный инструмент для повышения продуктивности и воспользуйтесь преимуществами ИИ уже сегодня. Узнайте больше прямо сейчас!
9 инструментов
xix.ai
Создание видео
Инструменты для создания сценариев видео с использованием ИИ для короткоформатного контента
2026: Лучшие и самые популярные инструменты для создания сценариев видео с помощью ИИ для короткоформатного контента! XIX.AI подготовил подборку мощных, революционных инструментов, которые обязательно стоит попробовать и которые прошли тщательные тесты в реальных условиях. Здесь вы найдете подробные рейтинги, обновляемые еженедельно, сравнение бесплатных и платных версий, а также полезные рекомендации, которые помогут вам повысить продуктивность и использовать преимущества ИИ при создании высококачественного короткометражного контента. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для себя!
10 инструментов
xix.ai
Создание комиксов
Инструменты для создания комикс-панелей с помощью ИИ для повествований в стиле сториборда
2026: лучшие современные инструменты на базе ИИ для создания комикс-панелей в стиле сториборда! В этой тщательно отобранной коллекции представлены мощные революционные решения, которые помогут творцам повысить эффективность написания сценариев и преодолеть творческие препятствия. Здесь вы найдёте подробное сравнение бесплатных и платных версий, результаты реальных тестов и официальные рейтинги, которые помогут вам сделать правильный выбор. XIX.AI также предлагает мнения экспертов. Изучите подборку прямо сейчас, чтобы найти идеальный инструмент для воплощения ярких историй в жизнь! 238 символов
9 инструментов
xix.ai
Создание видео
Лучшие инструменты для создания видео с помощью ИИ для короткого контента
В тщательно подобранной подборке XIX.AI представлены 20 лучших и самых популярных инструментов 2026 года для генерации видео с помощью ИИ, предназначенных для создания короткого контента. Эти мощные, революционные инструменты прошли тщательные тесты в реальных условиях; мы подготовили для вас исчерпывающее сравнение бесплатных и платных версий, а также подробный рейтинг, чтобы помочь вам найти идеальный вариант. Независимо от того, нужно ли вам быстро создавать высококачественные короткие видеоролики или повысить свою продуктивность при выполнении различных задач, эти решения, которые обязательно стоит попробовать, дают выдающиеся результаты. Ознакомьтесь с ними прямо сейчас, чтобы найти свой идеальный инструмент и раскрыть все преимущества ИИ.
9 инструментов
xix.ai
Дизайн и искусство
Лучшие генераторы искусства на основе ИИ: ознакомьтесь с мудбордами, стилями и визуальными направлениями
2026 год: Топ-рейтинг лучших генераторов искусства на основе ИИ показывает самые популярные инструменты для создания впечатляющих мудбордов, исследования разнообразных стилей и формирования визуального направления. XIX.AI предлагает тщательно отобранный список мощных решений, прошедших строгие тестирования в реальных условиях. Получите бесплатное сравнение версий с платными, чтобы выбрать оптимальный вариант для улучшения вашей творческой работы. Ознакомьтесь сейчас, чтобы раскрыть потенциал ИИ в создании произведений искусства.
10 инструментов
xix.ai

 Комментарии (0)
Возможности поисковых агентов в значительной степени определялись benchmarkом BrowseComp на протяжении последнего года. Однако этот тест теряет свою актуальность: он обеспечил рост производительности моделей с 30% до 90% всего за десять месяцев, и его ценность стремительно снижается. 17 июля компания Meituan представила более строгую систему оценки LoHoSearch, разработанную для того, чтобы заново стимулировать значимый прогресс в разработке поисковых агентов.
Задачи LoHoSearch не создаются вручную, а генерируются автоматически на основе графа знаний Wikipedia, содержащего 7,62 миллиона сущностей. Поскольку они создаются машиной, эти задачи достигают такого уровня пространства поиска и структурной сложности, который человеческие аннотаторы не могли бы воспроизвести последовательно. Короче говоря, если предыдущие benchmarkы ограничивались «потолком», заданным человеком, то LoHoSearch делегирует генерацию вопросов графу знаний, эффективно устраняя это верхнее ограничение.
Результаты впечатляют. Среди 11 ведущих моделей максимальный балл составил лишь 34,74%, а следующие три модели набрали от 15% до 16%. Для сравнения, те же самые модели показывают около 90% на BrowseComp. Этот разрыв подчеркивает истинные ограничения современных поисковых агентов. Примечательно, что стратегии контекста дают убывающую отдачу: лучший подход к использованию контекста в LoHoSearch улучшил результаты всего на 6,8 процентных пункта, по сравнению с 14 процентными пунктами на BrowseComp. Это указывает на то, что полагаться на промпты и инженерную настройку контекста для преодоления разрыва в возможностях в основном неэффективно в рамках этого нового benchmarkа.
LoHoSearch включает 544 вопроса, охватывающих 11 областей знаний, структурированных в виде дерева и графа, и был опубликован с открытым исходным кодом. По мере того как старые benchmarkы достигают плато, реальные вызовы для поисковых агентов только начинаются, и LoHoSearch может вскоре стать необходимым стандартом оценки.








 Senspeech X2.5 Twin Stars: первый миллион токенов контекста на периферии, полностью обученный с использованием отечественных вычислительных мощностей
1 сентября wholly-owned дочерняя компания iFLYTEK, Ciyuan Xinghuo, официально запустила и открыла исходный код двух краевых общих больших моделей: Xinghuo X2.5-4B и Xinghuo X2.5-1.7B. Эти модели первыми в своем роде нативно поддерживают длину контекс
 MiniMax представляет M3, отечественную большую языковую модель, превосходящую GPT-5.5
В секторе искусственного интеллекта Китая произошел значительный технологический скачок с официальным запуском новейшей большой языковой модели MiniMax M3 от компании Xiyu Technology. Эта передовая система сочетает в себе современные возможности прог
 В Индии обязывает приложения для определения номера телефона передавать данные о спаме операторам связи
Индия расширила свои правила борьбы со спамом, обязав приложения для определения номера и управления звонками передавать операторам связи данные о спам-звонках от пользователей. Это решение привело к тому, что Truecaller, известный поставщик приложен

В 2026 году на платформе XIX.AI собраны лучшие и наиболее высоко оценённые инструменты для создания песен с использованием ИИ, предназначенные для поиска идей к текстам и мелодиям. В этот тщательно отобранный набор входят мощные решения, прошедшие строгие тестирования в реальных условиях, которые позволяют давать точные предложения по текстам и мелодиям. Получите бесплатное сравнение бесплатных и платных версий, ознакомьтесь с подробными рейтингами и откройте для себя инструменты, которые значительно улучшат ваш творческий процесс. Исследуйте ассортимент прямо сейчас, чтобы найти оптимальный вариант для ваших нужд!
8 инструментов
xix.ai

2026: Лучшие приложения для планирования питания с ChatGPT — подборка самых популярных и мощных инструментов, которые кардинально изменят ваш подход к отслеживанию макроэлементов, составлению списков покупок и еженедельному приготовлению еды. XIX.AI публикует еженедельно обновляемый рейтинг, основанный на реальных тестах, включая подробное сравнение бесплатных и платных версий. Найдите свой идеальный инструмент для повышения продуктивности и воспользуйтесь преимуществами ИИ уже сегодня. Узнайте больше прямо сейчас!
9 инструментов
xix.ai

2026: Лучшие и самые популярные инструменты для создания сценариев видео с помощью ИИ для короткоформатного контента! XIX.AI подготовил подборку мощных, революционных инструментов, которые обязательно стоит попробовать и которые прошли тщательные тесты в реальных условиях. Здесь вы найдете подробные рейтинги, обновляемые еженедельно, сравнение бесплатных и платных версий, а также полезные рекомендации, которые помогут вам повысить продуктивность и использовать преимущества ИИ при создании высококачественного короткометражного контента. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для себя!
10 инструментов
xix.ai

2026: лучшие современные инструменты на базе ИИ для создания комикс-панелей в стиле сториборда! В этой тщательно отобранной коллекции представлены мощные революционные решения, которые помогут творцам повысить эффективность написания сценариев и преодолеть творческие препятствия. Здесь вы найдёте подробное сравнение бесплатных и платных версий, результаты реальных тестов и официальные рейтинги, которые помогут вам сделать правильный выбор. XIX.AI также предлагает мнения экспертов. Изучите подборку прямо сейчас, чтобы найти идеальный инструмент для воплощения ярких историй в жизнь! 238 символов
9 инструментов
xix.ai

В тщательно подобранной подборке XIX.AI представлены 20 лучших и самых популярных инструментов 2026 года для генерации видео с помощью ИИ, предназначенных для создания короткого контента. Эти мощные, революционные инструменты прошли тщательные тесты в реальных условиях; мы подготовили для вас исчерпывающее сравнение бесплатных и платных версий, а также подробный рейтинг, чтобы помочь вам найти идеальный вариант. Независимо от того, нужно ли вам быстро создавать высококачественные короткие видеоролики или повысить свою продуктивность при выполнении различных задач, эти решения, которые обязательно стоит попробовать, дают выдающиеся результаты. Ознакомьтесь с ними прямо сейчас, чтобы найти свой идеальный инструмент и раскрыть все преимущества ИИ.
9 инструментов
xix.ai

2026 год: Топ-рейтинг лучших генераторов искусства на основе ИИ показывает самые популярные инструменты для создания впечатляющих мудбордов, исследования разнообразных стилей и формирования визуального направления. XIX.AI предлагает тщательно отобранный список мощных решений, прошедших строгие тестирования в реальных условиях. Получите бесплатное сравнение версий с платными, чтобы выбрать оптимальный вариант для улучшения вашей творческой работы. Ознакомьтесь сейчас, чтобы раскрыть потенциал ИИ в создании произведений искусства.
10 инструментов
xix.ai












