


 Heim
Meitun LongCat startet LoHoSearch, während die BrowseComp-Werte unter 30 % fallen
Die Fähigkeiten von Search Agents wurden im letzten Jahr maßgeblich durch BrowseComp definiert. Doch dieses Benchmark-Verfahren verliert an Relevanz – es trieb die Modellleistung in nur zehn Monaten von 30 % auf 90 %, und sein Wert schwindet rasch. Am 17. Juli stellte LongCat von Meituan eine strengere Evaluierung vor, LoHoSearch, die darauf abzielt, sinnvolle Fortschritte in der Entwicklung von Search Agents wieder voranzubringen.
Die Herausforderungen von LoHoSearch werden nicht manuell erstellt, sondern automatisch aus einem Wissensgraphen von Wikipedia generiert, der 7,62 Millionen Entitäten enthält. Da diese Aufgaben maschinengeneriert sind, erreichen sie ein Ausmaß an Suchraum und struktureller Komplexität, das menschliche Annotatoren niemals konsistent replizieren könnten. Kurz gesagt: Während frühere Benchmarks durch menschlich festgelegte Obergrenzen begrenzt waren, überlässt LoHoSearch die Generierung der Fragen dem Wissensgraphen und hebt diese Obergrenze effektiv auf.
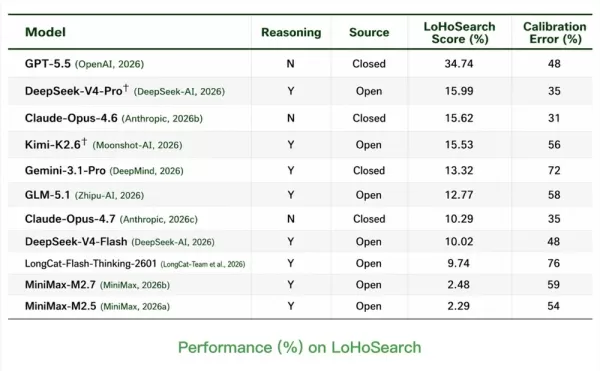
Die Ergebnisse sind drastisch. Unter 11 führenden Modellen erreichte das höchste Ergebnis lediglich 34,74 %, während die nächsten drei Modelle zwischen 15 % und 16 % erzielten. Im Gegensatz dazu erreichen dieselben Modelle auf BrowseComp etwa 90 %. Diese Lücke verdeutlicht die wahren Grenzen aktueller Search Agents. Bemerkenswerterweise bringen Kontextstrategien immer geringere Mehrwerte: Die beste Kontextstrategie auf LoHoSearch verbesserte die Ergebnisse um lediglich 6,8 Prozentpunkte, im Vergleich zu 14 Prozentpunkten auf BrowseComp. Dies deutet darauf hin, dass es weitgehend unwirksam ist, sich unter diesem neuen Benchmark auf Prompting und Kontextengineering zu verlassen, um Fähigkeitslücken zu schließen.
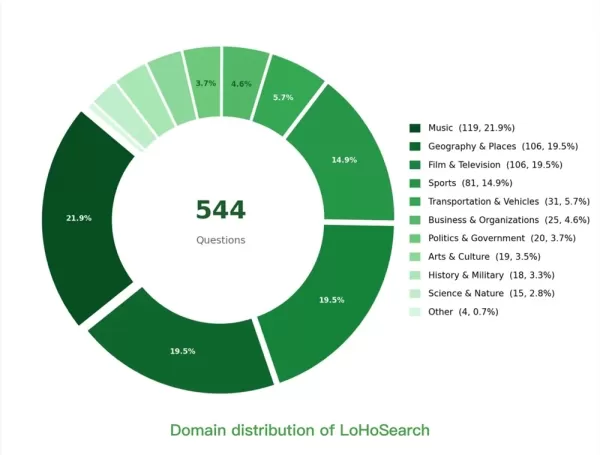
LoHoSearch umfasst 544 Fragen, die 11 Domänen abdecken, in Baum- und Graphformaten strukturiert sind und open-source verfügbar sind. Während ältere Benchmarks ins Stocken geraten, beginnen die echten Herausforderungen für Search Agents erst jetzt, und LoHoSearch wird bald zu einem unverzichtbaren Evaluierungsstandard werden.
Verwandter Artikel
 MiniMax stellt M3 vor, ein inländisches KI-Großmodell, das GPT-5.5 übertrifft.
Chinas KI-Branche hat einen bedeutenden technologischen Sprung vollzogen, mit der offiziellen Einführung des neuesten Large-Language-Modells von Xiyu Technology, MiniMax M3. Dieses fortschrittliche System kombiniert modernste Programmierfähigkeiten m
Indien verpflichtet Caller-ID-Apps zur Weitergabe von Spam-Daten an Telekommunikationsanbieter
Indien hat seine Anti-Spam-Vorschriften erweitert, um vorzuschreiben, dass Caller-ID- und Call-Management-Anwendungen Nutzer-Spamberichte mit Telekommunikationsanbietern teilen, ein Schritt, der dazu geführt hat, dass Truecaller, ein bekannter Anbiet
Qwen-KI-Plattform erweitert Modellmatrix mit offizieller Einführung von GLM-5.3 und DeepSeek-V4-Pro
Die Alibaba Cloud Qwen AI-Plattform (MaaS) hat kürzlich ihre Modellservicematrix erweitert und das Flaggschiff-Großmodell GLM-5.3 von Zhipu sowie die offizielle Veröffentlichung von DeepSeek-V4-Pro integriert. Die entsprechenden API-Dienste sind nun
Empfehlungen zu verwandten Spezialthemen
Musikkomposition
 KI-basierte Songwriting-Tools für Textideen und Melodienkonzepte
Die neuesten, besten und am höchsten bewerteten KI-Tools zum Songwriting für Texte und Melodienideen aus dem Jahr 2026 sind auf XIX.AI erhältlich! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke Lösungen, die durch strenge Tests in der Praxis gegangen sind, um präzise Vorschläge für Texte und Melodien zu liefern. Erhalten Sie einen kostenlosen Vergleich von Kostenlos- und Pay-Versionen, sehen Sie detaillierte Ranglisten sowie Tools, die Ihr kreatives Arbeitsprozess erheblich verbessern können. Entdecken Sie jetzt das perfekte Tool für Ihre Bedürfnisse!
 8 Tools
 xix.ai
Gesundheit Wellness
ChatGPT-Apps zur Essensplanung für die Makro-Erfassung, Einkaufslisten und die wöchentliche Essensvorbereitung
2026 – Die aktuell besten ChatGPT-Apps zur Mahlzeitenplanung: Top-bewertete, unverzichtbare und leistungsstarke Tools, die neue Maßstäbe setzen – für die Makro-Erfassung, Einkaufslisten und die wöchentliche Essensvorbereitung. XIX.AI liefert wöchentlich aktualisierte Rankings auf Basis praktischer Tests, einschließlich eines Vergleichs zwischen kostenlosen und kostenpflichtigen Angeboten. Entdecken Sie noch heute das perfekte Tool, um Ihre Produktivität zu steigern und Ihren KI-Vorteil zu nutzen. Jetzt entdecken!
9 Tools
xix.ai
Videoerstellung
KI-Tools zur Erstellung von Videoskripten für Kurzvideos
Die besten und am besten bewerteten KI-Tools für Videoskripte für Kurzform-Inhalte im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung von Tools zusammengestellt, die Sie unbedingt ausprobieren sollten und die strengen Praxistests durchlaufen haben. Hier finden Sie detaillierte, wöchentlich aktualisierte Rankings, Vergleichsinformationen zu kostenlosen und kostenpflichtigen Angeboten sowie Einblicke, die Ihnen helfen, Ihre Produktivität zu steigern und Ihren KI-Vorteil bei der Erstellung hochwertiger Kurzform-Inhalte zu nutzen. Stöbern Sie jetzt und entdecken Sie Ihr perfektes Tool!
10 Tools
xix.ai
Comic-Erstellung
KI-Tools für Comic-Panels zur Erstellung von Erzählungen im Storyboard-Stil
2026: Die besten neuen KI-Tools für Comic-Panels im Storyboard-Stil! Diese sorgfältig zusammengestellte Sammlung der besten Tools umfasst leistungsstarke, bahnbrechende Lösungen, mit denen Kreative ihre Schreibeffizienz steigern und kreative Engpässe überwinden können. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten, Praxistests und offizielle Rankings, die Ihnen bei der Auswahl helfen. XIX.AI bietet zudem Experteneinblicke. Stöbern Sie jetzt und entdecken Sie Ihr perfektes Tool, um lebendige Geschichten zum Leben zu erwecken! 238 Zeichen
9 Tools
xix.ai
Videoerstellung
Die besten KI-Videoerstellungstools für kurze Inhalte
2026 Neueste Beste Top-bewertete KI-Videoerstellungstools für kurze Inhalte finden Sie hier in XIX.AIs kuratierte Sammlung. Diese leistungsstarken, bahnbrechenden Tools haben strenge Praxistests bestanden und bieten einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Versionen sowie detaillierte Ranglisten, um Ihnen zu helfen, die perfekte Option zu finden. Egal, ob Sie schnell hochwertige Kurzvideos erstellen oder Ihre Produktivität bei verschiedenen Aufgaben steigern möchten – diese empfehlenswerten Lösungen liefern hervorragende Ergebnisse. Entdecken Sie jetzt Ihr ideales Tool und nutzen Sie Ihren KI-Vorteil.
9 Tools
xix.ai
Design & Kunst
Die besten KI-Kunstgeneratoren: Entdecken Sie Moodboards, Stile und visuelle Richtungen
Die neueste Rangliste der besten KI-Kunstgeneratoren von 2026 präsentiert die am höchsten bewerteten Tools zur Erstellung beeindruckender Moodboards, zum Erkunden vielfältiger Stile sowie zur Festlegung visueller Richtungen. XIX.AI bietet eine sorgfältig ausgewählte Liste leistungsstarker, bahnbrechender Optionen, die strenge Prüfungen in der Praxis bestanden haben. Erhalten Sie einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Nutzung, um das optimale Tool für Ihre kreative Arbeitsweise zu finden. Entdecken Sie jetzt, wie Sie Ihren Vorteil in der KI-gestützten Kunstschaffung nutzen können.
10 Tools
xix.ai

 Kommentare (0)
Die Fähigkeiten von Search Agents wurden im letzten Jahr maßgeblich durch BrowseComp definiert. Doch dieses Benchmark-Verfahren verliert an Relevanz – es trieb die Modellleistung in nur zehn Monaten von 30 % auf 90 %, und sein Wert schwindet rasch. Am 17. Juli stellte LongCat von Meituan eine strengere Evaluierung vor, LoHoSearch, die darauf abzielt, sinnvolle Fortschritte in der Entwicklung von Search Agents wieder voranzubringen.
Die Herausforderungen von LoHoSearch werden nicht manuell erstellt, sondern automatisch aus einem Wissensgraphen von Wikipedia generiert, der 7,62 Millionen Entitäten enthält. Da diese Aufgaben maschinengeneriert sind, erreichen sie ein Ausmaß an Suchraum und struktureller Komplexität, das menschliche Annotatoren niemals konsistent replizieren könnten. Kurz gesagt: Während frühere Benchmarks durch menschlich festgelegte Obergrenzen begrenzt waren, überlässt LoHoSearch die Generierung der Fragen dem Wissensgraphen und hebt diese Obergrenze effektiv auf.
Die Ergebnisse sind drastisch. Unter 11 führenden Modellen erreichte das höchste Ergebnis lediglich 34,74 %, während die nächsten drei Modelle zwischen 15 % und 16 % erzielten. Im Gegensatz dazu erreichen dieselben Modelle auf BrowseComp etwa 90 %. Diese Lücke verdeutlicht die wahren Grenzen aktueller Search Agents. Bemerkenswerterweise bringen Kontextstrategien immer geringere Mehrwerte: Die beste Kontextstrategie auf LoHoSearch verbesserte die Ergebnisse um lediglich 6,8 Prozentpunkte, im Vergleich zu 14 Prozentpunkten auf BrowseComp. Dies deutet darauf hin, dass es weitgehend unwirksam ist, sich unter diesem neuen Benchmark auf Prompting und Kontextengineering zu verlassen, um Fähigkeitslücken zu schließen.
LoHoSearch umfasst 544 Fragen, die 11 Domänen abdecken, in Baum- und Graphformaten strukturiert sind und open-source verfügbar sind. Während ältere Benchmarks ins Stocken geraten, beginnen die echten Herausforderungen für Search Agents erst jetzt, und LoHoSearch wird bald zu einem unverzichtbaren Evaluierungsstandard werden.








 MiniMax stellt M3 vor, ein inländisches KI-Großmodell, das GPT-5.5 übertrifft.
Chinas KI-Branche hat einen bedeutenden technologischen Sprung vollzogen, mit der offiziellen Einführung des neuesten Large-Language-Modells von Xiyu Technology, MiniMax M3. Dieses fortschrittliche System kombiniert modernste Programmierfähigkeiten m
 Indien verpflichtet Caller-ID-Apps zur Weitergabe von Spam-Daten an Telekommunikationsanbieter
Indien hat seine Anti-Spam-Vorschriften erweitert, um vorzuschreiben, dass Caller-ID- und Call-Management-Anwendungen Nutzer-Spamberichte mit Telekommunikationsanbietern teilen, ein Schritt, der dazu geführt hat, dass Truecaller, ein bekannter Anbiet
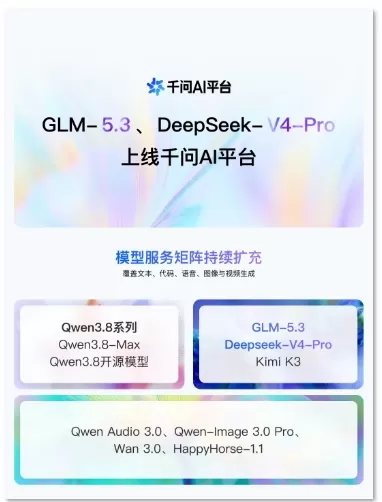 Qwen-KI-Plattform erweitert Modellmatrix mit offizieller Einführung von GLM-5.3 und DeepSeek-V4-Pro
Die Alibaba Cloud Qwen AI-Plattform (MaaS) hat kürzlich ihre Modellservicematrix erweitert und das Flaggschiff-Großmodell GLM-5.3 von Zhipu sowie die offizielle Veröffentlichung von DeepSeek-V4-Pro integriert. Die entsprechenden API-Dienste sind nun

Die neuesten, besten und am höchsten bewerteten KI-Tools zum Songwriting für Texte und Melodienideen aus dem Jahr 2026 sind auf XIX.AI erhältlich! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke Lösungen, die durch strenge Tests in der Praxis gegangen sind, um präzise Vorschläge für Texte und Melodien zu liefern. Erhalten Sie einen kostenlosen Vergleich von Kostenlos- und Pay-Versionen, sehen Sie detaillierte Ranglisten sowie Tools, die Ihr kreatives Arbeitsprozess erheblich verbessern können. Entdecken Sie jetzt das perfekte Tool für Ihre Bedürfnisse!
8 Tools
xix.ai

2026 – Die aktuell besten ChatGPT-Apps zur Mahlzeitenplanung: Top-bewertete, unverzichtbare und leistungsstarke Tools, die neue Maßstäbe setzen – für die Makro-Erfassung, Einkaufslisten und die wöchentliche Essensvorbereitung. XIX.AI liefert wöchentlich aktualisierte Rankings auf Basis praktischer Tests, einschließlich eines Vergleichs zwischen kostenlosen und kostenpflichtigen Angeboten. Entdecken Sie noch heute das perfekte Tool, um Ihre Produktivität zu steigern und Ihren KI-Vorteil zu nutzen. Jetzt entdecken!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Videoskripte für Kurzform-Inhalte im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung von Tools zusammengestellt, die Sie unbedingt ausprobieren sollten und die strengen Praxistests durchlaufen haben. Hier finden Sie detaillierte, wöchentlich aktualisierte Rankings, Vergleichsinformationen zu kostenlosen und kostenpflichtigen Angeboten sowie Einblicke, die Ihnen helfen, Ihre Produktivität zu steigern und Ihren KI-Vorteil bei der Erstellung hochwertiger Kurzform-Inhalte zu nutzen. Stöbern Sie jetzt und entdecken Sie Ihr perfektes Tool!
10 Tools
xix.ai

2026: Die besten neuen KI-Tools für Comic-Panels im Storyboard-Stil! Diese sorgfältig zusammengestellte Sammlung der besten Tools umfasst leistungsstarke, bahnbrechende Lösungen, mit denen Kreative ihre Schreibeffizienz steigern und kreative Engpässe überwinden können. Hier finden Sie detaillierte Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten, Praxistests und offizielle Rankings, die Ihnen bei der Auswahl helfen. XIX.AI bietet zudem Experteneinblicke. Stöbern Sie jetzt und entdecken Sie Ihr perfektes Tool, um lebendige Geschichten zum Leben zu erwecken! 238 Zeichen
9 Tools
xix.ai

2026 Neueste Beste Top-bewertete KI-Videoerstellungstools für kurze Inhalte finden Sie hier in XIX.AIs kuratierte Sammlung. Diese leistungsstarken, bahnbrechenden Tools haben strenge Praxistests bestanden und bieten einen umfassenden Vergleich zwischen kostenlosen und kostenpflichtigen Versionen sowie detaillierte Ranglisten, um Ihnen zu helfen, die perfekte Option zu finden. Egal, ob Sie schnell hochwertige Kurzvideos erstellen oder Ihre Produktivität bei verschiedenen Aufgaben steigern möchten – diese empfehlenswerten Lösungen liefern hervorragende Ergebnisse. Entdecken Sie jetzt Ihr ideales Tool und nutzen Sie Ihren KI-Vorteil.
9 Tools
xix.ai

Die neueste Rangliste der besten KI-Kunstgeneratoren von 2026 präsentiert die am höchsten bewerteten Tools zur Erstellung beeindruckender Moodboards, zum Erkunden vielfältiger Stile sowie zur Festlegung visueller Richtungen. XIX.AI bietet eine sorgfältig ausgewählte Liste leistungsstarker, bahnbrechender Optionen, die strenge Prüfungen in der Praxis bestanden haben. Erhalten Sie einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Nutzung, um das optimale Tool für Ihre kreative Arbeitsweise zu finden. Entdecken Sie jetzt, wie Sie Ihren Vorteil in der KI-gestützten Kunstschaffung nutzen können.
10 Tools
xix.ai












