


 首頁
麻省理工學院推出超越靜態模型的自我學習 AI 架構
麻省理工學院研究人員開創自學人工智能框架
麻省理工學院的研究團隊開發了一套名為 SEAL(Self-Adapting Language Models,自適應語言模型)的創新系統,讓大型語言模型能夠自主進化其能力。這項突破使人工智能系統能夠產生自己的訓練材料和學習協議,允許永久整合新知識和技能。
SEAL 代表了企業級 AI 應用的重大進步,特別是對於在流動環境中運作的智慧型代理人而言,持續適應是非常重要的。此架構解決了目前 LLM 技術中的基本限制 - 即在臨時情境學習之外的永久性知識整合挑戰。
現代人工智能的適應性挑戰
雖然大型語言模型展現出令人印象深刻的能力,但其真正學習和內化新資訊的能力仍然受到限制。目前的適應方法,例如微調或上下文學習,都是被動地處理輸入資料,而沒有針對模型的學習過程進行最佳化。
"麻省理工學院博士生兼論文合著者 Jyo Pari 解釋說:「企業應用需要的不只是暫時的知識回憶,而是深入、持久的適應。「無論是掌握專屬框架的編碼助理,或是學習使用者偏好的客服 AI,這些知識都必須嵌入模型的核心架構中。」
SEAL 架構
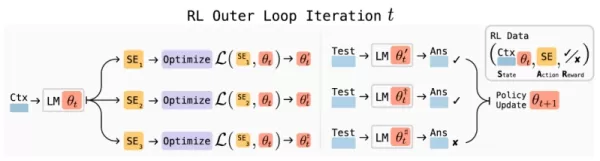
SEAL 架構概觀 (資料來源:arXiv) SEAL 架構引入了一種新穎的強化學習方法,模型會產生「自我編輯」(self-edits),也就是更新自身參數的專門指令。這些編輯可以重組資訊、建立合成訓練範例,甚至定義學習協議,有效地讓模型設計自己的課程。
系統透過雙學習循環來運作:
- 內環:根據自我產生的編輯執行臨時權重更新
- 外環:評估更新的有效性並強化成功的策略
這種持續的自我改進機制將合成資料生成、強化學習和測試時間訓練結合為一個連貫的學習範例。
跨領域的驗證效能
知識整合
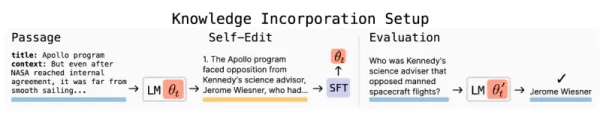
SEAL 知識整合結果 (資料來源:arXiv) 在知識保留測試中,SEAL 增強型模型在不存取原始資料的情況下,回憶段落內容的準確率達到 47%,大幅超越基線微調和 GPT-4.1 產生的合成資料。
少量學習
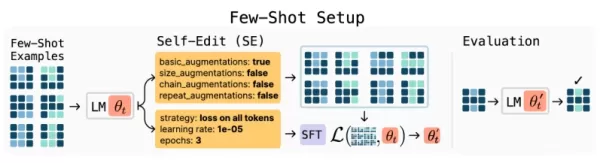
SEAL 快速學習效能 (資料來源:arXiv) 當應用於 ARC 資料集中的抽象推理挑戰時,SEAL 取得 72.5% 的成功率 - 比標準的情境學習方法有顯著的改善。
企業應用
隨著人們對優質訓練資料枯竭的憂慮與日俱增,SEAL 的自我生成學習材料能力提供了一條可持續發展的道路。該技術可讓模型透過迭代式自我解釋,自主加深對研究論文或財務報告等複雜文件的理解。
此架構對於 AI 代理的開發顯示出特殊的前景,可讓系統永久整合來自環境互動的作業知識。與靜態程式設計方法不同,SEAL 驅動的代理可隨著時間演進其能力,同時減少對人為干預的依賴。
目前的限制
SEAL 的實作面臨幾個實際的考量:
- 災難性遺忘:持續的自我編輯有可能會覆蓋先前學到的資訊
- 運算開銷:適應過程需要大量的處理時間
- 需要混合實作:結合 SEAL 與檢索增量生成 (RAG) 可優化記憶體管理
"我們建議企業實施排程更新週期,而非持續適應,」Pari 表示。「這樣可以平衡適應性優點與實際操作限制」。
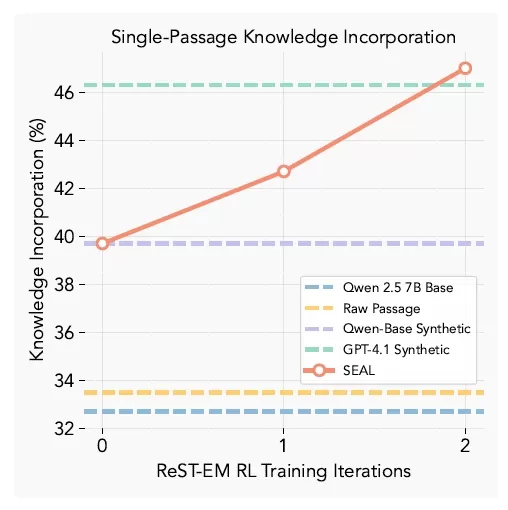
SEAL 的逐步改進(資料來源:arXiv) 這項研究證明,語言模型在經過初始訓練後,不需要保持靜態。透過學習產生和應用自己的更新,它們可以自主擴展知識並適應新的挑戰 - 這種能力可以重新定義企業 AI 的實施。
相關文章
 Base44 推出專有 AI 模型,以增強其 Vibe Coding 平臺的安全性
Base44,這個一年前僅成立六個月、團隊規模僅為八人的初創公司,被Wix以8000萬美元收購,如今已開始部署其專有AI模型,幫助使用者使用自然語言構建應用程式。這一進展正值AI社羣爭論前沿模型是否適用於所有用例,以及依賴外部模型的企業能否保持長期競爭優勢之時。總部位於灣區的Base44的最新戰略旨在解決這兩方面的擔憂。儘管其定製大語言模型(LLM)剛剛推出,Base44的目標是最終超越前沿模型。創始人Maor Shlomo指出,“作為我們整個技術棧的一部分來訓練並擁有該模型,使我們能夠在延遲
拜耳運用 Iambic AI 加速藥物研發
尤爾根·埃克哈特(Juergen Eckhardt)醫學博士,現任拜耳製藥業務發展與授權部門主管。拜耳正透過 Iambic Therapeutics 將前沿人工智慧模型應用於藥物發現,同時在其西班牙工廠推動一項重大的脫碳計畫。拜耳已與科技公司 Iambic Therapeutics 建立戰略採購合作夥伴關係,以加速小分子藥物發現與新藥開發。這家歷史悠久的企業正與合作夥伴攜手,運用其人工智慧驅動的平
Multiverse Computing 推出免費壓縮生成式人工智慧模型
大型語言模型面臨著重大挑戰:其龐大的體積。西班牙新創公司Multiverse Computing正透過開發壓縮模型來解決此問題,旨在彌合尖端AI能力與企業實際可負擔部署方案之間的差距。其核心創新在於「CompactifAI」壓縮技術——這項受量子運算原理啟發的技術,已被這家巴斯克公司用於優化OpenAI的模型。即日起,開發者可在Hugging Face平台免費使用Multiverse增強版的Hyp
相關專題推薦
聊天機器人
 最適合面試練習的 AI 對話訓練工具
2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
 12 個工具
 xix.ai
設計與藝術
最適合進行創意實驗的 AI 風格轉移工具
2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai
漫畫創作
最適合視覺敘事的 AI 對話氣泡工具
2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai
會議助理
頂尖 AI 會議摘要工具:清晰追蹤決策與後續行動
2026 年最新高評價最佳 AI 會議摘要工具,助您清晰追蹤決策並輕鬆進行後續跟進。這份精選清單展示了一系列強大且具顛覆性的解決方案,透過自動化會議記錄、識別關鍵行動項目,以及簡化所有專案的團隊協作,大幅提升生產力。 獲取免費版與付費版的比較分析,搭配實際測試報告及每週更新的排行榜,助您找到最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai
數據分析
最佳人工智慧資料清洗工具:快速處理缺失值與重複資料
2026年最新、最優秀且評分最高的AI資料清洗工具,可快速處理缺失值與重複資料問題。這份精心挑選的清單展示了那些功能強大、能帶來顛覆性變革的解決方案,可顯著提升工作效率。所有候選工具都經過了嚴格的實際應用測試,以確保其穩定性。您可以獲取免費版與付費版的對比資訊,找出最符合您需求的必備工具。即刻訪問XIX.AI,開啟您的AI優勢之旅。
11 個工具
xix.ai
設計與藝術
最佳AI創意構思工具,助力藝術家突破視覺瓶頸
2026 年最新最佳頂級評分 AI 創意構思工具由 XIX.AI 精心策劃,旨在幫助創作者突破視覺瓶頸並即時提升創造力。這些強大的變革性工具提供真實世界測試、詳細的免費與付費對比以及每週更新的排名。發現您的完美工具,加速內容創作,並立即釋放您的 AI 優勢。立即探索!
14 個工具
xix.ai

 評論 (1)
0/500
![FredLee]()
This is a game-changer! Imagine AI that can teach itself new tricks without constant human babysitting. The potential for accelerating research is insane, but I can't help but wonder about the 'off-switch' problem. What happens when it decides it wants to learn something we didn't intend? 🤔 The arms race for self-improving models is officially on.
麻省理工學院研究人員開創自學人工智能框架
麻省理工學院的研究團隊開發了一套名為 SEAL(Self-Adapting Language Models,自適應語言模型)的創新系統,讓大型語言模型能夠自主進化其能力。這項突破使人工智能系統能夠產生自己的訓練材料和學習協議,允許永久整合新知識和技能。
SEAL 代表了企業級 AI 應用的重大進步,特別是對於在流動環境中運作的智慧型代理人而言,持續適應是非常重要的。此架構解決了目前 LLM 技術中的基本限制 - 即在臨時情境學習之外的永久性知識整合挑戰。
現代人工智能的適應性挑戰
雖然大型語言模型展現出令人印象深刻的能力,但其真正學習和內化新資訊的能力仍然受到限制。目前的適應方法,例如微調或上下文學習,都是被動地處理輸入資料,而沒有針對模型的學習過程進行最佳化。
"麻省理工學院博士生兼論文合著者 Jyo Pari 解釋說:「企業應用需要的不只是暫時的知識回憶,而是深入、持久的適應。「無論是掌握專屬框架的編碼助理,或是學習使用者偏好的客服 AI,這些知識都必須嵌入模型的核心架構中。」
SEAL 架構
SEAL 架構引入了一種新穎的強化學習方法,模型會產生「自我編輯」(self-edits),也就是更新自身參數的專門指令。這些編輯可以重組資訊、建立合成訓練範例,甚至定義學習協議,有效地讓模型設計自己的課程。
系統透過雙學習循環來運作:
- 內環:根據自我產生的編輯執行臨時權重更新
- 外環:評估更新的有效性並強化成功的策略
這種持續的自我改進機制將合成資料生成、強化學習和測試時間訓練結合為一個連貫的學習範例。
跨領域的驗證效能
知識整合
在知識保留測試中,SEAL 增強型模型在不存取原始資料的情況下,回憶段落內容的準確率達到 47%,大幅超越基線微調和 GPT-4.1 產生的合成資料。
少量學習
當應用於 ARC 資料集中的抽象推理挑戰時,SEAL 取得 72.5% 的成功率 - 比標準的情境學習方法有顯著的改善。
企業應用
隨著人們對優質訓練資料枯竭的憂慮與日俱增,SEAL 的自我生成學習材料能力提供了一條可持續發展的道路。該技術可讓模型透過迭代式自我解釋,自主加深對研究論文或財務報告等複雜文件的理解。
此架構對於 AI 代理的開發顯示出特殊的前景,可讓系統永久整合來自環境互動的作業知識。與靜態程式設計方法不同,SEAL 驅動的代理可隨著時間演進其能力,同時減少對人為干預的依賴。
目前的限制
SEAL 的實作面臨幾個實際的考量:
- 災難性遺忘:持續的自我編輯有可能會覆蓋先前學到的資訊
- 運算開銷:適應過程需要大量的處理時間
- 需要混合實作:結合 SEAL 與檢索增量生成 (RAG) 可優化記憶體管理
"我們建議企業實施排程更新週期,而非持續適應,」Pari 表示。「這樣可以平衡適應性優點與實際操作限制」。
這項研究證明,語言模型在經過初始訓練後,不需要保持靜態。透過學習產生和應用自己的更新,它們可以自主擴展知識並適應新的挑戰 - 這種能力可以重新定義企業 AI 的實施。








 Base44 推出專有 AI 模型,以增強其 Vibe Coding 平臺的安全性
Base44,這個一年前僅成立六個月、團隊規模僅為八人的初創公司,被Wix以8000萬美元收購,如今已開始部署其專有AI模型,幫助使用者使用自然語言構建應用程式。這一進展正值AI社羣爭論前沿模型是否適用於所有用例,以及依賴外部模型的企業能否保持長期競爭優勢之時。總部位於灣區的Base44的最新戰略旨在解決這兩方面的擔憂。儘管其定製大語言模型(LLM)剛剛推出,Base44的目標是最終超越前沿模型。創始人Maor Shlomo指出,“作為我們整個技術棧的一部分來訓練並擁有該模型,使我們能夠在延遲
 拜耳運用 Iambic AI 加速藥物研發
尤爾根·埃克哈特(Juergen Eckhardt)醫學博士,現任拜耳製藥業務發展與授權部門主管。拜耳正透過 Iambic Therapeutics 將前沿人工智慧模型應用於藥物發現,同時在其西班牙工廠推動一項重大的脫碳計畫。拜耳已與科技公司 Iambic Therapeutics 建立戰略採購合作夥伴關係,以加速小分子藥物發現與新藥開發。這家歷史悠久的企業正與合作夥伴攜手,運用其人工智慧驅動的平
 Multiverse Computing 推出免費壓縮生成式人工智慧模型
大型語言模型面臨著重大挑戰:其龐大的體積。西班牙新創公司Multiverse Computing正透過開發壓縮模型來解決此問題,旨在彌合尖端AI能力與企業實際可負擔部署方案之間的差距。其核心創新在於「CompactifAI」壓縮技術——這項受量子運算原理啟發的技術,已被這家巴斯克公司用於優化OpenAI的模型。即日起,開發者可在Hugging Face平台免費使用Multiverse增強版的Hyp

2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai

2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai

2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai

2026 年最新高評價最佳 AI 會議摘要工具,助您清晰追蹤決策並輕鬆進行後續跟進。這份精選清單展示了一系列強大且具顛覆性的解決方案,透過自動化會議記錄、識別關鍵行動項目,以及簡化所有專案的團隊協作,大幅提升生產力。 獲取免費版與付費版的比較分析,搭配實際測試報告及每週更新的排行榜,助您找到最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai

2026年最新、最優秀且評分最高的AI資料清洗工具,可快速處理缺失值與重複資料問題。這份精心挑選的清單展示了那些功能強大、能帶來顛覆性變革的解決方案,可顯著提升工作效率。所有候選工具都經過了嚴格的實際應用測試,以確保其穩定性。您可以獲取免費版與付費版的對比資訊,找出最符合您需求的必備工具。即刻訪問XIX.AI,開啟您的AI優勢之旅。
11 個工具
xix.ai

2026 年最新最佳頂級評分 AI 創意構思工具由 XIX.AI 精心策劃,旨在幫助創作者突破視覺瓶頸並即時提升創造力。這些強大的變革性工具提供真實世界測試、詳細的免費與付費對比以及每週更新的排名。發現您的完美工具,加速內容創作,並立即釋放您的 AI 優勢。立即探索!
14 個工具
xix.ai

This is a game-changer! Imagine AI that can teach itself new tricks without constant human babysitting. The potential for accelerating research is insane, but I can't help but wonder about the 'off-switch' problem. What happens when it decides it wants to learn something we didn't intend? 🤔 The arms race for self-improving models is officially on.












