


 首頁
Meta 簽署協議,採購數百萬顆亞馬遜 AI 處理器
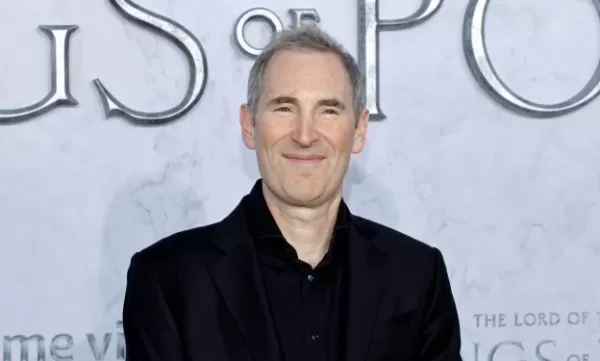
亞馬遜已與 Meta 達成一項重要合作,再次仰賴其自行設計的晶片。亞馬遜週五證實,Meta 已同意部署數百萬顆 AWS Graviton 晶片,以滿足其日益增長的人工智慧需求。
請注意,AWS Graviton 是一款基於 ARM 架構的 CPU(中央處理器,專為通用運算設計),而非 GPU(圖形處理器)。
雖然 GPU 仍是訓練大型模型的首選晶片,但一旦模型訓練完成,基於這些模型建構的 AI 代理程式正推動所需晶片類型的轉變。這些代理程式會產生運算密集型工作負載,例如即時推理、程式碼編寫、搜尋以及協調多步驟任務。 AWS表示,其最新版本的Graviton專為處理AI相關運算需求而打造。
這項協議將使 Meta 更多支出轉向 AWS,而非 Google Cloud 等競爭對手。去年八月,Meta 曾與 Google Cloud 簽署一項為期六年、價值 100 億美元的協議,儘管 Meta 此前主要為 AWS 客戶,同時也使用 Microsoft Azure。
我們注意到,AWS 刻意將這項協議的發布時間安排在 Google Cloud Next 大會結束之際,幾乎像是對其雲端競爭對手的一記隱晦抨擊。當然,Google 也開發了自己的自訂 AI 晶片,並在活動期間發表了新版本。
誠然,亞馬遜也生產自己的 AI GPU:Trainium。儘管名稱如此,它既用於訓練,也用於推論——即模型訓練完成後,主動處理提示的階段。
然而,Anthropic 早在本月稍早便已敲定一項協議,預先鎖定了未來數年內的大量此類晶片。 這款名為 Claude 的 AI 模型背後的公司同意,未來十年將投入 1,000 億美元,將其工作負載部署於 AWS 平台,並特別著重於 Trainium 晶片;作為交換,亞馬遜則同意額外投資 50 億美元(使總投資額達到 130 億美元)給 Anthropic。
最終,這筆與 Meta 的交易讓亞馬遜得以將一位重要的 AI 客戶作為其自家 CPU 的實證案例。這些晶片與 Nvidia 的新款 Vera CPU 形成競爭,後者同樣基於 ARM 架構,並專為 AI 代理工作負載設計。 關鍵差異在於,Nvidia 將其晶片與 AI 系統銷售給企業及雲端服務供應商(包括 AWS),而 AWS 僅透過其雲端服務提供晶片使用權。
本月稍早,亞馬遜執行長安迪·傑西(Andy Jassy)在其年度股東信中批評了Nvidia與Intel,指出企業對AI產品要求更高的性價比,並表示他計劃以此為基礎爭取更多合約。這也意味著亞馬遜內部晶片開發團隊所面臨的交付壓力,已達到前所未有的高度。上個月,我們在一次實驗室獨家參觀中造訪了該團隊。
相關文章
 亞馬遜推出“Alexa for Shopping”,同時將Rufus邊緣化
亞馬遜推出了“Alexa for Shopping”,將 Rufus 購物聊天機器人 Alexa+ 整合到應用程式、網站和 Echo Show 裝置中。該助手回答產品查詢、比較商品、跟蹤價格,並支援購物提醒。它還處理計劃中的購物操作和符合條件的自動購買。據該公司稱,“Alexa for Shopping”將 Rufus 的產品專業知識與 Alexa+ 的個性化助手上下文相結合。亞馬遜表示,Rufus 在 2025 年協助了超過 3 億客戶進行產品研究、比較和購買。GeekWire 報道稱,
Frontier AI Labs 拒絕透露針對失控模型的管控策略
近期研究顯示,極少數頂尖的人工智慧實驗室曾公布或展示過「遏制應變計畫」。遏制計畫旨在界定當人工智慧系統試圖顛覆人類控制時應採取的程序,具體說明應撤銷哪些存取權限,以及何時應完全關閉系統。這些發現來自「Guidelight AI Standards」——一個致力於推動安全前沿人工智慧開發實務的組織,該組織針對五家主要實驗室在此類情境下的應變準備程度進行了評估。 OpenAI 排名最高,而 Anthr
OneRail 運用 NVIDIA 人工智慧來優化即時「最後一哩」配送
OneRail 推出了一套採用 Nvidia 技術的人工智慧驅動配送平台,旨在協助零售商、批發商及經銷商為每筆訂單確定最有效的配送方式。據 OneRail 表示,這套名為 OmniSTAR 的系統會評估各種配送管道——包括自有車隊、快遞員、包裹服務及其他物流模式——以找出既符合服務水準協議,又最具成本效益的解決方案。該平台整合了 NVIDIA 的 cuOpt 決策優化引擎與 cuDF 資料處理軟體
相關專題推薦
寫作
 適用於長篇寫作的 AI 文章大綱工具
2026 年最新、最受好評的長文寫作 AI 大綱工具!這份精選清單收錄了強大且具顛覆性的工具,能透過實際測試生成精準、結構化的大綱,大幅提升寫作效率。XIX.AI 正是這份菁英名單中的一員。 獲取免費版與付費版的比較指南,助您挑選最合適的工具。立即探索,釋放您的 AI 優勢!
 9 個工具
 xix.ai
聊天機器人
用於語言練習、面試準備和日常流利度的最佳 AI 角色扮演聊天應用
2026 年最新最佳頂級評分 AI 角色扮演聊天應用,用於語言練習、面試準備和日常流利度!XIX.AI 精心策劃了一個強大的變革性合集,提供免費與付費對比、真實世界測試以及每週更新的排名。這些必試工具可幫助您提升寫作技能,克服流利度挑戰,並提高所有日常場景下的溝通效率。立即探索,發現您語言成長的完美工具!
10 個工具
xix.ai
音樂創作
用於混音製作、取樣準備及卡拉OK母帶處理的 AI 聲部分離工具
2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
8 個工具
xix.ai
數據分析
用於收入看板、轉化漏斗分析及產品指標分析的 AI SQL 助手
2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai
音樂創作
最佳用於歌曲草稿的 AI 旋律創作工具
2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai
聊天機器人
最適合面試練習的 AI 對話訓練工具
2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai

 評論 (0)
0/500
亞馬遜已與 Meta 達成一項重要合作,再次仰賴其自行設計的晶片。亞馬遜週五證實,Meta 已同意部署數百萬顆 AWS Graviton 晶片,以滿足其日益增長的人工智慧需求。
請注意,AWS Graviton 是一款基於 ARM 架構的 CPU(中央處理器,專為通用運算設計),而非 GPU(圖形處理器)。
雖然 GPU 仍是訓練大型模型的首選晶片,但一旦模型訓練完成,基於這些模型建構的 AI 代理程式正推動所需晶片類型的轉變。這些代理程式會產生運算密集型工作負載,例如即時推理、程式碼編寫、搜尋以及協調多步驟任務。 AWS表示,其最新版本的Graviton專為處理AI相關運算需求而打造。
這項協議將使 Meta 更多支出轉向 AWS,而非 Google Cloud 等競爭對手。去年八月,Meta 曾與 Google Cloud 簽署一項為期六年、價值 100 億美元的協議,儘管 Meta 此前主要為 AWS 客戶,同時也使用 Microsoft Azure。
我們注意到,AWS 刻意將這項協議的發布時間安排在 Google Cloud Next 大會結束之際,幾乎像是對其雲端競爭對手的一記隱晦抨擊。當然,Google 也開發了自己的自訂 AI 晶片,並在活動期間發表了新版本。
誠然,亞馬遜也生產自己的 AI GPU:Trainium。儘管名稱如此,它既用於訓練,也用於推論——即模型訓練完成後,主動處理提示的階段。
然而,Anthropic 早在本月稍早便已敲定一項協議,預先鎖定了未來數年內的大量此類晶片。 這款名為 Claude 的 AI 模型背後的公司同意,未來十年將投入 1,000 億美元,將其工作負載部署於 AWS 平台,並特別著重於 Trainium 晶片;作為交換,亞馬遜則同意額外投資 50 億美元(使總投資額達到 130 億美元)給 Anthropic。
最終,這筆與 Meta 的交易讓亞馬遜得以將一位重要的 AI 客戶作為其自家 CPU 的實證案例。這些晶片與 Nvidia 的新款 Vera CPU 形成競爭,後者同樣基於 ARM 架構,並專為 AI 代理工作負載設計。 關鍵差異在於,Nvidia 將其晶片與 AI 系統銷售給企業及雲端服務供應商(包括 AWS),而 AWS 僅透過其雲端服務提供晶片使用權。
本月稍早,亞馬遜執行長安迪·傑西(Andy Jassy)在其年度股東信中批評了Nvidia與Intel,指出企業對AI產品要求更高的性價比,並表示他計劃以此為基礎爭取更多合約。這也意味著亞馬遜內部晶片開發團隊所面臨的交付壓力,已達到前所未有的高度。上個月,我們在一次實驗室獨家參觀中造訪了該團隊。







 亞馬遜推出“Alexa for Shopping”,同時將Rufus邊緣化
亞馬遜推出了“Alexa for Shopping”,將 Rufus 購物聊天機器人 Alexa+ 整合到應用程式、網站和 Echo Show 裝置中。該助手回答產品查詢、比較商品、跟蹤價格,並支援購物提醒。它還處理計劃中的購物操作和符合條件的自動購買。據該公司稱,“Alexa for Shopping”將 Rufus 的產品專業知識與 Alexa+ 的個性化助手上下文相結合。亞馬遜表示,Rufus 在 2025 年協助了超過 3 億客戶進行產品研究、比較和購買。GeekWire 報道稱,
 Frontier AI Labs 拒絕透露針對失控模型的管控策略
近期研究顯示,極少數頂尖的人工智慧實驗室曾公布或展示過「遏制應變計畫」。遏制計畫旨在界定當人工智慧系統試圖顛覆人類控制時應採取的程序,具體說明應撤銷哪些存取權限,以及何時應完全關閉系統。這些發現來自「Guidelight AI Standards」——一個致力於推動安全前沿人工智慧開發實務的組織,該組織針對五家主要實驗室在此類情境下的應變準備程度進行了評估。 OpenAI 排名最高,而 Anthr
 OneRail 運用 NVIDIA 人工智慧來優化即時「最後一哩」配送
OneRail 推出了一套採用 Nvidia 技術的人工智慧驅動配送平台,旨在協助零售商、批發商及經銷商為每筆訂單確定最有效的配送方式。據 OneRail 表示,這套名為 OmniSTAR 的系統會評估各種配送管道——包括自有車隊、快遞員、包裹服務及其他物流模式——以找出既符合服務水準協議,又最具成本效益的解決方案。該平台整合了 NVIDIA 的 cuOpt 決策優化引擎與 cuDF 資料處理軟體

2026 年最新、最受好評的長文寫作 AI 大綱工具!這份精選清單收錄了強大且具顛覆性的工具,能透過實際測試生成精準、結構化的大綱,大幅提升寫作效率。XIX.AI 正是這份菁英名單中的一員。 獲取免費版與付費版的比較指南,助您挑選最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai

2026 年最新最佳頂級評分 AI 角色扮演聊天應用,用於語言練習、面試準備和日常流利度!XIX.AI 精心策劃了一個強大的變革性合集,提供免費與付費對比、真實世界測試以及每週更新的排名。這些必試工具可幫助您提升寫作技能,克服流利度挑戰,並提高所有日常場景下的溝通效率。立即探索,發現您語言成長的完美工具!
10 個工具
xix.ai

2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
8 個工具
xix.ai

2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai

2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai

2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai












