選項
首頁
新聞
人工智能讀鐘失敗,人類在時間識別測試中表現優異

人工智能讀鐘失敗,人類在時間識別測試中表現優異

2025-10-16
209

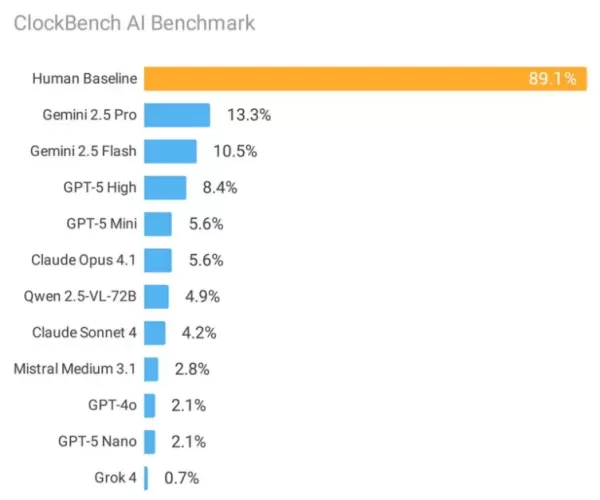
一項具有里程碑意義的評估,比較了 11 種尖端人工智慧系統與人類在閱讀類比鐘錶方面的表現,結果發現目前的機器學習架構存在重大漏洞。當人類參與者在計時上表現出 89.1% 的優異準確度時,即使是 Google 表現最優異的人工智慧模型,在相同的測試條件下也只達到 13.3% 的成功率。

由研究人員 Alek Safar 率先進行的 ClockBench 調查,強調了兒童通常能掌握的基本視覺推理任務,如何持續挑戰最精密的 AI 演算法。這項嚴謹的評估使用 180 個特別製作的類比時鐘設計,檢驗包括 Google、OpenAI 和 Anthropic 等業界領導廠商的平台。

這些發現指出了神經網路如何處理和詮釋視覺資料的深層結構問題。"Safar 在發表的研究中解釋:「準確讀取類比時鐘需要在視覺情境中進行複雜的空間推理。這個多步驟的認知過程包括手部辨識、位置分析和數值轉換,這些操作揭示了人工智能的關鍵缺點。

事實證明,錯誤模式的對比尤其具有啟發性。人類的錯誤通常會造成大約三分鐘的輕微偏差,而 AI 系統則會產生平均 1-3 小時的嚴重不準確估計值,實際上等同於標準時鐘表面的隨機猜測。

關鍵性能限制

人工智能平台在以下方面表現出明顯的困難

  • 羅馬數字時鐘表面(僅達到 3.2% 的精確度)
  • 反向或鏡面時鐘方向
  • 視覺上複雜的背景和藝術設計
  • 精確測量秒針位置

出現了一個很有說服力的觀察:當 AI 系統能夠正確詮釋初始時鐘讀數時,它們隨後就會在以時間為基礎的計算(如轉換和算術)方面表現優異。這顯示主要的障礙在於視覺理解能力,而非數學處理能力。

產業比較分析

Google 的 Gemini 2.5 Pro 以 13.3% 的準確度領先商業產品,Gemini 2.5 Flash 則以 10.5% 的準確度緊隨其後。OpenAI 的 GPT-5 可達到 8.4% 的正確回應,而 Anthropic 的 Claude 模型表現不佳,Claude 4 Sonnet 僅達到 4.2%,Claude 4.1 Opus 則為 5.6%。

xAI 的 Grok 4 的準確率僅為 0.7%,尤其令人擔憂,主要是因為它錯誤地將 63% 的有效時鐘顯示為不可能的時間 - 儘管只有 20.6% 的時鐘實際上有錯誤的配置。
對人工智能發展的基本影響

這項研究延伸了 ARC-AGI 和 SimpleBench 等計畫所示範的「人類-簡單、AI-複雜」基準範例。雖然人工智慧已經在許多以知識為基礎的評估和專業考試中達到超人的表現,但原始的視覺推理仍是持續的挑戰。

Safar 的分析顯示,目前擴大模型大小和訓練資料的方法可能無法有效解決這些視覺處理限制。兩個假設的因素包括:訓練資料庫中類比時鐘的表現不足,以及圖形時鐘元件與文字表達之間空間關係轉換的固有困難。

ClockBench 加入了不斷擴充的診斷工具套件,旨在發現非明顯的 AI 能力缺口。為了維持評估的完整性,整個資料集仍然受到限制,以防止未來的模型訓練受到污染,只有受控制的樣本子集可供驗證。

這些發現提出了一些關鍵問題:現有架構的逐步改進能否彌補這些推理缺陷,或者是否需要根本性的新方法--這反映了其他 AI 領域的創新(例如測試時間計算)所帶來的歷史性突破。

在可預見的未來,機械類比鐘會成為人類智慧出乎意料的穩健基準 - 我們可以輕鬆詮釋的技術,卻持續困擾著我們最先進的計算創造。

相關文章
Google AI 概覽在搜尋結果中佔據一席之地 Google AI 概覽在搜尋結果中佔據一席之地 根據 Similarweb 的《2026 年生成式 AI 發展現況》報告,Google 由 AI 生成的摘要出現在 43% 的美國搜尋結果中,相較於一年前的 15%,呈現顯著增長。雖然「AI 概覽」會在標準搜尋結果中呈現生成的摘要,「AI 模式」則針對複雜查詢及後續提示提供對話式介面。使用者可在不丟失原始搜尋脈絡的情況下,從「AI 概覽」切換至「AI 模式」。Google 解釋,AI 模式採用一種
獲得紅杉資本投資的 Empirik 籌得 2,100 萬美元,用於在服務中斷發生前預先預測 獲得紅杉資本投資的 Empirik 籌得 2,100 萬美元,用於在服務中斷發生前預先預測 在 2020 年加入紅杉資本(Sequoia Capital)擔任首席數位與資訊長之前,艾文·普里(Avon Puri)曾在 Rubrik 和 VMware 負責基礎架構管理長達十餘年。 三年前,當大型語言模型開始展現其真正潛力之際,普里與紅杉資本的另一位 IT 領導者蘇迪爾·杜爾賈蒂(Sudheer Dhurjati)共同意識到,人工智慧能夠協助自主解決基礎架構工程師面臨的一大挑戰——在技術中斷
ElevenLabs 引入 BlackRock、傑米·福克斯和洛琳加作為新投資者 ElevenLabs 引入 BlackRock、傑米·福克斯和洛琳加作為新投資者 ElevenLabs,語音人工智慧領域的領軍企業,宣佈了其5億美元D輪融資的新增參與者,該輪融資最初於2月公佈。目前投資者名單包括黑石集團(BlackRock)、惠靈頓管理公司(Wellington)、D.E. Shaw和施羅德投資(Schroders)等主要機構,以及英偉達(NVIDIA)、Salesforce、桑坦德銀行(Santander)、荷蘭皇家電信(KPN)和德國電信(Deutsche Telekom)等戰略企業支持者。加入本輪融資的知名個人投資者包括演員傑米·福克斯(Jamie F
相關專題推薦
設計與藝術 頂尖 AI 插畫工具:更快地創作編輯畫面與封面插圖
頂尖 AI 插畫工具:更快地創作編輯畫面與封面插圖

2026 年最新高評分 AI 插畫工具:我們精心挑選的清單收錄了功能強大、設計出色的工具,能助您快速創作出令人驚豔的編輯場景與吸睛的封面藝術。每項選項均經過嚴格的實際測試,並提供免費版與付費版的比較,協助您找到最適合您工作流程的工具。 立即嘗試這些不可錯過的解決方案,釋放您的人工智慧優勢,並提升您的創意生產力。現在就前往 XIX.AI 探索吧。

10 個工具
xix.ai
教育與學習 頂尖 AI 補習老師助您備考:練習數學、科學和英語
頂尖 AI 補習老師助您備考:練習數學、科學和英語

2026 年最新、評價最高的考試備考 AI 輔導工具,盡在 XIX.AI!我們精心挑選的清單收錄了多款強大且顛覆傳統的工具,提供免費與付費版本的比較、實際測試,以及每週更新的排行榜。這些工具能幫助您提升寫作效率、簡化複雜主題的學習,並釋放您的學術潛能。 立即探索,發掘最適合您的備考工具,並從今天開始創作,釋放您的 AI 優勢!

10 個工具
xix.ai
金融 用於個人財務管理的 AI 預算規劃工具
用於個人財務管理的 AI 預算規劃工具

2026 年最新最佳頂級評分 AI 預算規劃工具,專為個人財務管理打造,現已登陸 XIX.AI!本精選合集收錄了強大且具顛覆性的解決方案,助您開展實際測試、理解消費習慣,並制定個性化計劃以提升生產力。享受免費與付費版的對比及詳細排名。這些必試工具旨在簡化財務管理,助您釋放 AI 優勢。立即探索!

11 個工具
xix.ai
健康與養生 AI 睡眠追蹤助手:透過更佳的睡前習慣提升恢復效果
AI 睡眠追蹤助手:透過更佳的睡前習慣提升恢復效果

2026 年最新精選、評價最高的 AI 睡眠追蹤助手,助您獲得最佳恢復效果。這份全面更新的每週指南收錄了強大的工具,提供實際測試報告、免費與付費版本的比較,以及詳細排名,協助您找到必試的解決方案,以提升睡眠品質並培養更好的就寢習慣。 立即造訪 XIX.AI,解鎖您的 AI 優勢。

10 個工具
xix.ai
數據分析 用於產品與營收分析的 AI SQL 協作助手
用於產品與營收分析的 AI SQL 協作助手

2026 年最新最佳、評價最高的 AI SQL 輔助工具,專為產品與營收分析打造! XIX.AI 精心甄選了一系列強大且顛覆業界的必試工具,這些工具均經過實戰測試,並透過每週更新的排行榜進行評比。這些工具能透過加速資料分析、簡化複雜查詢,並產生精準洞察來推動更明智的商業決策,從而大幅提升使用者生產力。立即探索,發掘最適合您的工具,釋放您的 AI 優勢!

14 個工具
xix.ai
教育與學習 最佳的「教學型」AI 作業輔助工具:學習概念,而不僅是答案
最佳的「教學型」AI 作業輔助工具:學習概念,而不僅是答案

2026 年最新最佳高評價 AI 作業輔助工具:不僅提供答案,更教授核心概念。專為學生打造的強大工具,必試精選清單,每週更新,免費與付費版本比較,實際測試,精準排名,助您充分發揮學習潛能。立即探索,發掘最適合您的工具,讓學習更聰明。

10 個工具
xix.ai
評論 (2)
0/500
WillieHernández
WillieHernández 2026-10-05 08:00:20

アナログ時計の読み取りでAIが人間に負けるなんて、正直予想外だよね。デジタル化が進む中で、いまだに文字盤の針の角度を正確に解釈するのは機械にとって難しいのか。人間の直感的な処理能力は、まだAIが追いつけない部分があるんだな。技術の進歩は素晴らしいけど、こういう基本的な認知タスクでの差は面白い。

JonathanMiller
JonathanMiller 2026-04-21 12:00:45

Interessant, dass selbst moderne KI bei so simplen Aufgaben wie Uhrenlesen scheitert. Das zeigt, wie spezifisch menschliche Wahrnehmung und Alltagserfahrung sind. Vielleicht sollten wir weniger auf 'Allgemeine' Intelligenz hoffen und mehr auf spezialisierte Tools setzen, die mit Menschen zusammenarbeiten. 🤔

OR