


 首頁
新人工智能模型以 100 倍的速度提升和最少的訓練資料超越 LLM
總部位於新加坡的人工智慧新創公司 Sapient Intelligence 已經設計出一套新穎的人工智慧架構,在複雜的推理挑戰上可媲美大型語言模型 (LLM),而且在某些情境下,還能大幅超越大型語言模型,儘管它所使用的模型規模小得多,所消耗的資料也少得多。
這個被命名為階層推理模型 (Hierarchical Reasoning Model, HRM)的系統,靈感來自於人腦對緩慢、有條理的規劃和快速、直覺的處理所採用的獨立機制。該模型僅使用現代 LLM 所需的一小部分資料和記憶體,就能達到顯著的成果。這樣的效率為企業級 AI 部署帶來了巨大的潛力,因為在企業級 AI 部署中,資料往往是有限的,而且計算能力也受到限制。
思維鏈推理的限制
當面對複雜的任務時,當代的 LLM 大多仰賴於思考鏈 (CoT) 提示,將問題分解為以文字為基礎的中間步驟,有效地強迫模型在尋找答案的過程中,口述其思考過程。
雖然 CoT 增強了 LLM 的推理能力,但它也有一些固有的弱點。在他們的研究論文中,Sapient Intelligence 團隊認為「CoT 只是推理的權宜之計,而非真正的解決方案。它依賴於僵化的、人為決定的分解,其中一個錯誤的步驟或錯誤的順序可能會完全擾亂整個流程"。
這種依賴於產生明確文字的方式,將模型的推理束縛在符記層面上,經常需要龐大的訓練資料集,導致回覆冗長、緩慢。這種方法也忽略了內部發生的「潛在推理」,這些推理並沒有直接用文字表達出來。
研究人員指出:「一種更精簡的方法對於減少這些密集的資料需求是非常重要的。
大腦啟發的層次架構
為了超越 CoT,研究團隊研究了「潛在推理」(latent reasoning),在這種推理中,模型使用其內部抽象的表徵來思考問題,而不是產生有形的「思考標記」(thinking tokens)。這更符合人類的認知;論文提到,「大腦在潛在空間中以顯著的效率維持延伸的邏輯推理鏈,而不需要不斷地將想法轉換回語言。
然而,在人工智能中實現這種深刻的內部推理非常困難。僅僅在深度學習模型中增加層級經常會引發「梯度消失」的問題,即學習信號在各層之間逐漸消失,妨礙了有效的訓練。相反地,迭代計算的循環設計可能會出現「早期收斂」的問題,也就是模型在沒有徹底檢視問題之前,就過早固定在某個解決方案上。
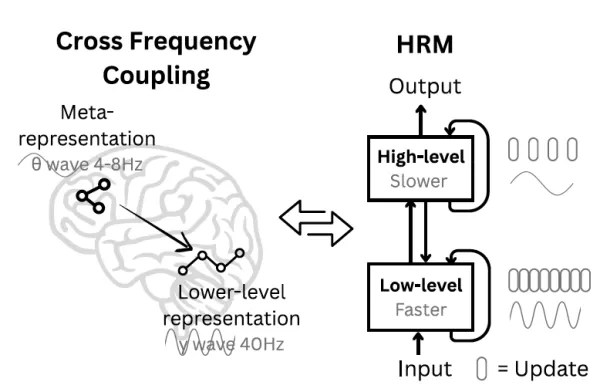
分層推理模型 (HRM) 的靈感來自於大腦結構 資料來源:arXiv 為了尋找更優越的方法,Sapient 團隊向神經科學尋求指引。"研究人員指出:「人腦提出了一個有說服力的模型,可以達到目前人工系統所缺乏的計算深度。"研究人員指出:「人腦的運算結構是分層式的,跨越以不同時間尺度運作的皮層區域,因此能夠進行深層次、多階段的分析。
受此影響,他們創建了 HRM,其中包含兩個相互連繫的循環模組:一個高層次 (H) 模組用於緩慢、抽象的策略制定,另一個低層次 (L) 模組用於快速、詳細的處理。這種安排促進了研究團隊稱為 「層級收斂 」的機制。基本上,快速的 L 模組會處理問題的某一區段,執行數個循環,直到找到穩定的局部答案為止。接著,慢速的 H 模組會整合這個結果、改進其總體計畫,並為 L 模組指派一個新的、定義更明確的子問題。這樣就有效地重新啟動了 L 模組,使其不再停滯不前(早期收斂),並使整個系統能夠使用避免漸層消失的精簡架構,執行一系列延伸的推理階段。
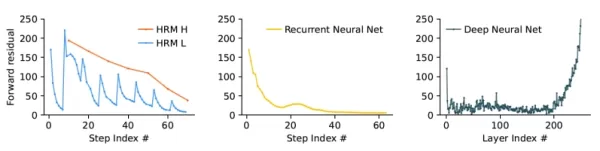
HRM (左) 在不同的計算週期都能順利收斂於解決方案,並避免提早收斂 (中,RNN) 與梯度消失 (右,經典深度神經網路) 資料來源:arXiv 根據這篇論文,「這種機制讓 HRM 能夠執行一連串獨立、穩定的嵌套計算,其中 H 模組引導全局問題解決方法,而 L 模組則執行每個階段的密集搜尋或精煉」。這種巢狀迴圈架構可讓模型在其潛在空間中進行深入分析,而不需要擴展的 CoT 提示或大量資料集。
一個合乎邏輯的顧慮是,這種「潛在推理」是否犧牲了可解釋性。Sapient Intelligence 創辦人兼執行長 Guan Wang 質疑這一觀點,他澄清說,模型的內部運作是可以詮釋和說明的,就像 CoT 提供模型認知的洞察力一樣。他進一步指出,CoT 本身可能不可靠。"CoT 並不能準確代表模型真正的內部推理,」Wang 告知 VentureBeat,並引用研究指出,模型偶爾會以錯誤的推理產生正確的答案,反之亦然。「它在根本上還是不透明的」。
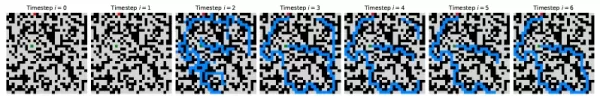
HRM 如何跨不同計算週期推理迷宮問題的範例 資料來源:arXiv 工作中的 HRM
為了評估他們的模型,研究人員將 HRM 與需要密集搜尋與回溯的基準進行比較,例如抽象與推理資料庫(ARC-AGI)、高難度數獨謎題,以及複雜的迷宮導航任務。
研究結果顯示,HRM 學會解決即使是精密的 LLM 也無法解決的問題。例如,在「極限數獨」(Sudoku-Extreme)和「極限迷宮」(Maze-Hard)測試中,頂級 CoT 模型完全失敗,準確率僅為 0%。與此同時,HRM 在每個任務僅訓練 1,000 個範例之後,就達到了幾乎完美的準確度。
在衡量抽象推理和概括能力的 ARC-AGI 基準上,27M 參數的 HRM 達到了 40.3%。這比基於 CoT 的傑出模型,例如更大的 o3-mini-high (34.5%) 和 Claude 3.7 Sonnet (21.2%),還要優勝。這項成就是在沒有龐大的預先訓練資料集和使用最少資料的情況下實現的,強調了其設計的優勢和效率。
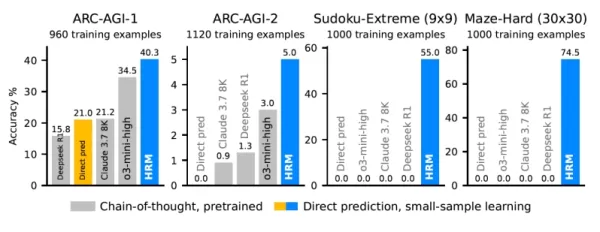
HRM 在複雜推理任務上的表現優於大型模型 資料來源:arXiv 雖然拼圖解決方案展示了模型的能力,但它的實際影響卻出現在不同類別的挑戰中。根據 Wang 的說法,開發人員應該繼續使用 LLM 來處理以語言為中心或具創意的任務,但是對於「複雜或決定性的任務」,HRM 風格的架構可以提供更優異的結果,同時減少幻覺。他強調「需要複雜決策或長期規劃的連續性問題」,尤其是在延遲關鍵領域,例如具體化人工智能與機器人,或是資料稀少的領域,例如科學研究。
在這些情況下,HRM 不僅能找到解決方案,還能學習改善其解決問題的能力。"在我們的大師級數獨測試中隨著訓練的持續,人力資源管理所需的步驟逐漸減少,就像初學者進化為專家一樣,"Wang 闡述道。
對於企業而言,這是架構的效率影響獲利能力的地方。HRM 的並行運算並非如 CoT 般依序、逐個令牌進行,而是讓 Wang 認為「任務完成速度加快了 100 倍」。這可減少推理延遲,並可在邊緣裝置上執行進階推理。
財務效益也相當可觀。"Wang 表示:「相較於大型、昂貴且高延遲的 API 驅動模型,HRM 等專門推理引擎為特定複雜的推理任務提供了更可行的選擇。為了說明效率,他提到專業數獨的模型訓練大約需要 2 個 GPU 小時,而對於要求嚴苛的 ARC-AGI 基準,則需要 50 到 200 個 GPU 小時,這在龐大的基礎模型所需的資源中所佔的比例微乎其微。這創造了一個機會,讓我們可以在資料和資金都受到限制的情況下,解決從物流規劃到複雜系統故障排除等專門的業務問題。
展望未來,Sapient Intelligence 已經開始將 HRM 從利基問題解決工具轉變為更廣泛的通用推理元件。"Wang 表示:「我們正積極建置以 HRM 為基礎的大腦啟發模型。他暗示,這些未來的模型將與目前以文字為基礎的系統大不相同,尤其是透過整合自我修正功能。
這項研究暗示,對於一系列困擾今日人工智慧領導者的問題,未來的出路可能不是更大型的模型,而是更智慧、更有組織的框架,並以最先進的推理系統人腦為藍本。
相關文章
 Base44 推出專有 AI 模型,以增強其 Vibe Coding 平臺的安全性
Base44,這個一年前僅成立六個月、團隊規模僅為八人的初創公司,被Wix以8000萬美元收購,如今已開始部署其專有AI模型,幫助使用者使用自然語言構建應用程式。這一進展正值AI社羣爭論前沿模型是否適用於所有用例,以及依賴外部模型的企業能否保持長期競爭優勢之時。總部位於灣區的Base44的最新戰略旨在解決這兩方面的擔憂。儘管其定製大語言模型(LLM)剛剛推出,Base44的目標是最終超越前沿模型。創始人Maor Shlomo指出,“作為我們整個技術棧的一部分來訓練並擁有該模型,使我們能夠在延遲
金融科技公司如何透過運用數據實現強勁的投資報酬率
建立紮實的整合數據基礎,對於提升金融科技行銷活動的投資報酬率至關重要。圖片來源:Getty ImagesMarketing Evolution 執行長史蒂芬・威廉斯(Stephen Williams)闡述了為何對尋求擴大人工智慧計畫規模,同時實現可量化績效提升的金融科技公司而言,統一數據正是關鍵的缺失環節。威廉斯的工作處於兩股正在重塑金融服務業的主要力量的交匯點:人工智慧技術的飛速發展,以及受監管
拜耳運用 Iambic AI 加速藥物研發
尤爾根·埃克哈特(Juergen Eckhardt)醫學博士,現任拜耳製藥業務發展與授權部門主管。拜耳正透過 Iambic Therapeutics 將前沿人工智慧模型應用於藥物發現,同時在其西班牙工廠推動一項重大的脫碳計畫。拜耳已與科技公司 Iambic Therapeutics 建立戰略採購合作夥伴關係,以加速小分子藥物發現與新藥開發。這家歷史悠久的企業正與合作夥伴攜手,運用其人工智慧驅動的平
相關專題推薦
設計與藝術
 頂尖 AI 插畫工具:更快地創作編輯畫面與封面插圖
2026 年最新高評分 AI 插畫工具:我們精心挑選的清單收錄了功能強大、設計出色的工具,能助您快速創作出令人驚豔的編輯場景與吸睛的封面藝術。每項選項均經過嚴格的實際測試,並提供免費版與付費版的比較,協助您找到最適合您工作流程的工具。 立即嘗試這些不可錯過的解決方案,釋放您的人工智慧優勢,並提升您的創意生產力。現在就前往 XIX.AI 探索吧。
 10 個工具
 xix.ai
教育與學習
頂尖 AI 補習老師助您備考:練習數學、科學和英語
2026 年最新、評價最高的考試備考 AI 輔導工具,盡在 XIX.AI!我們精心挑選的清單收錄了多款強大且顛覆傳統的工具,提供免費與付費版本的比較、實際測試,以及每週更新的排行榜。這些工具能幫助您提升寫作效率、簡化複雜主題的學習,並釋放您的學術潛能。 立即探索,發掘最適合您的備考工具,並從今天開始創作,釋放您的 AI 優勢!
10 個工具
xix.ai
金融
用於個人財務管理的 AI 預算規劃工具
2026 年最新最佳頂級評分 AI 預算規劃工具,專為個人財務管理打造,現已登陸 XIX.AI!本精選合集收錄了強大且具顛覆性的解決方案,助您開展實際測試、理解消費習慣,並制定個性化計劃以提升生產力。享受免費與付費版的對比及詳細排名。這些必試工具旨在簡化財務管理,助您釋放 AI 優勢。立即探索!
11 個工具
xix.ai
健康與養生
AI 睡眠追蹤助手:透過更佳的睡前習慣提升恢復效果
2026 年最新精選、評價最高的 AI 睡眠追蹤助手,助您獲得最佳恢復效果。這份全面更新的每週指南收錄了強大的工具,提供實際測試報告、免費與付費版本的比較,以及詳細排名,協助您找到必試的解決方案,以提升睡眠品質並培養更好的就寢習慣。 立即造訪 XIX.AI,解鎖您的 AI 優勢。
10 個工具
xix.ai
數據分析
用於產品與營收分析的 AI SQL 協作助手
2026 年最新最佳、評價最高的 AI SQL 輔助工具,專為產品與營收分析打造! XIX.AI 精心甄選了一系列強大且顛覆業界的必試工具,這些工具均經過實戰測試,並透過每週更新的排行榜進行評比。這些工具能透過加速資料分析、簡化複雜查詢,並產生精準洞察來推動更明智的商業決策,從而大幅提升使用者生產力。立即探索,發掘最適合您的工具,釋放您的 AI 優勢!
14 個工具
xix.ai
教育與學習
最佳的「教學型」AI 作業輔助工具:學習概念,而不僅是答案
2026 年最新最佳高評價 AI 作業輔助工具:不僅提供答案,更教授核心概念。專為學生打造的強大工具,必試精選清單,每週更新,免費與付費版本比較,實際測試,精準排名,助您充分發揮學習潛能。立即探索,發掘最適合您的工具,讓學習更聰明。
10 個工具
xix.ai

 評論 (0)
0/500
總部位於新加坡的人工智慧新創公司 Sapient Intelligence 已經設計出一套新穎的人工智慧架構,在複雜的推理挑戰上可媲美大型語言模型 (LLM),而且在某些情境下,還能大幅超越大型語言模型,儘管它所使用的模型規模小得多,所消耗的資料也少得多。
這個被命名為階層推理模型 (Hierarchical Reasoning Model, HRM)的系統,靈感來自於人腦對緩慢、有條理的規劃和快速、直覺的處理所採用的獨立機制。該模型僅使用現代 LLM 所需的一小部分資料和記憶體,就能達到顯著的成果。這樣的效率為企業級 AI 部署帶來了巨大的潛力,因為在企業級 AI 部署中,資料往往是有限的,而且計算能力也受到限制。
思維鏈推理的限制
當面對複雜的任務時,當代的 LLM 大多仰賴於思考鏈 (CoT) 提示,將問題分解為以文字為基礎的中間步驟,有效地強迫模型在尋找答案的過程中,口述其思考過程。
雖然 CoT 增強了 LLM 的推理能力,但它也有一些固有的弱點。在他們的研究論文中,Sapient Intelligence 團隊認為「CoT 只是推理的權宜之計,而非真正的解決方案。它依賴於僵化的、人為決定的分解,其中一個錯誤的步驟或錯誤的順序可能會完全擾亂整個流程"。
這種依賴於產生明確文字的方式,將模型的推理束縛在符記層面上,經常需要龐大的訓練資料集,導致回覆冗長、緩慢。這種方法也忽略了內部發生的「潛在推理」,這些推理並沒有直接用文字表達出來。
研究人員指出:「一種更精簡的方法對於減少這些密集的資料需求是非常重要的。
大腦啟發的層次架構
為了超越 CoT,研究團隊研究了「潛在推理」(latent reasoning),在這種推理中,模型使用其內部抽象的表徵來思考問題,而不是產生有形的「思考標記」(thinking tokens)。這更符合人類的認知;論文提到,「大腦在潛在空間中以顯著的效率維持延伸的邏輯推理鏈,而不需要不斷地將想法轉換回語言。
然而,在人工智能中實現這種深刻的內部推理非常困難。僅僅在深度學習模型中增加層級經常會引發「梯度消失」的問題,即學習信號在各層之間逐漸消失,妨礙了有效的訓練。相反地,迭代計算的循環設計可能會出現「早期收斂」的問題,也就是模型在沒有徹底檢視問題之前,就過早固定在某個解決方案上。
為了尋找更優越的方法,Sapient 團隊向神經科學尋求指引。"研究人員指出:「人腦提出了一個有說服力的模型,可以達到目前人工系統所缺乏的計算深度。"研究人員指出:「人腦的運算結構是分層式的,跨越以不同時間尺度運作的皮層區域,因此能夠進行深層次、多階段的分析。
受此影響,他們創建了 HRM,其中包含兩個相互連繫的循環模組:一個高層次 (H) 模組用於緩慢、抽象的策略制定,另一個低層次 (L) 模組用於快速、詳細的處理。這種安排促進了研究團隊稱為 「層級收斂 」的機制。基本上,快速的 L 模組會處理問題的某一區段,執行數個循環,直到找到穩定的局部答案為止。接著,慢速的 H 模組會整合這個結果、改進其總體計畫,並為 L 模組指派一個新的、定義更明確的子問題。這樣就有效地重新啟動了 L 模組,使其不再停滯不前(早期收斂),並使整個系統能夠使用避免漸層消失的精簡架構,執行一系列延伸的推理階段。
根據這篇論文,「這種機制讓 HRM 能夠執行一連串獨立、穩定的嵌套計算,其中 H 模組引導全局問題解決方法,而 L 模組則執行每個階段的密集搜尋或精煉」。這種巢狀迴圈架構可讓模型在其潛在空間中進行深入分析,而不需要擴展的 CoT 提示或大量資料集。
一個合乎邏輯的顧慮是,這種「潛在推理」是否犧牲了可解釋性。Sapient Intelligence 創辦人兼執行長 Guan Wang 質疑這一觀點,他澄清說,模型的內部運作是可以詮釋和說明的,就像 CoT 提供模型認知的洞察力一樣。他進一步指出,CoT 本身可能不可靠。"CoT 並不能準確代表模型真正的內部推理,」Wang 告知 VentureBeat,並引用研究指出,模型偶爾會以錯誤的推理產生正確的答案,反之亦然。「它在根本上還是不透明的」。
工作中的 HRM
為了評估他們的模型,研究人員將 HRM 與需要密集搜尋與回溯的基準進行比較,例如抽象與推理資料庫(ARC-AGI)、高難度數獨謎題,以及複雜的迷宮導航任務。
研究結果顯示,HRM 學會解決即使是精密的 LLM 也無法解決的問題。例如,在「極限數獨」(Sudoku-Extreme)和「極限迷宮」(Maze-Hard)測試中,頂級 CoT 模型完全失敗,準確率僅為 0%。與此同時,HRM 在每個任務僅訓練 1,000 個範例之後,就達到了幾乎完美的準確度。
在衡量抽象推理和概括能力的 ARC-AGI 基準上,27M 參數的 HRM 達到了 40.3%。這比基於 CoT 的傑出模型,例如更大的 o3-mini-high (34.5%) 和 Claude 3.7 Sonnet (21.2%),還要優勝。這項成就是在沒有龐大的預先訓練資料集和使用最少資料的情況下實現的,強調了其設計的優勢和效率。
雖然拼圖解決方案展示了模型的能力,但它的實際影響卻出現在不同類別的挑戰中。根據 Wang 的說法,開發人員應該繼續使用 LLM 來處理以語言為中心或具創意的任務,但是對於「複雜或決定性的任務」,HRM 風格的架構可以提供更優異的結果,同時減少幻覺。他強調「需要複雜決策或長期規劃的連續性問題」,尤其是在延遲關鍵領域,例如具體化人工智能與機器人,或是資料稀少的領域,例如科學研究。
在這些情況下,HRM 不僅能找到解決方案,還能學習改善其解決問題的能力。"在我們的大師級數獨測試中隨著訓練的持續,人力資源管理所需的步驟逐漸減少,就像初學者進化為專家一樣,"Wang 闡述道。
對於企業而言,這是架構的效率影響獲利能力的地方。HRM 的並行運算並非如 CoT 般依序、逐個令牌進行,而是讓 Wang 認為「任務完成速度加快了 100 倍」。這可減少推理延遲,並可在邊緣裝置上執行進階推理。
財務效益也相當可觀。"Wang 表示:「相較於大型、昂貴且高延遲的 API 驅動模型,HRM 等專門推理引擎為特定複雜的推理任務提供了更可行的選擇。為了說明效率,他提到專業數獨的模型訓練大約需要 2 個 GPU 小時,而對於要求嚴苛的 ARC-AGI 基準,則需要 50 到 200 個 GPU 小時,這在龐大的基礎模型所需的資源中所佔的比例微乎其微。這創造了一個機會,讓我們可以在資料和資金都受到限制的情況下,解決從物流規劃到複雜系統故障排除等專門的業務問題。
展望未來,Sapient Intelligence 已經開始將 HRM 從利基問題解決工具轉變為更廣泛的通用推理元件。"Wang 表示:「我們正積極建置以 HRM 為基礎的大腦啟發模型。他暗示,這些未來的模型將與目前以文字為基礎的系統大不相同,尤其是透過整合自我修正功能。
這項研究暗示,對於一系列困擾今日人工智慧領導者的問題,未來的出路可能不是更大型的模型,而是更智慧、更有組織的框架,並以最先進的推理系統人腦為藍本。








 Base44 推出專有 AI 模型,以增強其 Vibe Coding 平臺的安全性
Base44,這個一年前僅成立六個月、團隊規模僅為八人的初創公司,被Wix以8000萬美元收購,如今已開始部署其專有AI模型,幫助使用者使用自然語言構建應用程式。這一進展正值AI社羣爭論前沿模型是否適用於所有用例,以及依賴外部模型的企業能否保持長期競爭優勢之時。總部位於灣區的Base44的最新戰略旨在解決這兩方面的擔憂。儘管其定製大語言模型(LLM)剛剛推出,Base44的目標是最終超越前沿模型。創始人Maor Shlomo指出,“作為我們整個技術棧的一部分來訓練並擁有該模型,使我們能夠在延遲
 金融科技公司如何透過運用數據實現強勁的投資報酬率
建立紮實的整合數據基礎,對於提升金融科技行銷活動的投資報酬率至關重要。圖片來源:Getty ImagesMarketing Evolution 執行長史蒂芬・威廉斯(Stephen Williams)闡述了為何對尋求擴大人工智慧計畫規模,同時實現可量化績效提升的金融科技公司而言,統一數據正是關鍵的缺失環節。威廉斯的工作處於兩股正在重塑金融服務業的主要力量的交匯點:人工智慧技術的飛速發展,以及受監管
 拜耳運用 Iambic AI 加速藥物研發
尤爾根·埃克哈特(Juergen Eckhardt)醫學博士,現任拜耳製藥業務發展與授權部門主管。拜耳正透過 Iambic Therapeutics 將前沿人工智慧模型應用於藥物發現,同時在其西班牙工廠推動一項重大的脫碳計畫。拜耳已與科技公司 Iambic Therapeutics 建立戰略採購合作夥伴關係,以加速小分子藥物發現與新藥開發。這家歷史悠久的企業正與合作夥伴攜手,運用其人工智慧驅動的平

2026 年最新高評分 AI 插畫工具:我們精心挑選的清單收錄了功能強大、設計出色的工具,能助您快速創作出令人驚豔的編輯場景與吸睛的封面藝術。每項選項均經過嚴格的實際測試,並提供免費版與付費版的比較,協助您找到最適合您工作流程的工具。 立即嘗試這些不可錯過的解決方案,釋放您的人工智慧優勢,並提升您的創意生產力。現在就前往 XIX.AI 探索吧。
10 個工具
xix.ai

2026 年最新、評價最高的考試備考 AI 輔導工具,盡在 XIX.AI!我們精心挑選的清單收錄了多款強大且顛覆傳統的工具,提供免費與付費版本的比較、實際測試,以及每週更新的排行榜。這些工具能幫助您提升寫作效率、簡化複雜主題的學習,並釋放您的學術潛能。 立即探索,發掘最適合您的備考工具,並從今天開始創作,釋放您的 AI 優勢!
10 個工具
xix.ai

2026 年最新最佳頂級評分 AI 預算規劃工具,專為個人財務管理打造,現已登陸 XIX.AI!本精選合集收錄了強大且具顛覆性的解決方案,助您開展實際測試、理解消費習慣,並制定個性化計劃以提升生產力。享受免費與付費版的對比及詳細排名。這些必試工具旨在簡化財務管理,助您釋放 AI 優勢。立即探索!
11 個工具
xix.ai

2026 年最新精選、評價最高的 AI 睡眠追蹤助手,助您獲得最佳恢復效果。這份全面更新的每週指南收錄了強大的工具,提供實際測試報告、免費與付費版本的比較,以及詳細排名,協助您找到必試的解決方案,以提升睡眠品質並培養更好的就寢習慣。 立即造訪 XIX.AI,解鎖您的 AI 優勢。
10 個工具
xix.ai

2026 年最新最佳、評價最高的 AI SQL 輔助工具,專為產品與營收分析打造! XIX.AI 精心甄選了一系列強大且顛覆業界的必試工具,這些工具均經過實戰測試,並透過每週更新的排行榜進行評比。這些工具能透過加速資料分析、簡化複雜查詢,並產生精準洞察來推動更明智的商業決策,從而大幅提升使用者生產力。立即探索,發掘最適合您的工具,釋放您的 AI 優勢!
14 個工具
xix.ai

2026 年最新最佳高評價 AI 作業輔助工具:不僅提供答案,更教授核心概念。專為學生打造的強大工具,必試精選清單,每週更新,免費與付費版本比較,實際測試,精準排名,助您充分發揮學習潛能。立即探索,發掘最適合您的工具,讓學習更聰明。
10 個工具
xix.ai












