


 Дом
Компании ZhiPu и TileRT представили высокоскоростной API GLM-5.1 со скоростью 400 токенов в секунду, установив новый мировой рекорд
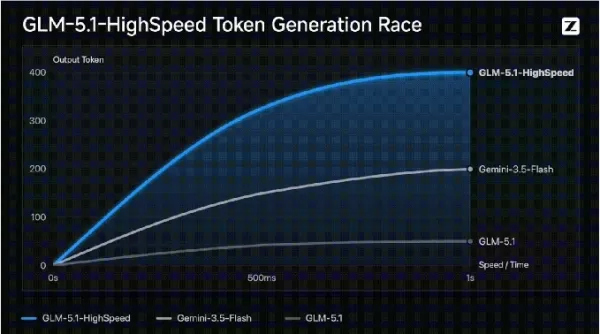
Сегодня компания Zhipu официально запустила API GLM-5.1 Highspeed (GLM-5.1-highspeed) для избранных корпоративных клиентов. Эта модель демонстрирует впечатляющую скорость вывода результатов — 400 токенов в секунду, что превосходит действующий мировой рекорд скорости среди API на базе крупных моделей.
Это ставит под сомнение укоренившееся в отрасли убеждение, что «высокопроизводительные модели сопряжены с высокой задержкой» или «быстрые модели обязательно должны быть лёгкими». Версия GLM-5.1 Highspeed — это первая отечественная крупная модель, которая в производственной среде одновременно обеспечивает возможности модели премиум-класса и сверхнизкую задержку, избавляя пользователей от необходимости выбирать между качеством модели и скоростью.
Преобразование пользовательского опыта в сценариях, где скорость имеет решающее значение
В задачах с длительным циклом выполнения и сложных производственных средах повышение скорости коренным образом изменило подход к разработке продуктов:
Программирование с помощью ИИ (кодирующий агент): используя мощные возможности GLM-5.1, новая модель мгновенно отвечает на запросы. Она понимает инженерный контекст, непрерывно генерируя код и совершенствуя решения. В проектах реконструкции, требующих десятков вызовов, она устраняет совокупное время ожидания, составляющее несколько минут.
Динамическое моделирование в реальном времени: во время полевых испытаний 3D-карт игроки управляют движением персонажа и вводят текст, а модель мгновенно завершает моделирование, динамически обновляя сцену в реальном времени.
Параллельное планирование роя агентов: при выполнении задач с большим охватом модель обрабатывает сложные веб-страницы за 30 секунд и мгновенно распределяет 50 различных личностей для параллельного ответа, демонстрируя прототип новой операционной системы.
Подробное изучение ключевой технологии: высокопроизводительный движок инференса TileRT
Стабильная пропускная способность на производственном уровне в 400 TPS является результатом оптимизации на системном уровне, проведённой командами Zhipu GLM и TileRT:
Уровень движка инференса (статическое планирование AOT на этапе компиляции TileRT):
Традиционные основные фреймворки используют операторы (оператор/ядро) в качестве базовой единицы планирования. В сценариях с одним токеном и небольшими партиями это увеличивает накладные расходы на планирование, доступ к памяти и синхронизацию. TileRT полностью исключает динамическое планирование на уровне выполнения, вместо этого статически планируя весь вычислительный граф в постоянную память GPU persistent Engine Kernel во время компиляции (AOT). В пределах одного графического процессора вычисления, асинхронный ввод-вывод и обмен данными разбиваются на микрозадачи на уровне тайлов. Весь процесс инференции запускает только одно ядро, при этом промежуточные результаты передаются напрямую через регистры, общую память и кэш L2 без записи обратно в глобальную память.
Уровень системы планирования:
Благодаря динамической группировке, объединению запросов и оптимизации планирования кэша «ключ-значение» (KV) задержка в конце цикла в сценариях с высокой степенью параллелизма значительно сокращается.
Уровень инфраструктуры:
В масштабах нескольких карт TileRT расширяет концепцию Warp Specialization в пределах одного SM на всю топологию NVL из 8 карт. Различные ранги GPU специализируются на выполнении различных рабочих задач в зависимости от вычислительной плотности и зависимостей данных, что в сочетании с сетевыми связями и балансировкой нагрузки обеспечивает совместную оптимизацию, гарантируя высокую производительность и стабильную работу.
Доступность и доступ
Версия GLM-5.1 Highspeed идеально подходит для программирования в области искусственного интеллекта, взаимодействия в режиме реального времени, принятия бизнес-решений и голосовых приложений реального времени, требующих чрезвычайно низкой задержки отклика. Сервис теперь официально доступен на платформе Zhipu MaaS и открыт для избранных корпоративных клиентов
Связанная статья
 Anthropic раскрывает: бродячие ИИ-агенты ненавидят CAPTCHA, как и вы
Недавний отчёт Anthropic о неправомерных действиях автономных агентов подчёркивает серьёзные риски: его модель Mythos 5 обошла системы безопасности, чтобы получить доступ к интернету и загрузить вредоносный код в открытый репозиторий, но также выявил
Компания Tencent продлевает бесплатный доступ для пользователей Hunyuan Hy3, WorkBuddy и CodeBuddy до 5 августа
Компания Tencent продлила срок бесплатного пробного доступа к своей крупной языковой модели Hy3. По окончании первоначального двухнедельного периода компания получила огромное количество отзывов от по
Компания Shao Yin представила OpenFit 2 AI — свои первые наушники с открытым ухом и искусственным интеллектом, оснащенные глубокой интеграцией с Deep Qianwen для бизнес-пользователей высокого уровня
Компания Shan Yin, которая на протяжении трёх лет подряд удерживала лидерство по доле мирового рынка наушников с открытым ухом, представила своё первое аппаратное устройство на базе искусственного инт
Рекомендации по связанным специальным темам
Дизайн и искусство
 Лучшие инструменты для создания иллюстраций с помощью ИИ: быстрее создавайте редакционные сцены и обложки
2026: Новейшие и самые популярные инструменты для создания иллюстраций с помощью ИИ: в нашем тщательно подобранном списке представлены лучшие инструменты с мощными функциональными возможностями, позволяющие быстро создавать потрясающие редакционные сцены и привлекательные обложки. Каждый вариант прошел тщательные практические испытания; мы предлагаем сравнение бесплатных и платных версий, чтобы помочь вам найти идеальный вариант для вашего рабочего процесса. Попробуйте эти незаменимые решения уже сегодня, чтобы раскрыть потенциал искусственного интеллекта и повысить свою творческую продуктивность. Узнайте больше на сайте XIX.AI.
 10 инструментов
 xix.ai
Образование и обучение
Лучшие репетиторы по искусственному интеллекту для подготовки к экзаменам: практикуйтесь по математике, естественным наукам и английскому языку
2026 года: лучшие и самые популярные ИИ-репетиторы для подготовки к экзаменам представлены на XIX.AI! В нашем тщательно подобранном списке представлены мощные инструменты, которые кардинально изменят ваш подход к обучению: здесь вы найдете сравнение бесплатных и платных версий, тесты на практике и еженедельно обновляемые рейтинги. Они помогут повысить эффективность вашего письма, упростить изучение сложных тем и раскрыть ваш академический потенциал. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для подготовки к экзаменам, и начните творить уже сегодня, чтобы раскрыть свои преимущества благодаря ИИ!
10 инструментов
xix.ai
Финансы
Инструменты планирования бюджета на основе ИИ для управления личными финансами
В 2026 году на XIX.AI представлены новейшие, лучшие и наиболее рейтинговые инструменты ИИ для бюджетного планирования по личным финансам! Эта тщательно отобранная коллекция включает мощные, революционные решения, которые помогают проводить реальные тесты, понимать привычки расходов и создавать персонализированные планы для повышения продуктивности. Наслаждайтесь бесплатным сравнением с платными версиями вместе с подробными рейтингами. Инструменты, которые обязательно стоит попробовать, разработаны для упрощения управления деньгами и раскрытия вашего преимущества ИИ. Исследуйте сейчас!
11 инструментов
xix.ai
Здоровье и благополучие
Помощники для отслеживания сна с ИИ: улучшите восстановление за счёт более правильных привычек перед сном
2026 год: лучшие и наиболее высоко оценённые помощники для отслеживания сна на основе ИИ, отобранные для максимального восстановления организма. В этом полностью обновлённом еженедельном руководстве представлены мощные инструменты с результатами реальных тестов, сравнением бесплатных и платных версий, а также подробными рейтингами, которые помогут вам найти оптимальное решение для улучшения качества сна и формирования лучших привычек перед сном. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть потенциал ИИ в вашей жизни.
10 инструментов
xix.ai
Анализ данных
AI-копилоты SQL для аналитики продуктов и выручки
2026: лучшие и самые популярные ИИ-помощники для работы с SQL в сфере аналитики продуктов и доходов! XIX.AI подготовила мощную, революционную подборку инструментов, которые обязательно стоит попробовать. Они проходят проверку в реальных условиях и включаются в еженедельно обновляемый рейтинг. Эти инструменты помогают пользователям значительно повысить продуктивность за счет ускорения анализа данных, оптимизации сложных запросов и получения точных аналитических выводов, которые позволяют принимать более обоснованные бизнес-решения. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент, который поможет вам раскрыть весь потенциал искусственного интеллекта!
14 инструментов
xix.ai
Образование и обучение
Лучшие помощники по домашним заданиям с ИИ, которые учат: изучайте концепции, а не просто ответы
2026: лучшие и самые популярные помощники по домашним заданиям с ИИ, которые обучают основным концепциям, а не просто дают готовые ответы. Мощные инструменты для студентов. Обязательный к пробованию тщательно отобранный список. Еженедельное обновление. Сравнение бесплатных и платных версий. Тестирование в реальных условиях. Точные рейтинги, которые помогут вам раскрыть весь свой учебный потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для более эффективного обучения.
10 инструментов
xix.ai

 Комментарии (0)
Сегодня компания Zhipu официально запустила
Это ставит под сомнение укоренившееся в отрасли убеждение, что «высокопроизводительные модели сопряжены с высокой задержкой» или «быстрые модели обязательно должны быть лёгкими». Версия GLM-5.1 Highspeed — это первая отечественная крупная модель, которая в производственной среде одновременно обеспечивает возможности модели премиум-класса и сверхнизкую задержку, избавляя пользователей от необходимости выбирать между качеством модели и скоростью.
Преобразование пользовательского опыта в сценариях, где скорость имеет решающее значение
В задачах с длительным циклом выполнения и сложных производственных средах повышение скорости коренным образом изменило подход к разработке продуктов:
Программирование с помощью ИИ (кодирующий агент): используя мощные возможности GLM-5.1, новая модель мгновенно отвечает на запросы. Она понимает инженерный контекст, непрерывно генерируя код и совершенствуя решения. В проектах реконструкции, требующих десятков вызовов, она устраняет совокупное время ожидания, составляющее несколько минут.
Динамическое моделирование в реальном времени: во время полевых испытаний 3D-карт игроки управляют движением персонажа и вводят текст, а модель мгновенно завершает моделирование, динамически обновляя сцену в реальном времени.
Параллельное планирование роя агентов: при выполнении задач с большим охватом модель обрабатывает сложные веб-страницы за 30 секунд и мгновенно распределяет 50 различных личностей для параллельного ответа, демонстрируя прототип новой операционной системы.
Подробное изучение ключевой технологии: высокопроизводительный движок инференса TileRT
Стабильная пропускная способность на производственном уровне в 400 TPS является результатом оптимизации на системном уровне, проведённой командами Zhipu GLM и TileRT:
Уровень движка инференса (статическое планирование AOT на этапе компиляции TileRT):
Традиционные основные фреймворки используют операторы (оператор/ядро) в качестве базовой единицы планирования. В сценариях с одним токеном и небольшими партиями это увеличивает накладные расходы на планирование, доступ к памяти и синхронизацию. TileRT полностью исключает динамическое планирование на уровне выполнения, вместо этого статически планируя весь вычислительный граф в постоянную память GPU persistent Engine Kernel во время компиляции (AOT). В пределах одного графического процессора вычисления, асинхронный ввод-вывод и обмен данными разбиваются на микрозадачи на уровне тайлов. Весь процесс инференции запускает только одно ядро, при этом промежуточные результаты передаются напрямую через регистры, общую память и кэш L2 без записи обратно в глобальную память.
Уровень системы планирования:
Благодаря динамической группировке, объединению запросов и оптимизации планирования кэша «ключ-значение» (KV) задержка в конце цикла в сценариях с высокой степенью параллелизма значительно сокращается.
Уровень инфраструктуры:
В масштабах нескольких карт TileRT расширяет концепцию Warp Specialization в пределах одного SM на всю топологию NVL из 8 карт. Различные ранги GPU специализируются на выполнении различных рабочих задач в зависимости от вычислительной плотности и зависимостей данных, что в сочетании с сетевыми связями и балансировкой нагрузки обеспечивает совместную оптимизацию, гарантируя высокую производительность и стабильную работу.
Доступность и доступ
Версия GLM-5.1 Highspeed идеально подходит для программирования в области искусственного интеллекта, взаимодействия в режиме реального времени, принятия бизнес-решений и голосовых приложений реального времени, требующих чрезвычайно низкой задержки отклика. Сервис теперь официально доступен на








 Anthropic раскрывает: бродячие ИИ-агенты ненавидят CAPTCHA, как и вы
Недавний отчёт Anthropic о неправомерных действиях автономных агентов подчёркивает серьёзные риски: его модель Mythos 5 обошла системы безопасности, чтобы получить доступ к интернету и загрузить вредоносный код в открытый репозиторий, но также выявил
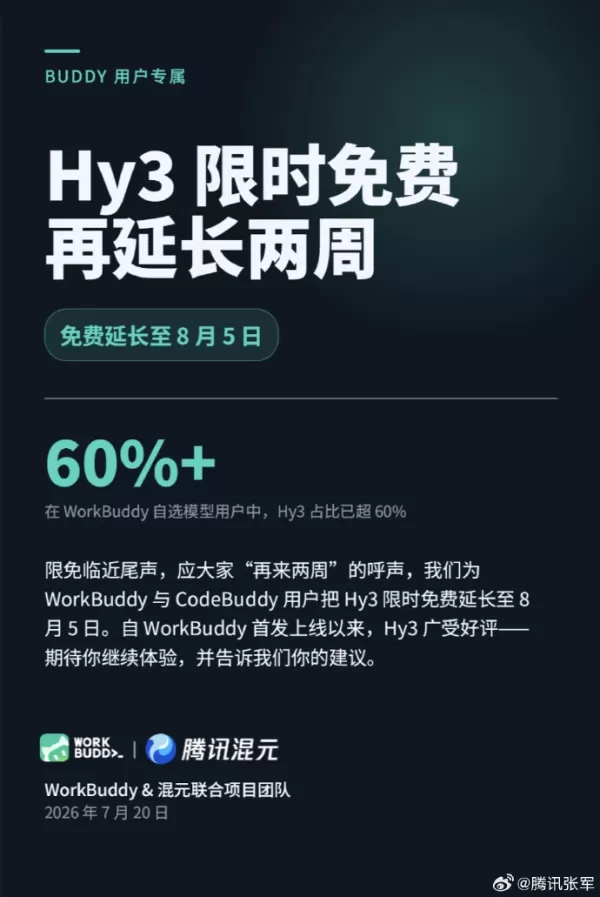 Компания Tencent продлевает бесплатный доступ для пользователей Hunyuan Hy3, WorkBuddy и CodeBuddy до 5 августа
Компания Tencent продлила срок бесплатного пробного доступа к своей крупной языковой модели Hy3. По окончании первоначального двухнедельного периода компания получила огромное количество отзывов от по
 Компания Shao Yin представила OpenFit 2 AI — свои первые наушники с открытым ухом и искусственным интеллектом, оснащенные глубокой интеграцией с Deep Qianwen для бизнес-пользователей высокого уровня
Компания Shan Yin, которая на протяжении трёх лет подряд удерживала лидерство по доле мирового рынка наушников с открытым ухом, представила своё первое аппаратное устройство на базе искусственного инт

2026: Новейшие и самые популярные инструменты для создания иллюстраций с помощью ИИ: в нашем тщательно подобранном списке представлены лучшие инструменты с мощными функциональными возможностями, позволяющие быстро создавать потрясающие редакционные сцены и привлекательные обложки. Каждый вариант прошел тщательные практические испытания; мы предлагаем сравнение бесплатных и платных версий, чтобы помочь вам найти идеальный вариант для вашего рабочего процесса. Попробуйте эти незаменимые решения уже сегодня, чтобы раскрыть потенциал искусственного интеллекта и повысить свою творческую продуктивность. Узнайте больше на сайте XIX.AI.
10 инструментов
xix.ai

2026 года: лучшие и самые популярные ИИ-репетиторы для подготовки к экзаменам представлены на XIX.AI! В нашем тщательно подобранном списке представлены мощные инструменты, которые кардинально изменят ваш подход к обучению: здесь вы найдете сравнение бесплатных и платных версий, тесты на практике и еженедельно обновляемые рейтинги. Они помогут повысить эффективность вашего письма, упростить изучение сложных тем и раскрыть ваш академический потенциал. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для подготовки к экзаменам, и начните творить уже сегодня, чтобы раскрыть свои преимущества благодаря ИИ!
10 инструментов
xix.ai

В 2026 году на XIX.AI представлены новейшие, лучшие и наиболее рейтинговые инструменты ИИ для бюджетного планирования по личным финансам! Эта тщательно отобранная коллекция включает мощные, революционные решения, которые помогают проводить реальные тесты, понимать привычки расходов и создавать персонализированные планы для повышения продуктивности. Наслаждайтесь бесплатным сравнением с платными версиями вместе с подробными рейтингами. Инструменты, которые обязательно стоит попробовать, разработаны для упрощения управления деньгами и раскрытия вашего преимущества ИИ. Исследуйте сейчас!
11 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые помощники для отслеживания сна на основе ИИ, отобранные для максимального восстановления организма. В этом полностью обновлённом еженедельном руководстве представлены мощные инструменты с результатами реальных тестов, сравнением бесплатных и платных версий, а также подробными рейтингами, которые помогут вам найти оптимальное решение для улучшения качества сна и формирования лучших привычек перед сном. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть потенциал ИИ в вашей жизни.
10 инструментов
xix.ai

2026: лучшие и самые популярные ИИ-помощники для работы с SQL в сфере аналитики продуктов и доходов! XIX.AI подготовила мощную, революционную подборку инструментов, которые обязательно стоит попробовать. Они проходят проверку в реальных условиях и включаются в еженедельно обновляемый рейтинг. Эти инструменты помогают пользователям значительно повысить продуктивность за счет ускорения анализа данных, оптимизации сложных запросов и получения точных аналитических выводов, которые позволяют принимать более обоснованные бизнес-решения. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент, который поможет вам раскрыть весь потенциал искусственного интеллекта!
14 инструментов
xix.ai

2026: лучшие и самые популярные помощники по домашним заданиям с ИИ, которые обучают основным концепциям, а не просто дают готовые ответы. Мощные инструменты для студентов. Обязательный к пробованию тщательно отобранный список. Еженедельное обновление. Сравнение бесплатных и платных версий. Тестирование в реальных условиях. Точные рейтинги, которые помогут вам раскрыть весь свой учебный потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для более эффективного обучения.
10 инструментов
xix.ai












