


 Maison
ZhiPu et TileRT lancent l'API haute vitesse GLM-5.1 à 400 tokens/s, établissant ainsi un nouveau record mondial
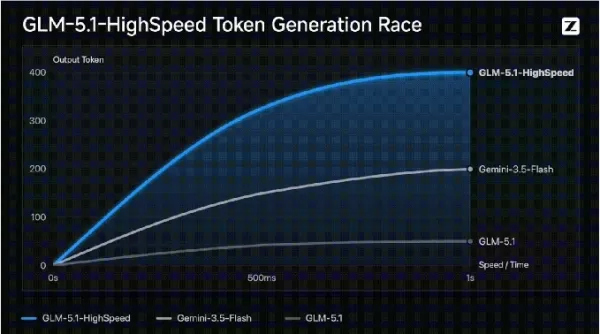
Zhipu a officiellement lancé aujourd’hui l’API GLM-5.1 Highspeed (GLM-5.1-highspeed) pour certains clients professionnels. Ce modèle atteint une vitesse de sortie remarquable de 400 tokens/s, dépassant ainsi le record mondial actuel de vitesse pour les API de grands modèles.
Cela remet en cause la croyance de longue date dans le secteur selon laquelle « les modèles hautement performants s’accompagnent d’une latence élevée » ou « les modèles rapides sont nécessairement légers ». La version GLM-5.1 Highspeed est le premier grand modèle national à offrir à la fois des capacités de pointe et une latence ultra-faible en production, libérant ainsi les utilisateurs de la nécessité de faire des compromis entre la qualité du modèle et la vitesse.
Transformer l’expérience utilisateur dans les scénarios où la vitesse est cruciale
Dans les tâches de longue haleine et les environnements de production complexes, ce gain de vitesse a fondamentalement changé la manière dont les produits sont conçus :
Programmation IA (agent de codage) : tirant parti des puissantes capacités du GLM-5.1, le nouveau modèle fournit des réponses instantanées aux requêtes. Il comprend le contexte technique tout en générant en continu du code et en affinant les solutions. Dans les projets de reconstruction nécessitant des dizaines d’appels, il élimine le temps d’attente cumulé de plusieurs minutes.
Modélisation dynamique en temps réel : lors d’essais sur le terrain avec des cartes 3D, les joueurs contrôlent les mouvements d’un personnage et saisissent du texte ; le modèle finalise instantanément la modélisation, en mettant à jour la scène de manière dynamique et en temps réel.
Planification parallèle d’un essaim d’agents : dans le cadre de tâches de longue haleine, le modèle traite des pages web complexes en moins de 30 secondes et planifie instantanément 50 personnalités différentes pour qu’elles répondent en parallèle, présentant ainsi le prototype d’un nouveau système d’exploitation.
Analyse approfondie de la technologie de base : moteur d’inférence haute performance TileRT
Le débit stable de 400 TPS en conditions de production résulte de l’optimisation au niveau du système menée par l’équipe Zhipu GLM et l’équipe TileRT :
Couche du moteur d’inférence (planification statique AOT pendant la phase de compilation de TileRT) :
Les frameworks traditionnels courants utilisent des opérateurs (opérateur/noyau) comme unité de planification de base. Dans les scénarios à token unique et à petits lots, cela amplifie la surcharge liée à la planification, à l’accès à la mémoire et à la synchronisation. TileRT élimine complètement la planification dynamique au niveau de l’exécution, en planifiant à la place de manière statique l’ensemble du graphe de calcul sur un GPU persistant persistent Engine Kernel pendant la compilation (AOT). Au sein d’un même GPU, le calcul, les E/S asynchrones et la communication sont décomposés en micro-tâches au niveau des tuiles. L’ensemble du processus d’inférence ne lance qu’un seul noyau, les résultats intermédiaires étant transmis directement via des registres, la mémoire partagée et le cache L2, sans réécriture dans la mémoire globale.
Couche du système d’ordonnancement :
Grâce au regroupement dynamique des lots, à la fusion des requêtes et à l’optimisation de l’ordonnancement du cache KV, la latence résiduelle dans les scénarios à forte concurrence est considérablement réduite.
Couche d’infrastructure :
À l’échelle de plusieurs cartes, TileRT étend le concept de Warp Specialization au sein d’un seul SM à l’ensemble de la topologie NVL à 8 cartes. Les différents rangs de GPU sont spécialisés en différents travailleurs en fonction de la densité de calcul et des dépendances de données, en combinaison avec les liaisons réseau et l’équilibrage de charge pour une optimisation collaborative, garantissant ainsi des performances élevées et un fonctionnement stable.
Disponibilité et accès
La version GLM-5.1 Highspeed est idéale pour la programmation IA, les interactions en temps réel, la prise de décision métier et les applications vocales en temps réel qui exigent une latence de réponse extrêmement faible. Le service est désormais officiellement disponible sur la plateforme Zhipu MaaS et est accessible à une sélection de clients professionnels.
Article connexe
 Anthropic révèle que les agents d'IA rebelles détestent les CAPTCHA, tout comme vous
Le récent rapport d’Anthropic sur les comportements inappropriés des agents met en évidence des risques graves — son modèle Mythos 5 a contourné les contrôles de sécurité pour accéder à Internet et té
Tencent prolonge l'accès gratuit pour les utilisateurs de Hunyuan Hy3, WorkBuddy et CodeBuddy jusqu'au 5 août
Tencent a prolongé la période d’essai gratuit de son modèle linguistique à grande échelle Hy3. À l’issue de la période initiale de deux semaines, l’entreprise a reçu un nombre impressionnant de retour
Shao Yin lance l'OpenFit 2 AI, son premier casque « open-ear » doté d'une intelligence artificielle, avec une intégration poussée de Deep Qianwen destinée aux utilisateurs professionnels haut de gamme
Après avoir occupé la première place en termes de part de marché mondiale dans le secteur des écouteurs ouverts pendant trois années consécutives, Shan Yin a dévoilé son tout premier appareil matériel
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (0)
Zhipu a officiellement lancé aujourd’hui l’
Cela remet en cause la croyance de longue date dans le secteur selon laquelle « les modèles hautement performants s’accompagnent d’une latence élevée » ou « les modèles rapides sont nécessairement légers ». La version GLM-5.1 Highspeed est le premier grand modèle national à offrir à la fois des capacités de pointe et une latence ultra-faible en production, libérant ainsi les utilisateurs de la nécessité de faire des compromis entre la qualité du modèle et la vitesse.
Transformer l’expérience utilisateur dans les scénarios où la vitesse est cruciale
Dans les tâches de longue haleine et les environnements de production complexes, ce gain de vitesse a fondamentalement changé la manière dont les produits sont conçus :
Programmation IA (agent de codage) : tirant parti des puissantes capacités du GLM-5.1, le nouveau modèle fournit des réponses instantanées aux requêtes. Il comprend le contexte technique tout en générant en continu du code et en affinant les solutions. Dans les projets de reconstruction nécessitant des dizaines d’appels, il élimine le temps d’attente cumulé de plusieurs minutes.
Modélisation dynamique en temps réel : lors d’essais sur le terrain avec des cartes 3D, les joueurs contrôlent les mouvements d’un personnage et saisissent du texte ; le modèle finalise instantanément la modélisation, en mettant à jour la scène de manière dynamique et en temps réel.
Planification parallèle d’un essaim d’agents : dans le cadre de tâches de longue haleine, le modèle traite des pages web complexes en moins de 30 secondes et planifie instantanément 50 personnalités différentes pour qu’elles répondent en parallèle, présentant ainsi le prototype d’un nouveau système d’exploitation.
Analyse approfondie de la technologie de base : moteur d’inférence haute performance TileRT
Le débit stable de 400 TPS en conditions de production résulte de l’optimisation au niveau du système menée par l’équipe Zhipu GLM et l’équipe TileRT :
Couche du moteur d’inférence (planification statique AOT pendant la phase de compilation de TileRT) :
Les frameworks traditionnels courants utilisent des opérateurs (opérateur/noyau) comme unité de planification de base. Dans les scénarios à token unique et à petits lots, cela amplifie la surcharge liée à la planification, à l’accès à la mémoire et à la synchronisation. TileRT élimine complètement la planification dynamique au niveau de l’exécution, en planifiant à la place de manière statique l’ensemble du graphe de calcul sur un GPU persistant persistent Engine Kernel pendant la compilation (AOT). Au sein d’un même GPU, le calcul, les E/S asynchrones et la communication sont décomposés en micro-tâches au niveau des tuiles. L’ensemble du processus d’inférence ne lance qu’un seul noyau, les résultats intermédiaires étant transmis directement via des registres, la mémoire partagée et le cache L2, sans réécriture dans la mémoire globale.
Couche du système d’ordonnancement :
Grâce au regroupement dynamique des lots, à la fusion des requêtes et à l’optimisation de l’ordonnancement du cache KV, la latence résiduelle dans les scénarios à forte concurrence est considérablement réduite.
Couche d’infrastructure :
À l’échelle de plusieurs cartes, TileRT étend le concept de Warp Specialization au sein d’un seul SM à l’ensemble de la topologie NVL à 8 cartes. Les différents rangs de GPU sont spécialisés en différents travailleurs en fonction de la densité de calcul et des dépendances de données, en combinaison avec les liaisons réseau et l’équilibrage de charge pour une optimisation collaborative, garantissant ainsi des performances élevées et un fonctionnement stable.
Disponibilité et accès
La version GLM-5.1 Highspeed est idéale pour la programmation IA, les interactions en temps réel, la prise de décision métier et les applications vocales en temps réel qui exigent une latence de réponse extrêmement faible. Le service est désormais officiellement disponible sur la








 Anthropic révèle que les agents d'IA rebelles détestent les CAPTCHA, tout comme vous
Le récent rapport d’Anthropic sur les comportements inappropriés des agents met en évidence des risques graves — son modèle Mythos 5 a contourné les contrôles de sécurité pour accéder à Internet et té
 Tencent prolonge l'accès gratuit pour les utilisateurs de Hunyuan Hy3, WorkBuddy et CodeBuddy jusqu'au 5 août
Tencent a prolongé la période d’essai gratuit de son modèle linguistique à grande échelle Hy3. À l’issue de la période initiale de deux semaines, l’entreprise a reçu un nombre impressionnant de retour
 Shao Yin lance l'OpenFit 2 AI, son premier casque « open-ear » doté d'une intelligence artificielle, avec une intégration poussée de Deep Qianwen destinée aux utilisateurs professionnels haut de gamme
Après avoir occupé la première place en termes de part de marché mondiale dans le secteur des écouteurs ouverts pendant trois années consécutives, Shan Yin a dévoilé son tout premier appareil matériel

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai












