


 Hogar
ZhiPu y TileRT lanzan la API de alta velocidad GLM-5.1 a 400 tokens por segundo, estableciendo un nuevo récord mundial
Zhipu ha lanzado hoy oficialmente la API GLM-5.1 Highspeed (GLM-5.1-highspeed) para una selección de clientes empresariales. Este modelo alcanza una notable velocidad de salida de 400 tokens/s, superando el actual récord mundial de velocidad para las API de modelos grandes.
Esto pone en tela de juicio la creencia arraigada en el sector de que «los modelos de alto rendimiento conllevan una alta latencia» o de que «los modelos rápidos son necesariamente ligeros». La versión GLM-5.1 Highspeed es el primer modelo a gran escala nacional que ofrece capacidades de modelo de primera calidad y una latencia ultrabaja al mismo tiempo en entorno de producción, lo que libera a los usuarios de tener que sacrificar la calidad del modelo a cambio de la velocidad.
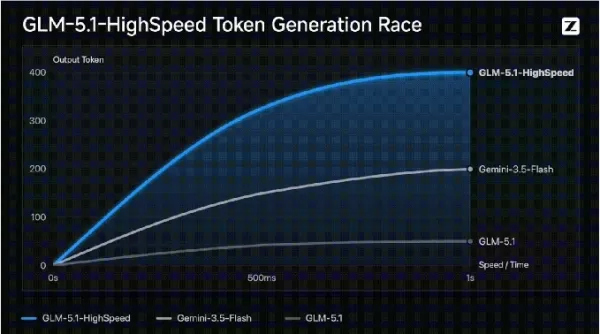
Transformando la experiencia del usuario en escenarios en los que la velocidad es fundamental
En tareas de largo alcance y entornos de producción complejos, el aumento de velocidad ha cambiado radicalmente la forma en que se diseñan los productos:
Programación de IA (agente de codificación): Aprovechando las potentes capacidades de GLM-5.1, el nuevo modelo ofrece respuestas instantáneas a las consultas. Comprende el contexto de ingeniería al tiempo que genera código y perfecciona soluciones de forma continua. En proyectos de reconstrucción que requieren docenas de llamadas, elimina el tiempo de espera acumulado de varios minutos.
Modelado dinámico en tiempo real: en pruebas de campo con mapas 3D, los jugadores controlan el movimiento de un personaje e introducen texto, y el modelo completa al instante el modelado, actualizando dinámicamente la escena en tiempo real.
Programación paralela de enjambres de agentes: en tareas de largo alcance, el modelo procesa páginas web complejas en menos de 30 segundos y programa al instante a 50 personalidades diferentes para que respondan en paralelo, lo que pone de manifiesto el prototipo de un nuevo sistema operativo.
Análisis en profundidad de la tecnología central: motor de inferencia de alto rendimiento TileRT
El rendimiento estable a nivel de producción de 400 TPS es el resultado de la optimización a nivel de sistema llevada a cabo por el equipo GLM de Zhipu y el equipo de TileRT:
Capa del motor de inferencia (programación estática AOT durante el periodo de compilación de TileRT):
Los marcos tradicionales más extendidos utilizan operadores (operador/núcleo) como unidad básica de programación. En escenarios de un solo token y de lotes pequeños, esto aumenta la sobrecarga de programación, acceso a la memoria y sincronización. TileRT elimina por completo la programación dinámica en la capa de tiempo de ejecución y, en su lugar, programa de forma estática todo el grafo de cálculo en una GPU persistente persistent Engine Kernel durante la compilación (AOT). Dentro de una misma GPU, el cálculo, la E/S asíncrona y la comunicación se descomponen en microtareas a nivel de mosaico. Todo el proceso de inferencia ejecuta un único núcleo, y los resultados intermedios se transmiten directamente a través de registros, memoria compartida y caché L2, sin necesidad de volver a escribirlos en la memoria global.
Capa del sistema de programación:
Mediante el agrupamiento dinámico en lotes, la fusión de solicitudes y la optimización de la programación de la caché KV, se reduce significativamente la latencia residual en escenarios de alta concurrencia.
Capa de infraestructura:
A escala de múltiples tarjetas, TileRT amplía el concepto de Warp Specialization dentro de un único SM a toda la topología NVL de 8 tarjetas. Los distintos rangos de GPU se especializan en diferentes trabajadores en función de la densidad computacional y las dependencias de datos, combinados con enlaces de red y equilibrio de carga para una optimización colaborativa, lo que garantiza un alto rendimiento y un funcionamiento estable.
Disponibilidad y acceso
La versión GLM-5.1 Highspeed es ideal para la programación de IA, la interacción en tiempo real, la toma de decisiones empresariales y las aplicaciones de voz en tiempo real que exigen una latencia de respuesta extremadamente baja. El servicio ya está disponible oficialmente en la plataforma Zhipu MaaS y está abierto a determinados clientes empresariales.
Artículo relacionado
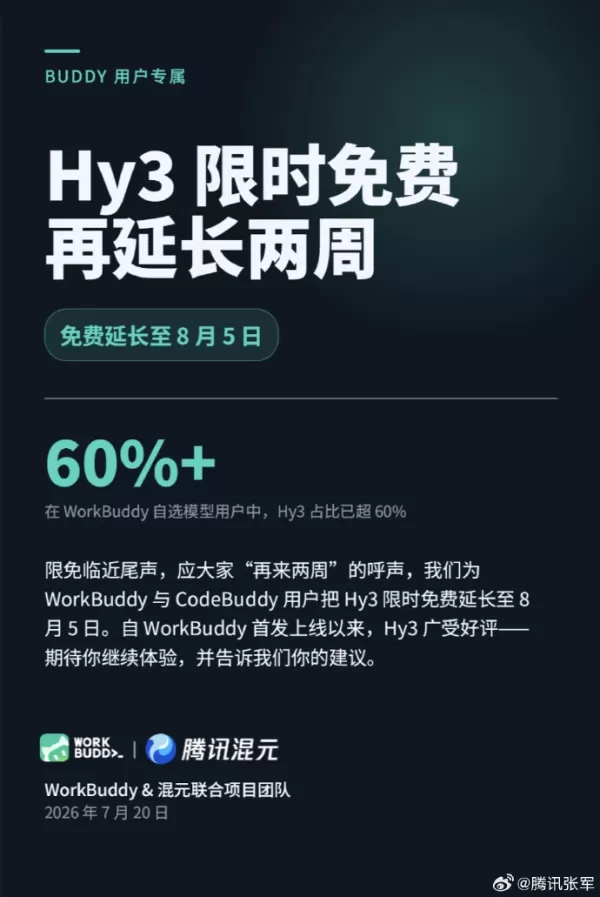
 Tencent amplía el acceso gratuito para los usuarios de Hunyuan Hy3, WorkBuddy y CodeBuddy hasta el 5 de agosto
Tencent ha ampliado el periodo de prueba gratuito de su modelo de lenguaje a gran escala Hy3. Tras finalizar el periodo inicial de dos semanas, la empresa recibió una avalancha de comentarios de los u
Shao Yin presenta OpenFit 2 AI, sus primeros auriculares de oído abierto con inteligencia artificial, con una profunda integración con Qianwen para usuarios empresariales de gama alta
Tras haber liderado la cuota de mercado mundial de auriculares de oído abierto durante tres años consecutivos, Shan Yin ha presentado su primer dispositivo de hardware basado en IA: el OpenFit 2 AI. A
Anthropic construirá un nuevo centro de datos de IA en Texas con el respaldo de Google
La inversión en infraestructura de IA está alcanzando nuevas cotas. Fuentes del sector revelan que Nexus Data Centers está negociando activamente un paquete de financiación de 1.500 millones de dólare
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (0)
0/500
Zhipu ha lanzado hoy oficialmente la
Esto pone en tela de juicio la creencia arraigada en el sector de que «los modelos de alto rendimiento conllevan una alta latencia» o de que «los modelos rápidos son necesariamente ligeros». La versión GLM-5.1 Highspeed es el primer modelo a gran escala nacional que ofrece capacidades de modelo de primera calidad y una latencia ultrabaja al mismo tiempo en entorno de producción, lo que libera a los usuarios de tener que sacrificar la calidad del modelo a cambio de la velocidad.
Transformando la experiencia del usuario en escenarios en los que la velocidad es fundamental
En tareas de largo alcance y entornos de producción complejos, el aumento de velocidad ha cambiado radicalmente la forma en que se diseñan los productos:
Programación de IA (agente de codificación): Aprovechando las potentes capacidades de GLM-5.1, el nuevo modelo ofrece respuestas instantáneas a las consultas. Comprende el contexto de ingeniería al tiempo que genera código y perfecciona soluciones de forma continua. En proyectos de reconstrucción que requieren docenas de llamadas, elimina el tiempo de espera acumulado de varios minutos.
Modelado dinámico en tiempo real: en pruebas de campo con mapas 3D, los jugadores controlan el movimiento de un personaje e introducen texto, y el modelo completa al instante el modelado, actualizando dinámicamente la escena en tiempo real.
Programación paralela de enjambres de agentes: en tareas de largo alcance, el modelo procesa páginas web complejas en menos de 30 segundos y programa al instante a 50 personalidades diferentes para que respondan en paralelo, lo que pone de manifiesto el prototipo de un nuevo sistema operativo.
Análisis en profundidad de la tecnología central: motor de inferencia de alto rendimiento TileRT
El rendimiento estable a nivel de producción de 400 TPS es el resultado de la optimización a nivel de sistema llevada a cabo por el equipo GLM de Zhipu y el equipo de TileRT:
Capa del motor de inferencia (programación estática AOT durante el periodo de compilación de TileRT):
Los marcos tradicionales más extendidos utilizan operadores (operador/núcleo) como unidad básica de programación. En escenarios de un solo token y de lotes pequeños, esto aumenta la sobrecarga de programación, acceso a la memoria y sincronización. TileRT elimina por completo la programación dinámica en la capa de tiempo de ejecución y, en su lugar, programa de forma estática todo el grafo de cálculo en una GPU persistente persistent Engine Kernel durante la compilación (AOT). Dentro de una misma GPU, el cálculo, la E/S asíncrona y la comunicación se descomponen en microtareas a nivel de mosaico. Todo el proceso de inferencia ejecuta un único núcleo, y los resultados intermedios se transmiten directamente a través de registros, memoria compartida y caché L2, sin necesidad de volver a escribirlos en la memoria global.
Capa del sistema de programación:
Mediante el agrupamiento dinámico en lotes, la fusión de solicitudes y la optimización de la programación de la caché KV, se reduce significativamente la latencia residual en escenarios de alta concurrencia.
Capa de infraestructura:
A escala de múltiples tarjetas, TileRT amplía el concepto de Warp Specialization dentro de un único SM a toda la topología NVL de 8 tarjetas. Los distintos rangos de GPU se especializan en diferentes trabajadores en función de la densidad computacional y las dependencias de datos, combinados con enlaces de red y equilibrio de carga para una optimización colaborativa, lo que garantiza un alto rendimiento y un funcionamiento estable.
Disponibilidad y acceso
La versión GLM-5.1 Highspeed es ideal para la programación de IA, la interacción en tiempo real, la toma de decisiones empresariales y las aplicaciones de voz en tiempo real que exigen una latencia de respuesta extremadamente baja. El servicio ya está disponible oficialmente en la








 Tencent amplía el acceso gratuito para los usuarios de Hunyuan Hy3, WorkBuddy y CodeBuddy hasta el 5 de agosto
Tencent ha ampliado el periodo de prueba gratuito de su modelo de lenguaje a gran escala Hy3. Tras finalizar el periodo inicial de dos semanas, la empresa recibió una avalancha de comentarios de los u
 Shao Yin presenta OpenFit 2 AI, sus primeros auriculares de oído abierto con inteligencia artificial, con una profunda integración con Qianwen para usuarios empresariales de gama alta
Tras haber liderado la cuota de mercado mundial de auriculares de oído abierto durante tres años consecutivos, Shan Yin ha presentado su primer dispositivo de hardware basado en IA: el OpenFit 2 AI. A
 Anthropic construirá un nuevo centro de datos de IA en Texas con el respaldo de Google
La inversión en infraestructura de IA está alcanzando nuevas cotas. Fuentes del sector revelan que Nexus Data Centers está negociando activamente un paquete de financiación de 1.500 millones de dólare

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai












