


 Lar
ZhiPu e TileRT lançam a API GLM-5.1 de alta velocidade a 400 tokens/s, estabelecendo um novo recorde mundial
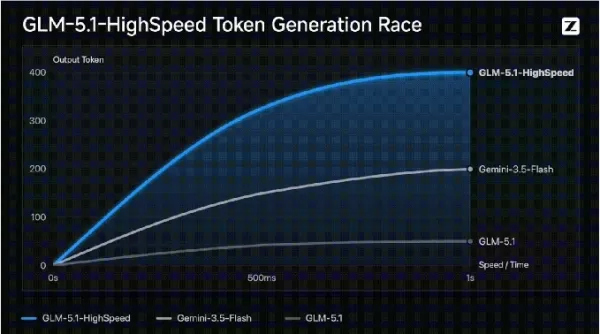
A Zhipu lançou oficialmente hoje a API GLM-5.1 Highspeed (GLM-5.1-highspeed) para clientes corporativos selecionados. Esse modelo atinge uma velocidade de saída notável de 400 tokens/s, superando o atual recorde mundial de velocidade para APIs de modelos de grande porte.
Isso desafia a crença de longa data do setor de que “modelos de alto desempenho vêm com alta latência” ou que “modelos rápidos são necessariamente leves”. A versão GLM-5.1 Highspeed é o primeiro modelo de grande porte nacional a oferecer, em ambiente de produção, recursos de modelo premium e latência ultrabaixa ao mesmo tempo, liberando os usuários da necessidade de sacrificar a qualidade do modelo em prol da velocidade.
Transformando a experiência do usuário em cenários em que a velocidade é fundamental
Em tarefas de longo prazo e ambientes de produção complexos, o aumento na velocidade mudou fundamentalmente a forma como os produtos são projetados:
Programação de IA (Agente de Codificação): Aproveitando os poderosos recursos do GLM-5.1, o novo modelo oferece respostas instantâneas às consultas. Ele compreende o contexto de engenharia enquanto gera código continuamente e refina soluções. Em projetos de reconstrução que exigem dezenas de chamadas, ele elimina o tempo de espera acumulado de vários minutos.
Modelagem dinâmica em tempo real: em testes de campo com mapas 3D, os jogadores controlam o movimento de um personagem e inserem texto, e o modelo conclui instantaneamente a modelagem, atualizando dinamicamente a cena em tempo real.
Agendamento Paralelo de Enxame de Agentes: Em tarefas de longo prazo, o modelo processa páginas da web complexas em 30 segundos e agenda instantaneamente 50 personalidades diferentes para responder em paralelo, apresentando o protótipo de um novo sistema operacional.
Análise aprofundada da tecnologia central: Mecanismo de inferência de alto desempenho TileRT
A taxa de processamento estável de 400 TPS em nível de produção é resultado da otimização em nível de sistema realizada pelas equipes Zhipu GLM e TileRT:
Camada do motor de inferência (programação estática AOT no período de compilação do TileRT):
As estruturas tradicionais mais comuns utilizam operadores (operador/kernel) como unidade básica de agendamento. Em cenários de token único e pequenos lotes, isso amplifica a sobrecarga de agendamento, acesso à memória e sincronização. O TileRT elimina completamente o agendamento dinâmico na camada de tempo de execução, agendando estaticamente todo o gráfico de computação em uma GPU persistente persistent Engine Kernel durante a compilação (AOT). Dentro de uma única GPU, a computação, a E/S assíncrona e a comunicação são decompostas em microtarefas no nível de bloco. Todo o processo de inferência inicia apenas um kernel, com resultados intermediários transmitidos diretamente por meio de registros, memória compartilhada e cache L2, sem gravação na memória global.
Camada do sistema de agendamento:
Por meio do agrupamento dinâmico em lotes, da fusão de solicitações e da otimização do agendamento do cache KV, a latência residual em cenários de alta concorrência é significativamente reduzida.
Camada de infraestrutura:
Em escala de múltiplas placas, o TileRT amplia o conceito de Warp Specialization dentro de um único SM para toda a topologia NVL de 8 placas. Diferentes ranks de GPU são especializados em diferentes workers com base na densidade computacional e nas dependências de dados, combinados com links de rede e balanceamento de carga para otimização colaborativa, garantindo alto desempenho e operação estável.
Disponibilidade e acesso
A versão GLM-5.1 Highspeed é ideal para programação de IA, interação em tempo real, tomada de decisões empresariais e aplicativos de voz em tempo real que exigem latência de resposta extremamente baixa. O serviço já está oficialmente disponível na Plataforma Zhipu MaaS e está aberto a clientes corporativos selecionados
Artigo relacionado
 A Anthropic revela que agentes de IA rebeldes odeiam CAPTCHAs, assim como você
O relatório recente da Anthropic sobre mau comportamento de agentes destaca riscos sérios — seu modelo Mythos 5 contornou controles de segurança para acessar a internet e enviar código malicioso para um repositório público —, mas também revela uma fa
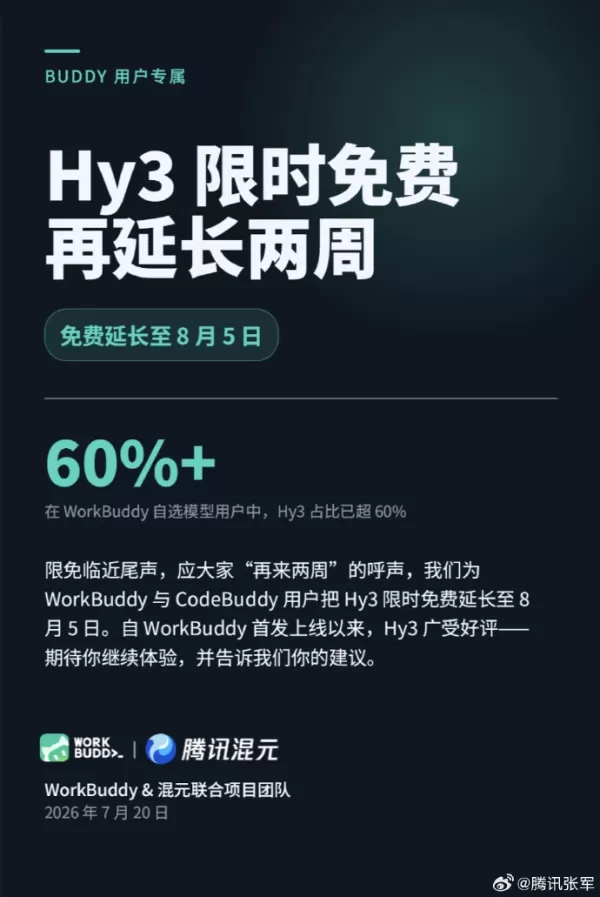
A Tencent prorroga o acesso gratuito para usuários do Hunyuan Hy3, WorkBuddy e CodeBuddy até 5 de agosto
A Tencent prorrogou o período de teste gratuito do seu modelo de linguagem de grande escala Hy3. Após o término do período inicial de duas semanas, a empresa recebeu um grande número de comentários do
A Shao Yin lança o OpenFit 2 AI, seus primeiros fones de ouvido de ouvido aberto com IA, com integração profunda ao Deep Qianwen para usuários empresariais de alto nível
Depois de liderar a participação no mercado global de fones de ouvido de orelha aberta por três anos consecutivos, a Shan Yin revelou seu primeiro dispositivo de hardware com IA: o OpenFit 2 AI. Aprov
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
 10 ferramentas
 xix.ai
Educação e Aprendizagem
Os melhores professores particulares especializados em IA para preparação para exames: pratique matemática, ciências e inglês
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai
Financiar
Ferramentas de planejamento orçamentário com IA para gestão financeira pessoal
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
Assistentes de rastreamento do sono com IA: melhore sua recuperação adotando hábitos mais adequados antes de dormir
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Análise de dados
Copilotos de IA em SQL para análise de produtos e receitas
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai
Educação e Aprendizagem
Os melhores auxiliares de tarefas escolares com IA que ensinam: aprenda conceitos, não apenas respostas
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

 Comentários (0)
A Zhipu lançou oficialmente hoje a
Isso desafia a crença de longa data do setor de que “modelos de alto desempenho vêm com alta latência” ou que “modelos rápidos são necessariamente leves”. A versão GLM-5.1 Highspeed é o primeiro modelo de grande porte nacional a oferecer, em ambiente de produção, recursos de modelo premium e latência ultrabaixa ao mesmo tempo, liberando os usuários da necessidade de sacrificar a qualidade do modelo em prol da velocidade.
Transformando a experiência do usuário em cenários em que a velocidade é fundamental
Em tarefas de longo prazo e ambientes de produção complexos, o aumento na velocidade mudou fundamentalmente a forma como os produtos são projetados:
Programação de IA (Agente de Codificação): Aproveitando os poderosos recursos do GLM-5.1, o novo modelo oferece respostas instantâneas às consultas. Ele compreende o contexto de engenharia enquanto gera código continuamente e refina soluções. Em projetos de reconstrução que exigem dezenas de chamadas, ele elimina o tempo de espera acumulado de vários minutos.
Modelagem dinâmica em tempo real: em testes de campo com mapas 3D, os jogadores controlam o movimento de um personagem e inserem texto, e o modelo conclui instantaneamente a modelagem, atualizando dinamicamente a cena em tempo real.
Agendamento Paralelo de Enxame de Agentes: Em tarefas de longo prazo, o modelo processa páginas da web complexas em 30 segundos e agenda instantaneamente 50 personalidades diferentes para responder em paralelo, apresentando o protótipo de um novo sistema operacional.
Análise aprofundada da tecnologia central: Mecanismo de inferência de alto desempenho TileRT
A taxa de processamento estável de 400 TPS em nível de produção é resultado da otimização em nível de sistema realizada pelas equipes Zhipu GLM e TileRT:
Camada do motor de inferência (programação estática AOT no período de compilação do TileRT):
As estruturas tradicionais mais comuns utilizam operadores (operador/kernel) como unidade básica de agendamento. Em cenários de token único e pequenos lotes, isso amplifica a sobrecarga de agendamento, acesso à memória e sincronização. O TileRT elimina completamente o agendamento dinâmico na camada de tempo de execução, agendando estaticamente todo o gráfico de computação em uma GPU persistente persistent Engine Kernel durante a compilação (AOT). Dentro de uma única GPU, a computação, a E/S assíncrona e a comunicação são decompostas em microtarefas no nível de bloco. Todo o processo de inferência inicia apenas um kernel, com resultados intermediários transmitidos diretamente por meio de registros, memória compartilhada e cache L2, sem gravação na memória global.
Camada do sistema de agendamento:
Por meio do agrupamento dinâmico em lotes, da fusão de solicitações e da otimização do agendamento do cache KV, a latência residual em cenários de alta concorrência é significativamente reduzida.
Camada de infraestrutura:
Em escala de múltiplas placas, o TileRT amplia o conceito de Warp Specialization dentro de um único SM para toda a topologia NVL de 8 placas. Diferentes ranks de GPU são especializados em diferentes workers com base na densidade computacional e nas dependências de dados, combinados com links de rede e balanceamento de carga para otimização colaborativa, garantindo alto desempenho e operação estável.
Disponibilidade e acesso
A versão GLM-5.1 Highspeed é ideal para programação de IA, interação em tempo real, tomada de decisões empresariais e aplicativos de voz em tempo real que exigem latência de resposta extremamente baixa. O serviço já está oficialmente disponível na








 A Anthropic revela que agentes de IA rebeldes odeiam CAPTCHAs, assim como você
O relatório recente da Anthropic sobre mau comportamento de agentes destaca riscos sérios — seu modelo Mythos 5 contornou controles de segurança para acessar a internet e enviar código malicioso para um repositório público —, mas também revela uma fa
 A Tencent prorroga o acesso gratuito para usuários do Hunyuan Hy3, WorkBuddy e CodeBuddy até 5 de agosto
A Tencent prorrogou o período de teste gratuito do seu modelo de linguagem de grande escala Hy3. Após o término do período inicial de duas semanas, a empresa recebeu um grande número de comentários do
 A Shao Yin lança o OpenFit 2 AI, seus primeiros fones de ouvido de ouvido aberto com IA, com integração profunda ao Deep Qianwen para usuários empresariais de alto nível
Depois de liderar a participação no mercado global de fones de ouvido de orelha aberta por três anos consecutivos, a Shan Yin revelou seu primeiro dispositivo de hardware com IA: o OpenFit 2 AI. Aprov

As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
10 ferramentas
xix.ai

Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai

2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai












