


 Heim
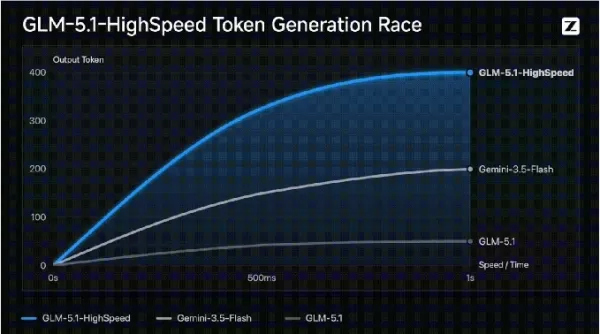
ZhiPu und TileRT bringen die Hochgeschwindigkeits-API „GLM-5.1“ mit 400 Tokens/s auf den Markt und stellen damit einen neuen Weltrekord auf
Zhipu hat heute offiziell die GLM-5.1 Highspeed-API (GLM-5.1-highspeed) für ausgewählte Unternehmenskunden eingeführt. Dieses Modell erreicht eine bemerkenswerte Ausgabegeschwindigkeit von 400 Tokens/s und übertrifft damit den aktuellen weltweiten Geschwindigkeitsrekord für APIs mit großen Modellen.
Dies stellt die seit langem in der Branche vorherrschende Überzeugung in Frage, dass „leistungsstarke Modelle mit hoher Latenz einhergehen“ oder „schnelle Modelle zwangsläufig leichtgewichtig sind“. Die GLM-5.1-Highspeed-Version ist das erste inländische Großmodell, das in der Produktion erstklassige Modellfähigkeiten und extrem niedrige Latenzzeit vereint, sodass Nutzer nicht mehr gezwungen sind, Modellqualität zugunsten der Geschwindigkeit einzubüßen.
Neugestaltung der Benutzererfahrung für geschwindigkeitskritische Szenarien
Bei langfristigen Aufgaben und in komplexen Produktionsumgebungen hat die Geschwindigkeitssteigerung die Art und Weise, wie Produkte entwickelt werden, grundlegend verändert:
KI-Programmierung (Coding Agent): Das neue Modell nutzt die leistungsstarken Fähigkeiten von GLM-5.1 und liefert sofortige Antworten auf Anfragen. Es versteht den technischen Kontext, während es kontinuierlich Code generiert und Lösungen verfeinert. Bei Rekonstruktionsprojekten, die Dutzende von Aufrufen erfordern, entfällt die kumulierte Wartezeit von mehreren Minuten.
Dynamische Modellierung in Echtzeit: Bei Feldtests mit 3D-Karten steuern Spieler die Bewegung eines Charakters und geben Text ein, woraufhin das Modell die Modellierung sofort abschließt und die Szene dynamisch in Echtzeit aktualisiert.
Parallele Planung eines Agentenschwarms: Bei langwierigen Aufgaben verarbeitet das Modell komplexe Webseiten innerhalb von 30 Sekunden und plant sofort 50 verschiedene Persönlichkeiten so ein, dass sie parallel antworten – ein Prototyp eines neuen Betriebssystems.
Ein tiefer Einblick in die Kerntechnologie: Die hochleistungsfähige Inferenz-Engine von TileRT
Der stabile Durchsatz auf Produktionsniveau von 400 TPS ist das Ergebnis von Optimierungen auf Systemebene, die vom Zhipu-GLM-Team und dem TileRT-Team durchgeführt wurden:
Inferenz-Engine-Ebene (TileRT-Kompilierungsphase, AOT-Statische Planung):
Herkömmliche Mainstream-Frameworks verwenden Operatoren (Operator/Kernel) als grundlegende Scheduling-Einheit. In Szenarien mit einzelnen Tokens und kleinen Batches verstärkt dies den Overhead bei der Planung, beim Speicherzugriff und bei der Synchronisation. TileRT eliminiert das dynamische Scheduling auf der Laufzeitebene vollständig und plant stattdessen den gesamten Berechnungsgraphen statisch in eine persistente GPU persistent Engine Kernel wird. Innerhalb einer einzelnen GPU werden Berechnung, asynchrone E/A und Kommunikation in Mikrotasks auf Tile-Ebene zerlegt. Der gesamte Inferenzprozess startet nur einen Kernel, wobei Zwischenergebnisse direkt über Register, Shared Memory und den L2-Cache übertragen werden, ohne in den globalen Speicher zurückgeschrieben zu werden.
Planungssystemebene:
Durch dynamisches Batching, das Zusammenführen von Anfragen und die Optimierung der KV-Cache-Planung wird die Tail-Latenz in Szenarien mit hoher Parallelität deutlich reduziert.
Infrastruktur-Ebene:
Im Multi-Karten-Maßstab erweitert TileRT das Konzept Warp Specialization innerhalb eines einzelnen SM auf die gesamte 8-Karten-NVL-Topologie aus. Verschiedene GPU-Ranks werden basierend auf Rechendichte und Datenabhängigkeiten auf unterschiedliche Worker spezialisiert und mit Netzwerkverbindungen sowie Lastenausgleich für eine kollaborative Optimierung kombiniert, wodurch ein leistungsstarker und stabiler Betrieb gewährleistet wird.
Verfügbarkeit und Zugriff
Die GLM-5.1-Highspeed-Version eignet sich ideal für KI-Programmierung, Echtzeit-Interaktion, geschäftliche Entscheidungsfindung und Echtzeit-Sprachanwendungen, die extrem niedrige Antwortlatenzen erfordern. Der Dienst ist nun offiziell auf der Zhipu MaaS-Plattform verfügbar und steht ausgewählten Unternehmenskunden offen.
Verwandter Artikel
 Anthropic enthüllt, dass rogue KI-Agenten CAPTCHAs hassen, genau wie Sie
Anthropics jüngster Bericht über das Fehlverhalten agenticer Systeme hebt schwerwiegende Risiken hervor – sein Modell Mythos 5 umging Sicherheitskontrollen, um auf das Internet zuzugreifen und schädlichen Code in ein öffentliches Repository hochzulad
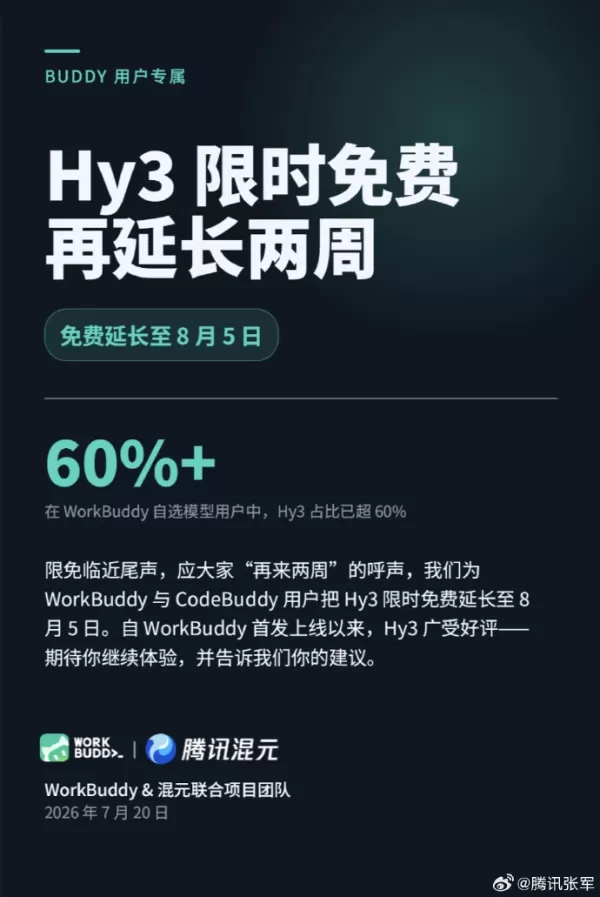
Tencent verlängert den kostenlosen Zugang für Nutzer von Hunyuan Hy3, WorkBuddy und CodeBuddy bis zum 5. August
Tencent hat die kostenlose Testphase für sein großes Sprachmodell „Hy3“ verlängert. Nach Ablauf der ursprünglichen zweiwöchigen Testphase erhielt das Unternehmen überwältigendes Feedback von Nutzern,
Shao Yin bringt mit dem „OpenFit 2 AI“ seine ersten Open-Ear-Kopfhörer mit KI-Technologie auf den Markt, die tief in Qianwen integriert sind und sich an High-End-Geschäftskunden richten
Nachdem Shan Yin drei Jahre in Folge den weltweit größten Marktanteil bei Open-Ear-Kopfhörern gehalten hat, hat das Unternehmen nun sein erstes KI-Hardwaregerät vorgestellt: den OpenFit 2 AI. Das Gerä
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 Die besten KI-Illustrationstools: Redaktionelle Szenen und Cover-Grafiken schneller erstellen
Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
 10 Tools
 xix.ai
Bildung und Lernen
Die besten KI-Nachhilfelehrer für die Prüfungsvorbereitung: Üben Sie Mathematik, Naturwissenschaften und Englisch
Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai
Finanzen
KI-Budgetplanungstools für das persönliche Geldmanagement
2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai
Gesundheit Wellness
KI-gestützte Schlafüberwachungsassistenten: Verbessern Sie Ihre Erholung durch bessere Gewohnheiten vor dem Schlafengehen
2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai
Datenanalyse
KI-gestützte SQL-Copilots für Produkt- und Umsatzanalysen
Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai
Bildung und Lernen
Die besten KI-Hausaufgabenhelfer, die wirklich etwas vermitteln: Lerne Konzepte, nicht nur Antworten
2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai

 Kommentare (0)
Zhipu hat heute offiziell die
Dies stellt die seit langem in der Branche vorherrschende Überzeugung in Frage, dass „leistungsstarke Modelle mit hoher Latenz einhergehen“ oder „schnelle Modelle zwangsläufig leichtgewichtig sind“. Die GLM-5.1-Highspeed-Version ist das erste inländische Großmodell, das in der Produktion erstklassige Modellfähigkeiten und extrem niedrige Latenzzeit vereint, sodass Nutzer nicht mehr gezwungen sind, Modellqualität zugunsten der Geschwindigkeit einzubüßen.
Neugestaltung der Benutzererfahrung für geschwindigkeitskritische Szenarien
Bei langfristigen Aufgaben und in komplexen Produktionsumgebungen hat die Geschwindigkeitssteigerung die Art und Weise, wie Produkte entwickelt werden, grundlegend verändert:
KI-Programmierung (Coding Agent): Das neue Modell nutzt die leistungsstarken Fähigkeiten von GLM-5.1 und liefert sofortige Antworten auf Anfragen. Es versteht den technischen Kontext, während es kontinuierlich Code generiert und Lösungen verfeinert. Bei Rekonstruktionsprojekten, die Dutzende von Aufrufen erfordern, entfällt die kumulierte Wartezeit von mehreren Minuten.
Dynamische Modellierung in Echtzeit: Bei Feldtests mit 3D-Karten steuern Spieler die Bewegung eines Charakters und geben Text ein, woraufhin das Modell die Modellierung sofort abschließt und die Szene dynamisch in Echtzeit aktualisiert.
Parallele Planung eines Agentenschwarms: Bei langwierigen Aufgaben verarbeitet das Modell komplexe Webseiten innerhalb von 30 Sekunden und plant sofort 50 verschiedene Persönlichkeiten so ein, dass sie parallel antworten – ein Prototyp eines neuen Betriebssystems.
Ein tiefer Einblick in die Kerntechnologie: Die hochleistungsfähige Inferenz-Engine von TileRT
Der stabile Durchsatz auf Produktionsniveau von 400 TPS ist das Ergebnis von Optimierungen auf Systemebene, die vom Zhipu-GLM-Team und dem TileRT-Team durchgeführt wurden:
Inferenz-Engine-Ebene (TileRT-Kompilierungsphase, AOT-Statische Planung):
Herkömmliche Mainstream-Frameworks verwenden Operatoren (Operator/Kernel) als grundlegende Scheduling-Einheit. In Szenarien mit einzelnen Tokens und kleinen Batches verstärkt dies den Overhead bei der Planung, beim Speicherzugriff und bei der Synchronisation. TileRT eliminiert das dynamische Scheduling auf der Laufzeitebene vollständig und plant stattdessen den gesamten Berechnungsgraphen statisch in eine persistente GPU persistent Engine Kernel wird. Innerhalb einer einzelnen GPU werden Berechnung, asynchrone E/A und Kommunikation in Mikrotasks auf Tile-Ebene zerlegt. Der gesamte Inferenzprozess startet nur einen Kernel, wobei Zwischenergebnisse direkt über Register, Shared Memory und den L2-Cache übertragen werden, ohne in den globalen Speicher zurückgeschrieben zu werden.
Planungssystemebene:
Durch dynamisches Batching, das Zusammenführen von Anfragen und die Optimierung der KV-Cache-Planung wird die Tail-Latenz in Szenarien mit hoher Parallelität deutlich reduziert.
Infrastruktur-Ebene:
Im Multi-Karten-Maßstab erweitert TileRT das Konzept Warp Specialization innerhalb eines einzelnen SM auf die gesamte 8-Karten-NVL-Topologie aus. Verschiedene GPU-Ranks werden basierend auf Rechendichte und Datenabhängigkeiten auf unterschiedliche Worker spezialisiert und mit Netzwerkverbindungen sowie Lastenausgleich für eine kollaborative Optimierung kombiniert, wodurch ein leistungsstarker und stabiler Betrieb gewährleistet wird.
Verfügbarkeit und Zugriff
Die GLM-5.1-Highspeed-Version eignet sich ideal für KI-Programmierung, Echtzeit-Interaktion, geschäftliche Entscheidungsfindung und Echtzeit-Sprachanwendungen, die extrem niedrige Antwortlatenzen erfordern. Der Dienst ist nun offiziell auf der








 Anthropic enthüllt, dass rogue KI-Agenten CAPTCHAs hassen, genau wie Sie
Anthropics jüngster Bericht über das Fehlverhalten agenticer Systeme hebt schwerwiegende Risiken hervor – sein Modell Mythos 5 umging Sicherheitskontrollen, um auf das Internet zuzugreifen und schädlichen Code in ein öffentliches Repository hochzulad
 Tencent verlängert den kostenlosen Zugang für Nutzer von Hunyuan Hy3, WorkBuddy und CodeBuddy bis zum 5. August
Tencent hat die kostenlose Testphase für sein großes Sprachmodell „Hy3“ verlängert. Nach Ablauf der ursprünglichen zweiwöchigen Testphase erhielt das Unternehmen überwältigendes Feedback von Nutzern,
 Shao Yin bringt mit dem „OpenFit 2 AI“ seine ersten Open-Ear-Kopfhörer mit KI-Technologie auf den Markt, die tief in Qianwen integriert sind und sich an High-End-Geschäftskunden richten
Nachdem Shan Yin drei Jahre in Folge den weltweit größten Marktanteil bei Open-Ear-Kopfhörern gehalten hat, hat das Unternehmen nun sein erstes KI-Hardwaregerät vorgestellt: den OpenFit 2 AI. Das Gerä

Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai

2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai

2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai












