


 Дом
Xunfei Xinghuo X2-Flash выходит на рынок с повышенной вычислительной мощностью и поддержкой длинных текстов объемом до 256 КБ
29 апреля компания iFLYTEK официально представила новую модель Spark X2-Flash и открыла доступ к своему API-интерфейсу, что стало новым этапом в повышении эффективности приложений на базе крупных моделей, построенных на отечественной экосистеме вычислительных ресурсов.
Модель использует современную архитектуру MoE (Mixture of Experts) с общим количеством параметров 30 миллиардов. Ее отличительной особенностью является поддержка сверхдлинного контекста длиной до 256K. Примечательно, что модель Spark X2-Flash была полностью обучена на кластере Ascend 910B компании Huawei, что демонстрирует синергию отечественного программного и аппаратного обеспечения для обучения глубокого обучения.
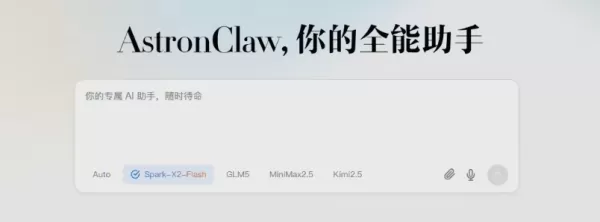
Что касается основной производительности, Spark X2-Flash обеспечивает значительное повышение возможностей по генерации агентов и кода. Сторонние тесты показывают, что его производительность при решении сложных задач — таких как обработка подробных исследовательских отчетов, управление и вызов навыков, а также управление системой — достигла уровня ведущих отраслевых моделей с триллионами параметров.
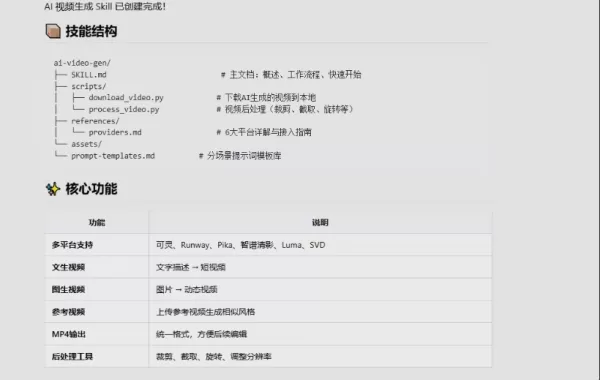
Что касается стоимости, которая важна для разработчиков, Spark X2-Flash превосходит аналоги. В тестах с идентичным рабочим процессом его потребление токенов составляет всего одну треть от потребления текущих основных крупных моделей, что значительно снижает барьер для создания сложных приложений-агентов. Например, при создании сложных навыков генерации видео модель не только быстро улавливает требования, но и предлагает подробные объяснения, охватывающие структуру навыка и основные функции.
С технической точки зрения Spark X2-Flash — первая модель, сочетающая DSA (Sparse Attention) и MTP (Multi-Token Prediction) на отечественных чипах. Эта инновация решает проблему медленного обучения на длинных текстах на отечественных вычислительных платформах, повышая эффективность обучения в 4,5 раза по сравнению с кластерами аналогичного масштаба. Кроме того, для сценариев обучения с подкреплением агентов модель более чем в два раза повышает эффективность вывода по выборке за счет комбинированных алгоритмических и инженерных оптимизаций, эффективно устраняя узкие места в производительности при длительных сценариях взаимодействия.
В настоящее время такие приложения, как AstronClaw и Loomy, первыми завершили интеграцию. Модель также глубоко согласована с международными основными фреймворками агентов, такими как OpenClaw и Claude Code, предлагая разработчикам по всему миру более экономичный вариант отечественных вычислительных мощностей.
Связанная статья
 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех
Рекомендации по связанным специальным темам
чат-бот
 Лучшие приложения для ролевых чатов с ИИ для практики языка, подготовки к собеседованиям и ежедневной разговорной практики
2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
 10 инструментов
 xix.ai
Музыкальная композиция
Инструменты разделения стемов с использованием ИИ для создания ремиксов, подготовки образцов звука и формирования финальных версий караоке.
2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai
Анализ данных
ИИ-копилоты для SQL, предназначенные для создания панелей управления доходами, анализа воронки продаж и отслеживания показателей продуктов.
2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai
Музыкальная композиция
Лучшие инструменты для написания мелодий с помощью ИИ для черновиков песен
2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai
чат-бот
Лучшие инструменты для тренировки разговоров с помощью ИИ для подготовки к собеседованиям
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai
Дизайн и искусство
Лучшие инструменты для переноса стилей с помощью ИИ для творческих экспериментов
2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai

 Комментарии (0)
29 апреля компания iFLYTEK официально представила новую модель Spark X2-Flash и открыла доступ к своему API-интерфейсу, что стало новым этапом в повышении эффективности приложений на базе крупных моделей, построенных на отечественной экосистеме вычислительных ресурсов.
Модель использует современную архитектуру MoE (Mixture of Experts) с общим количеством параметров 30 миллиардов. Ее отличительной особенностью является поддержка сверхдлинного контекста длиной до 256K. Примечательно, что модель Spark X2-Flash была полностью обучена на кластере Ascend 910B компании Huawei, что демонстрирует синергию отечественного программного и аппаратного обеспечения для обучения глубокого обучения.
Что касается основной производительности, Spark X2-Flash обеспечивает значительное повышение возможностей по генерации агентов и кода. Сторонние тесты показывают, что его производительность при решении сложных задач — таких как обработка подробных исследовательских отчетов, управление и вызов навыков, а также управление системой — достигла уровня ведущих отраслевых моделей с триллионами параметров.
Что касается стоимости, которая важна для разработчиков, Spark X2-Flash превосходит аналоги. В тестах с идентичным рабочим процессом его потребление токенов составляет всего одну треть от потребления текущих основных крупных моделей, что значительно снижает барьер для создания сложных приложений-агентов. Например, при создании сложных навыков генерации видео модель не только быстро улавливает требования, но и предлагает подробные объяснения, охватывающие структуру навыка и основные функции.
С технической точки зрения Spark X2-Flash — первая модель, сочетающая DSA (Sparse Attention) и MTP (Multi-Token Prediction) на отечественных чипах. Эта инновация решает проблему медленного обучения на длинных текстах на отечественных вычислительных платформах, повышая эффективность обучения в 4,5 раза по сравнению с кластерами аналогичного масштаба. Кроме того, для сценариев обучения с подкреплением агентов модель более чем в два раза повышает эффективность вывода по выборке за счет комбинированных алгоритмических и инженерных оптимизаций, эффективно устраняя узкие места в производительности при длительных сценариях взаимодействия.
В настоящее время такие приложения, как AstronClaw и Loomy, первыми завершили интеграцию. Модель также глубоко согласована с международными основными фреймворками агентов, такими как OpenClaw и Claude Code, предлагая разработчикам по всему миру более экономичный вариант отечественных вычислительных мощностей.








 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
 OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех

2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
10 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai

2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai

2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai












