


 Maison
Le Xunfei Xinghuo X2-Flash fait son entrée sur le marché avec une puissance de calcul interne améliorée et la prise en charge de textes longs de 256 Ko
Le 29 avril, iFLYTEK a officiellement lancé le nouveau modèle Spark X2-Flash et ouvert son interface API, marquant ainsi une nouvelle étape en matière d'efficacité pour les applications de grands modèles s'appuyant sur l'écosystème national de puissance de calcul.
Le modèle utilise l'architecture MoE (Mixture of Experts) couramment utilisée aujourd'hui, avec un total de 30 milliards de paramètres. Sa caractéristique principale est la prise en charge d'un contexte ultra-long pouvant atteindre 256K. Il convient de noter que le Spark X2-Flash a été entièrement entraîné sur le cluster Ascend 910B de Huawei, démontrant ainsi la synergie entre les logiciels et le matériel nationaux pour l'entraînement en apprentissage profond.
En termes de performances de base, le Spark X2-Flash offre des gains significatifs en matière de capacités de génération d'agents et de code. Des tests effectués par des tiers montrent que ses performances sur des tâches complexes — telles que le traitement de rapports de recherche approfondis, la gestion et l'invocation de compétences, ainsi que l'exécution du contrôle du système — ont atteint le niveau des modèles de pointe du secteur comportant des milliers de milliards de paramètres.
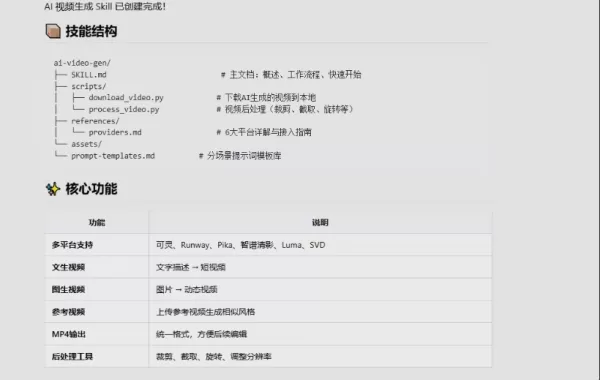
En matière de coût, un aspect important pour les développeurs, le Spark X2-Flash excelle. Lors de tests de flux de travail identiques, sa consommation de tokens n'est que d'un tiers de celle des grands modèles courants actuels, ce qui réduit considérablement les obstacles à la création d'applications d'agents complexes. Par exemple, lors de la création de compétences complexes de génération de vidéos, le modèle non seulement saisit rapidement les exigences, mais fournit également des explications détaillées couvrant la structure des compétences jusqu'aux fonctions de base.
Sur le plan technique, le Spark X2-Flash est le premier à combiner les techniques DSA (Sparse Attention) et MTP (Multi-Token Prediction) sur des puces nationales. Cette innovation résout le problème de la lenteur de l'entraînement sur des textes longs sur les plateformes informatiques nationales, multipliant par 4,5 l'efficacité de l'entraînement par rapport à des clusters de taille similaire. De plus, pour les scénarios d'apprentissage par renforcement avec agents, le modèle améliore l'efficacité de l'inférence par échantillonnage de plus de deux fois grâce à des optimisations combinées sur le plan algorithmique et technique, ce qui atténue efficacement les goulots d'étranglement de performance dans les scénarios d'interaction longues.
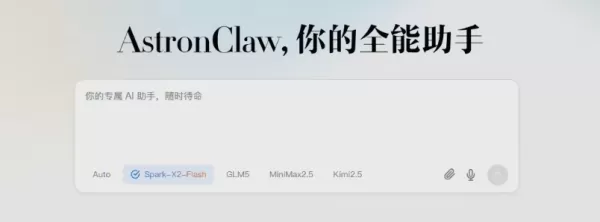
À l'heure actuelle, des applications telles qu'AstronClaw et Loomy ont été les premières à être intégrées. Le modèle s'aligne également étroitement sur les principaux frameworks d'agents internationaux tels qu'OpenClaw et Claude Code, offrant ainsi aux développeurs du monde entier une option de puissance de calcul nationale plus rentable.
Article connexe
 Stripe va acquérir OpenRouter alors que le routage basé sur des modèles d'IA prend de l'ampleur
Stripe a conclu un accord en vue d’acquérir OpenRouter, une plateforme de routage de modèles d’IA qui permet aux développeurs d’accéder à des centaines de modèles via une interface unique. Cette acqui
Barrett Zoph, ancien chercheur chez OpenAI, revient chez Google pour contribuer au développement de Gemini
Barret Zoph, qui avait auparavant quitté brusquement l’entreprise pour rejoindre OpenAI en raison d’un désaccord avec Miriam Mularati, PDG de Thinking Machines Lab, a une nouvelle fois changé d’employ
Comment Recursive Intelligence a levé 335 millions de dollars en 4 mois, avec une valorisation de 4 milliards de dollars
Les cofondatrices de la start-up Ricursive Intelligence semblaient destinées à devenir cofondatrices.Anna Goldie, PDG, et Azalia Mirhoseini, directrice technique, sont si connues dans le milieu de l’I
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (0)
Le 29 avril, iFLYTEK a officiellement lancé le nouveau modèle Spark X2-Flash et ouvert son interface API, marquant ainsi une nouvelle étape en matière d'efficacité pour les applications de grands modèles s'appuyant sur l'écosystème national de puissance de calcul.
Le modèle utilise l'architecture MoE (Mixture of Experts) couramment utilisée aujourd'hui, avec un total de 30 milliards de paramètres. Sa caractéristique principale est la prise en charge d'un contexte ultra-long pouvant atteindre 256K. Il convient de noter que le Spark X2-Flash a été entièrement entraîné sur le cluster Ascend 910B de Huawei, démontrant ainsi la synergie entre les logiciels et le matériel nationaux pour l'entraînement en apprentissage profond.
En termes de performances de base, le Spark X2-Flash offre des gains significatifs en matière de capacités de génération d'agents et de code. Des tests effectués par des tiers montrent que ses performances sur des tâches complexes — telles que le traitement de rapports de recherche approfondis, la gestion et l'invocation de compétences, ainsi que l'exécution du contrôle du système — ont atteint le niveau des modèles de pointe du secteur comportant des milliers de milliards de paramètres.
En matière de coût, un aspect important pour les développeurs, le Spark X2-Flash excelle. Lors de tests de flux de travail identiques, sa consommation de tokens n'est que d'un tiers de celle des grands modèles courants actuels, ce qui réduit considérablement les obstacles à la création d'applications d'agents complexes. Par exemple, lors de la création de compétences complexes de génération de vidéos, le modèle non seulement saisit rapidement les exigences, mais fournit également des explications détaillées couvrant la structure des compétences jusqu'aux fonctions de base.
Sur le plan technique, le Spark X2-Flash est le premier à combiner les techniques DSA (Sparse Attention) et MTP (Multi-Token Prediction) sur des puces nationales. Cette innovation résout le problème de la lenteur de l'entraînement sur des textes longs sur les plateformes informatiques nationales, multipliant par 4,5 l'efficacité de l'entraînement par rapport à des clusters de taille similaire. De plus, pour les scénarios d'apprentissage par renforcement avec agents, le modèle améliore l'efficacité de l'inférence par échantillonnage de plus de deux fois grâce à des optimisations combinées sur le plan algorithmique et technique, ce qui atténue efficacement les goulots d'étranglement de performance dans les scénarios d'interaction longues.
À l'heure actuelle, des applications telles qu'AstronClaw et Loomy ont été les premières à être intégrées. Le modèle s'aligne également étroitement sur les principaux frameworks d'agents internationaux tels qu'OpenClaw et Claude Code, offrant ainsi aux développeurs du monde entier une option de puissance de calcul nationale plus rentable.








 Stripe va acquérir OpenRouter alors que le routage basé sur des modèles d'IA prend de l'ampleur
Stripe a conclu un accord en vue d’acquérir OpenRouter, une plateforme de routage de modèles d’IA qui permet aux développeurs d’accéder à des centaines de modèles via une interface unique. Cette acqui
 Barrett Zoph, ancien chercheur chez OpenAI, revient chez Google pour contribuer au développement de Gemini
Barret Zoph, qui avait auparavant quitté brusquement l’entreprise pour rejoindre OpenAI en raison d’un désaccord avec Miriam Mularati, PDG de Thinking Machines Lab, a une nouvelle fois changé d’employ
 Comment Recursive Intelligence a levé 335 millions de dollars en 4 mois, avec une valorisation de 4 milliards de dollars
Les cofondatrices de la start-up Ricursive Intelligence semblaient destinées à devenir cofondatrices.Anna Goldie, PDG, et Azalia Mirhoseini, directrice technique, sont si connues dans le milieu de l’I

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai












