


 Hogar
El Xunfei Xinghuo X2-Flash sale al mercado con una potencia de cálculo local mejorada y compatibilidad con textos largos de 256 KB
El 29 de abril, iFLYTEK presentó oficialmente el nuevo modelo Spark X2-Flash y abrió su interfaz API, lo que supone un nuevo hito en materia de eficiencia para las aplicaciones de modelos a gran escala desarrolladas en el ecosistema nacional de potencia de cálculo.
El modelo utiliza la arquitectura MoE (Mixture of Experts) predominante en la actualidad, con un total de 30 000 millones de parámetros. Su característica más destacada es la compatibilidad con un contexto ultralargo de hasta 256K. Cabe destacar que el Spark X2-Flash se entrenó íntegramente en el clúster Ascend 910B de Huawei, lo que pone de manifiesto la sinergia entre el software y el hardware nacionales para el entrenamiento en aprendizaje profundo.
En cuanto al rendimiento básico, Spark X2-Flash ofrece mejoras significativas en las capacidades de generación de agentes y código. Las pruebas de terceros muestran que su rendimiento en tareas complejas —como el procesamiento de informes de investigación en profundidad, la gestión y activación de habilidades, y la ejecución del control del sistema— ha alcanzado el nivel de los modelos industriales de primer nivel con billones de parámetros.
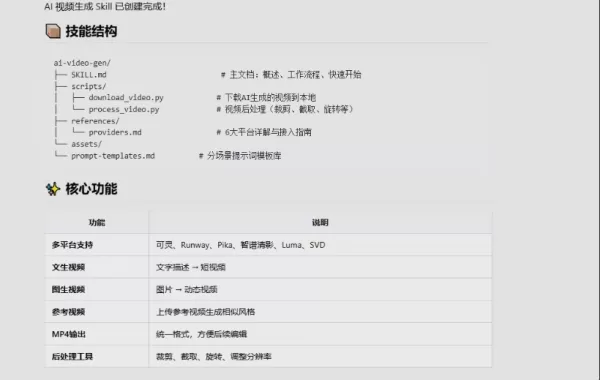
En cuanto al coste, algo que preocupa a los desarrolladores, el Spark X2-Flash destaca. En pruebas de flujos de trabajo idénticos, su consumo de tokens es solo un tercio del de los grandes modelos convencionales actuales, lo que reduce en gran medida la barrera para crear aplicaciones de agentes complejas. Por ejemplo, al crear habilidades complejas de generación de vídeo, el modelo no solo capta rápidamente los requisitos, sino que también ofrece explicaciones detalladas que abarcan desde la estructura de la habilidad hasta las funciones principales.
Técnicamente, Spark X2-Flash es el primero en combinar DSA (atención dispersa) y MTP (predicción multitoken) en chips nacionales. Esta innovación resuelve el problema de la lentitud del entrenamiento de textos largos en las plataformas informáticas nacionales, multiplicando por 4,5 la eficiencia del entrenamiento en comparación con clústeres de escala similar. Además, para escenarios de aprendizaje por refuerzo con agentes, el modelo mejora la eficiencia de la inferencia por muestreo en más del doble mediante optimizaciones combinadas de algoritmos e ingeniería, aliviando eficazmente los cuellos de botella de rendimiento en escenarios de interacción prolongada.
Actualmente, aplicaciones como AstronClaw y Loomy han sido las primeras en completar la integración. El modelo también se alinea profundamente con los marcos de agentes internacionales más destacados, como OpenClaw y Claude Code, ofreciendo a los desarrolladores de todo el mundo una opción de potencia de cálculo nacional más rentable.
Artículo relacionado
 Meta elimina la función de edición de fotos con IA tras las críticas de los usuarios
Meta, el gigante de los medios sociales, se ve una vez más envuelto en un debate público sobre el delicado equilibrio entre la inteligencia artificial y la privacidad de los usuarios. Según TechCrunch, Superintelligence Labs de Meta presentó un nuevo
CEO de DeepMind, Hassabis: Duermo seis horas al día y generalmente me siento con energía alrededor de la 1 a. m.
Fortune ha presentado recientemente una entrevista con Demis Hassabis, director ejecutivo de Google DeepMind, en la que revela su enfoque poco convencional para el descanso y la productividad. Hassabis ha revelado que duerme muy poco, estructurando s
OpenAI y Anthropic compiten por la cuota de mercado a pesar de la caída de los ingresos
A pesar de los recientes informes que sugieren que OpenAI no ha alcanzado sus objetivos de ingresos —lo que ha generado presión sobre las acciones tecnológicas este martes—, los inversores privados en
Recomendaciones de temas especiales relacionados
Creación de vídeos
 Generadores de ganchos para vídeos cortos basados en IA, para Reels, Shorts y campañas de lanzamiento de productos
¡Los mejores generadores de ganchos para vídeos cortos con IA de 2026 para Reels, Shorts y campañas de lanzamiento de productos! XIX.AI selecciona las herramientas más valoradas, potentes y revolucionarias que ofrecen resultados que no te puedes perder, contrastados mediante pruebas en el mundo real. Esta página, que se actualiza semanalmente, ofrece clasificaciones comparativas entre opciones gratuitas y de pago para ayudarte a encontrar la solución perfecta con la que potenciar la creatividad y la productividad en la creación de contenidos. ¡Explórala ahora y descubre tu ventaja con la IA!
 11 herramientas
 xix.ai
escribiendo
Herramientas de IA para la estructura de artículos en la redacción de textos extensos
¡Las mejores herramientas de 2026 para crear esquemas de artículos con IA, mejor valoradas para la redacción de textos largos! Esta selección incluye potentes herramientas revolucionarias que ofrecen esquemas precisos y estructurados, probados en la práctica, para aumentar significativamente la eficiencia en la redacción. XIX.AI forma parte de esta selección de élite. Consigue una comparación entre las versiones gratuitas y de pago que te ayudará a elegir la herramienta perfecta. ¡Explora ahora y aprovecha tu ventaja con la IA!
9 herramientas
xix.ai
chatbot
Las mejores aplicaciones de chat de roleplay con IA para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria
¡Las mejores aplicaciones de chat de roleplay con IA de 2026, mejor valoradas, para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria! XIX.AI selecciona una poderosa colección revolucionaria que ofrece comparaciones entre versiones gratuitas y de pago, pruebas del mundo real y clasificaciones actualizadas semanalmente. Estas herramientas imprescindibles te ayudan a mejorar tus habilidades de escritura, superar los desafíos de fluidez y aumentar la eficiencia comunicativa en todas las situaciones cotidianas. ¡Explora ahora para descubrir tu herramienta perfecta para el crecimiento lingüístico!
10 herramientas
xix.ai
composicion musical
Herramientas de separación de pistas con IA para la producción de remezclas, la preparación de samples y las pistas maestras de karaoke
Las mejores herramientas de separación de pistas con IA de 2026, seleccionadas para la producción de remixes, la preparación de samples y la creación de temas de karaoke. Estas potentes herramientas revolucionarias se han sometido a pruebas en condiciones reales para ofrecer un aislamiento de audio preciso, lo que aumenta significativamente la productividad. XIX.AI ofrece una guía comparativa entre versiones gratuitas y de pago, actualizada semanalmente, para ayudarte a encontrar la solución imprescindible que mejor se adapte a tus necesidades. Explórala ahora para sacar el máximo partido a la IA.
8 herramientas
xix.ai
Análisis de datos
Copilotos de AI para SQL destinados a paneles de ingresos, análisis de embudos y métricas de productos
¡Los mejores copilotos de SQL basados en IA de 2026, clasificados entre los más destacados! XIX.AI reúne una poderosa colección que evoluciona constantemente, con pruebas en el mundo real actualizadas semanalmente. Estas herramientas indispensables le permiten generar paneles de control de ingresos precisos, analizar los canales de venta y seguir de cerca las métricas de los productos de manera rápida, lo que aumenta significativamente su productividad. ¡Explórelas ahora para encontrar la herramienta perfecta para tomar decisiones basadas en datos! 238 caracteres
9 herramientas
xix.ai
composicion musical
Mejores herramientas de IA para escribir melodías en borradores de canciones
2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai

 comentario (0)
0/500
El 29 de abril, iFLYTEK presentó oficialmente el nuevo modelo Spark X2-Flash y abrió su interfaz API, lo que supone un nuevo hito en materia de eficiencia para las aplicaciones de modelos a gran escala desarrolladas en el ecosistema nacional de potencia de cálculo.
El modelo utiliza la arquitectura MoE (Mixture of Experts) predominante en la actualidad, con un total de 30 000 millones de parámetros. Su característica más destacada es la compatibilidad con un contexto ultralargo de hasta 256K. Cabe destacar que el Spark X2-Flash se entrenó íntegramente en el clúster Ascend 910B de Huawei, lo que pone de manifiesto la sinergia entre el software y el hardware nacionales para el entrenamiento en aprendizaje profundo.
En cuanto al rendimiento básico, Spark X2-Flash ofrece mejoras significativas en las capacidades de generación de agentes y código. Las pruebas de terceros muestran que su rendimiento en tareas complejas —como el procesamiento de informes de investigación en profundidad, la gestión y activación de habilidades, y la ejecución del control del sistema— ha alcanzado el nivel de los modelos industriales de primer nivel con billones de parámetros.
En cuanto al coste, algo que preocupa a los desarrolladores, el Spark X2-Flash destaca. En pruebas de flujos de trabajo idénticos, su consumo de tokens es solo un tercio del de los grandes modelos convencionales actuales, lo que reduce en gran medida la barrera para crear aplicaciones de agentes complejas. Por ejemplo, al crear habilidades complejas de generación de vídeo, el modelo no solo capta rápidamente los requisitos, sino que también ofrece explicaciones detalladas que abarcan desde la estructura de la habilidad hasta las funciones principales.
Técnicamente, Spark X2-Flash es el primero en combinar DSA (atención dispersa) y MTP (predicción multitoken) en chips nacionales. Esta innovación resuelve el problema de la lentitud del entrenamiento de textos largos en las plataformas informáticas nacionales, multiplicando por 4,5 la eficiencia del entrenamiento en comparación con clústeres de escala similar. Además, para escenarios de aprendizaje por refuerzo con agentes, el modelo mejora la eficiencia de la inferencia por muestreo en más del doble mediante optimizaciones combinadas de algoritmos e ingeniería, aliviando eficazmente los cuellos de botella de rendimiento en escenarios de interacción prolongada.
Actualmente, aplicaciones como AstronClaw y Loomy han sido las primeras en completar la integración. El modelo también se alinea profundamente con los marcos de agentes internacionales más destacados, como OpenClaw y Claude Code, ofreciendo a los desarrolladores de todo el mundo una opción de potencia de cálculo nacional más rentable.








 Meta elimina la función de edición de fotos con IA tras las críticas de los usuarios
Meta, el gigante de los medios sociales, se ve una vez más envuelto en un debate público sobre el delicado equilibrio entre la inteligencia artificial y la privacidad de los usuarios. Según TechCrunch, Superintelligence Labs de Meta presentó un nuevo
 CEO de DeepMind, Hassabis: Duermo seis horas al día y generalmente me siento con energía alrededor de la 1 a. m.
Fortune ha presentado recientemente una entrevista con Demis Hassabis, director ejecutivo de Google DeepMind, en la que revela su enfoque poco convencional para el descanso y la productividad. Hassabis ha revelado que duerme muy poco, estructurando s
 OpenAI y Anthropic compiten por la cuota de mercado a pesar de la caída de los ingresos
A pesar de los recientes informes que sugieren que OpenAI no ha alcanzado sus objetivos de ingresos —lo que ha generado presión sobre las acciones tecnológicas este martes—, los inversores privados en

¡Los mejores generadores de ganchos para vídeos cortos con IA de 2026 para Reels, Shorts y campañas de lanzamiento de productos! XIX.AI selecciona las herramientas más valoradas, potentes y revolucionarias que ofrecen resultados que no te puedes perder, contrastados mediante pruebas en el mundo real. Esta página, que se actualiza semanalmente, ofrece clasificaciones comparativas entre opciones gratuitas y de pago para ayudarte a encontrar la solución perfecta con la que potenciar la creatividad y la productividad en la creación de contenidos. ¡Explórala ahora y descubre tu ventaja con la IA!
11 herramientas
xix.ai

¡Las mejores herramientas de 2026 para crear esquemas de artículos con IA, mejor valoradas para la redacción de textos largos! Esta selección incluye potentes herramientas revolucionarias que ofrecen esquemas precisos y estructurados, probados en la práctica, para aumentar significativamente la eficiencia en la redacción. XIX.AI forma parte de esta selección de élite. Consigue una comparación entre las versiones gratuitas y de pago que te ayudará a elegir la herramienta perfecta. ¡Explora ahora y aprovecha tu ventaja con la IA!
9 herramientas
xix.ai

¡Las mejores aplicaciones de chat de roleplay con IA de 2026, mejor valoradas, para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria! XIX.AI selecciona una poderosa colección revolucionaria que ofrece comparaciones entre versiones gratuitas y de pago, pruebas del mundo real y clasificaciones actualizadas semanalmente. Estas herramientas imprescindibles te ayudan a mejorar tus habilidades de escritura, superar los desafíos de fluidez y aumentar la eficiencia comunicativa en todas las situaciones cotidianas. ¡Explora ahora para descubrir tu herramienta perfecta para el crecimiento lingüístico!
10 herramientas
xix.ai

Las mejores herramientas de separación de pistas con IA de 2026, seleccionadas para la producción de remixes, la preparación de samples y la creación de temas de karaoke. Estas potentes herramientas revolucionarias se han sometido a pruebas en condiciones reales para ofrecer un aislamiento de audio preciso, lo que aumenta significativamente la productividad. XIX.AI ofrece una guía comparativa entre versiones gratuitas y de pago, actualizada semanalmente, para ayudarte a encontrar la solución imprescindible que mejor se adapte a tus necesidades. Explórala ahora para sacar el máximo partido a la IA.
8 herramientas
xix.ai

¡Los mejores copilotos de SQL basados en IA de 2026, clasificados entre los más destacados! XIX.AI reúne una poderosa colección que evoluciona constantemente, con pruebas en el mundo real actualizadas semanalmente. Estas herramientas indispensables le permiten generar paneles de control de ingresos precisos, analizar los canales de venta y seguir de cerca las métricas de los productos de manera rápida, lo que aumenta significativamente su productividad. ¡Explórelas ahora para encontrar la herramienta perfecta para tomar decisiones basadas en datos! 238 caracteres
9 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai












