


 Дом
Tencent представляет OpenSearch-VL: мультимодальный агент глубокого поиска с открытым исходным кодом
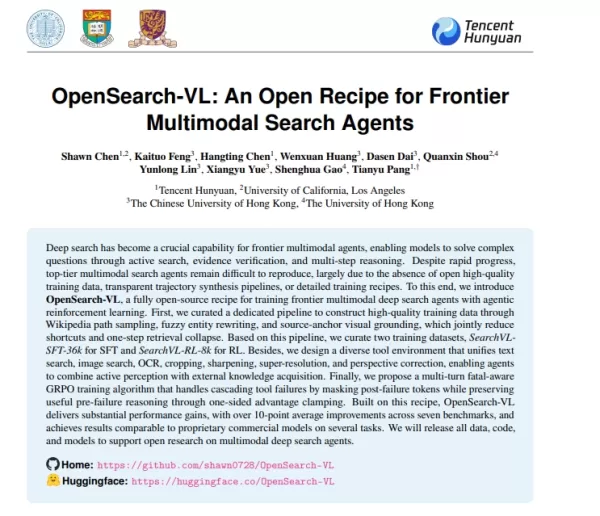
По мере стремительного развития мультимодальных крупных языковых моделей (MLLM) ключевая задача в области искусственного интеллекта смещается от простого «пассивного понимания изображений» к активному поиску доказательств и построению логических выводов. Однако отсутствие высококачественных обучающих данных, автоматизированных конвейеров синтеза траекторий и подробных инструкций по обучению затрудняет сообществу открытого исходного кода воспроизведение мультимодальных поисковых агентов высшего уровня.
Чтобы преодолеть это препятствие, исследовательская группа из Tencent Hunyuan совместно с Калифорнийским университетом в Лос-Анджелесе (UCLA) и Китайским университетом Гонконга запустила проект OpenSearch-VL. Эта полностью открытая архитектура открывает путь к созданию передового агента глубокого поиска с помощью обучения с подкреплением (RL).
Инновационный конвейер данных преодолевает «упрощения» в поиске
Команда определила, что основным препятствием для совершенствования моделей является нехватка высококачественных обучающих данных. Чтобы обучить модели многошаговому рассуждению — выходящему за рамки простого распознавания изображений одним щелчком — они разработали тщательно продуманный конвейер консолидации данных.
Этот конвейер отбирает пути из графа гиперссылок Википедии, преобразуя сложные отношения между сущностями в пары «вопрос-ответ» с несколькими промежуточными шагами. Чтобы предотвратить обучение с использованием «ярлыков», исследователи применили нечеткое переформулирование сущностей для сокрытия прямых ответов и интегрировали визуальную локализацию, привязанную к исходному коду. Такой подход заставляет модель сначала обнаруживать визуальные сигналы, а затем итеративно извлекать информацию с помощью внешних инструментов, предотвращая снижение качества навыков во время поиска. В результате команда создала базу данных SearchVL-SFT (36 000 траекторий тонкой настройки с инструкциями) и базу данных SearchVL-RL (8 000 траекторий обучения с подкреплением).
Универсальный набор инструментов, выходящий за рамки простого поиска
OpenSearch-VL выходит за рамки базового текстового поиска. В реальных условиях изображения, предоставляемые пользователями, часто бывают размытыми, искажёнными или имеют низкое разрешение, что делает традиционные поисковые инструменты неэффективными.
Чтобы решить эту проблему, в проект включен обширный набор инструментов: веб-поиск, обратный поиск по изображению, OCR, кадрирование изображений, повышение резкости, суперразрешение и коррекция перспективы. Агент активно распознает и исправляет несовершенные изображения — во многом как человек — перед тем, как запрашивать внешние знания, что обеспечивает надежность последующих поисков.
Алгоритм с учетом ошибок позволяет учиться на ошибках
В задачах с длительным горизонтом выполнения вызовы инструментов могут приводить к каскадным сбоям. Один-единственный таймаут или ошибка может сорвать выполнение всей задачи. Традиционное обучение с обратной связью (RL) часто отбрасывает такие неудачные траектории, что приводит к растрате ресурсов обучения.
OpenSearch-VL представляет Multi-round Fault-Aware GRPO — алгоритм обучения, который выявляет критические точки сбоев при вызовах инструментов. Он использует маскирование для отфильтровывания недействительной информации, полученной после сбоя, и применяет одностороннее ограничение преимущества, чтобы сохранить полезную логику из предыдущих шагов. Таким образом, даже если конечным результатом становится сбой, модель всё равно обучается эффективным путям поиска и стратегиям исследования на основе предыдущих этапов.
Результаты экспериментов сопоставимы с коммерческими проприетарными моделями
Результаты оценки демонстрируют высокую производительность в семи основных тестах мультимодального глубокого поиска, при этом среднее улучшение превышает 10 процентных пунктов. По некоторым конкретным задачам OpenSearch-VL уже не уступает ведущим коммерческим моделям с закрытым исходным кодом.
Команда планирует полностью открыть исходный код всех обучающих данных, кода и весов модели OpenSearch-VL, предоставив разработчикам по всему миру воспроизводимую и поддающуюся усовершенствованию основу, которая позволит продвинуть исследования в области мультимодальных агентов на более глубокий уровень.
Статья: https://arxiv.org/pdf/2605.05185
Связанная статья
 Умные очки Apple могут быть представлены на WWDC27 с акцентом на защиту конфиденциальности
Журналист Bloomberg Марк Гурман сообщает, что умные очки Apple под кодовым названием N50 должны дебютировать на WWDC27 в июне 2027 года, а их розничные продажи ожидаются осенью 2027 года. Изначально выпуск устройства планировался на конец этого года
Внутри раскрыты подробности о Gemini следующего поколения: ограниченные вычислительные мощности, внутренние команды не сошлись в вопросах приоритетов разработки и распределения ресурсов
В отчётах указывается, что запуск долгожданной модели Gemini следующего поколения от Google был перенесён. Внутренние разногласия по вопросам приоритетов разработки и распределения ресурсов, в сочетании с ограниченной вычислительной мощностью и сложн
OpenAI отклоняет опасения по поводу замедления роста, заявляя о ускорении работы нескольких бизнес-подразделений
В ответ на внешнюю критику, связанную с замедлением роста продаж и невыполнением внутренних плановых показателей, лидер в области искусственного интеллекта компания OpenAI опубликовала во вторник, 28 апреля, уверенное заявление. Компания уточнила, чт
Рекомендации по связанным специальным темам
Музыкальная композиция
 Лучшие инструменты для написания мелодий с помощью ИИ для черновиков песен
2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
 8 инструментов
 xix.ai
чат-бот
Лучшие инструменты для тренировки разговоров с помощью ИИ для подготовки к собеседованиям
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai
Дизайн и искусство
Лучшие инструменты для переноса стилей с помощью ИИ для творческих экспериментов
2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai
Создание комиксов
Лучшие инструменты для создания диалоговых пузырей с помощью ИИ для визуального повествования
2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai
Помощник по встречам
Лучшие инструменты для составления отчетов о встречах с использованием ИИ: четкое отслеживание решений и последующих действий
2026: Последние версии лучших инструментов для составления отчетов о встречах с помощью ИИ, обеспечивающих четкое отслеживание решений и удобное выполнение последующих действий. В этом тщательно подобранном списке представлены мощные, революционные решения, которые значительно повышают продуктивность за счет автоматизации ведения протоколов встреч, выявления ключевых задач и оптимизации координации работы команды по всем проектам. Получите сравнение бесплатных и платных версий, а также результаты реальных тестов и еженедельно обновляемые рейтинги, которые помогут вам найти идеальный инструмент. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть потенциал искусственного интеллекта!
9 инструментов
xix.ai
Анализ данных
Лучшие инструменты для очистки данных с использованием ИИ: быстрое устранение пропущенных значений и дубликатов
2026 год: лучшие и наиболее высоко оценённые инструменты для очистки данных с ИИ, предназначенные для быстрого устранения пропущенных значений и дубликатов. В этом тщательно отобранном списке представлены мощные решения, способные кардинально повысить производительность. Каждый инструмент прошёл строгие тестирования в реальных условиях для обеспечения надёжности. Получите бесплатное сравнение версий с платной и найдите инструмент, который наилучшим образом соответствует вашим потребностям. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть полный потенциал работы с ИИ.
11 инструментов
xix.ai

 Комментарии (0)
По мере стремительного развития мультимодальных крупных языковых моделей (MLLM) ключевая задача в области искусственного интеллекта смещается от простого «пассивного понимания изображений» к активному поиску доказательств и построению логических выводов. Однако отсутствие высококачественных обучающих данных, автоматизированных конвейеров синтеза траекторий и подробных инструкций по обучению затрудняет сообществу открытого исходного кода воспроизведение мультимодальных поисковых агентов высшего уровня.
Чтобы преодолеть это препятствие, исследовательская группа из Tencent Hunyuan совместно с Калифорнийским университетом в Лос-Анджелесе (UCLA) и Китайским университетом Гонконга запустила проект OpenSearch-VL. Эта полностью открытая архитектура открывает путь к созданию передового агента глубокого поиска с помощью обучения с подкреплением (RL).
Инновационный конвейер данных преодолевает «упрощения» в поиске
Команда определила, что основным препятствием для совершенствования моделей является нехватка высококачественных обучающих данных. Чтобы обучить модели многошаговому рассуждению — выходящему за рамки простого распознавания изображений одним щелчком — они разработали тщательно продуманный конвейер консолидации данных.
Этот конвейер отбирает пути из графа гиперссылок Википедии, преобразуя сложные отношения между сущностями в пары «вопрос-ответ» с несколькими промежуточными шагами. Чтобы предотвратить обучение с использованием «ярлыков», исследователи применили нечеткое переформулирование сущностей для сокрытия прямых ответов и интегрировали визуальную локализацию, привязанную к исходному коду. Такой подход заставляет модель сначала обнаруживать визуальные сигналы, а затем итеративно извлекать информацию с помощью внешних инструментов, предотвращая снижение качества навыков во время поиска. В результате команда создала базу данных SearchVL-SFT (36 000 траекторий тонкой настройки с инструкциями) и базу данных SearchVL-RL (8 000 траекторий обучения с подкреплением).
Универсальный набор инструментов, выходящий за рамки простого поиска
OpenSearch-VL выходит за рамки базового текстового поиска. В реальных условиях изображения, предоставляемые пользователями, часто бывают размытыми, искажёнными или имеют низкое разрешение, что делает традиционные поисковые инструменты неэффективными.
Чтобы решить эту проблему, в проект включен обширный набор инструментов: веб-поиск, обратный поиск по изображению, OCR, кадрирование изображений, повышение резкости, суперразрешение и коррекция перспективы. Агент активно распознает и исправляет несовершенные изображения — во многом как человек — перед тем, как запрашивать внешние знания, что обеспечивает надежность последующих поисков.
Алгоритм с учетом ошибок позволяет учиться на ошибках
В задачах с длительным горизонтом выполнения вызовы инструментов могут приводить к каскадным сбоям. Один-единственный таймаут или ошибка может сорвать выполнение всей задачи. Традиционное обучение с обратной связью (RL) часто отбрасывает такие неудачные траектории, что приводит к растрате ресурсов обучения.
OpenSearch-VL представляет Multi-round Fault-Aware GRPO — алгоритм обучения, который выявляет критические точки сбоев при вызовах инструментов. Он использует маскирование для отфильтровывания недействительной информации, полученной после сбоя, и применяет одностороннее ограничение преимущества, чтобы сохранить полезную логику из предыдущих шагов. Таким образом, даже если конечным результатом становится сбой, модель всё равно обучается эффективным путям поиска и стратегиям исследования на основе предыдущих этапов.
Результаты экспериментов сопоставимы с коммерческими проприетарными моделями
Результаты оценки демонстрируют высокую производительность в семи основных тестах мультимодального глубокого поиска, при этом среднее улучшение превышает 10 процентных пунктов. По некоторым конкретным задачам OpenSearch-VL уже не уступает ведущим коммерческим моделям с закрытым исходным кодом.
Команда планирует полностью открыть исходный код всех обучающих данных, кода и весов модели OpenSearch-VL, предоставив разработчикам по всему миру воспроизводимую и поддающуюся усовершенствованию основу, которая позволит продвинуть исследования в области мультимодальных агентов на более глубокий уровень.
Статья: https://arxiv.org/pdf/2605.05185








 Умные очки Apple могут быть представлены на WWDC27 с акцентом на защиту конфиденциальности
Журналист Bloomberg Марк Гурман сообщает, что умные очки Apple под кодовым названием N50 должны дебютировать на WWDC27 в июне 2027 года, а их розничные продажи ожидаются осенью 2027 года. Изначально выпуск устройства планировался на конец этого года
 Внутри раскрыты подробности о Gemini следующего поколения: ограниченные вычислительные мощности, внутренние команды не сошлись в вопросах приоритетов разработки и распределения ресурсов
В отчётах указывается, что запуск долгожданной модели Gemini следующего поколения от Google был перенесён. Внутренние разногласия по вопросам приоритетов разработки и распределения ресурсов, в сочетании с ограниченной вычислительной мощностью и сложн
 OpenAI отклоняет опасения по поводу замедления роста, заявляя о ускорении работы нескольких бизнес-подразделений
В ответ на внешнюю критику, связанную с замедлением роста продаж и невыполнением внутренних плановых показателей, лидер в области искусственного интеллекта компания OpenAI опубликовала во вторник, 28 апреля, уверенное заявление. Компания уточнила, чт

2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai

2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai

2026: Последние версии лучших инструментов для составления отчетов о встречах с помощью ИИ, обеспечивающих четкое отслеживание решений и удобное выполнение последующих действий. В этом тщательно подобранном списке представлены мощные, революционные решения, которые значительно повышают продуктивность за счет автоматизации ведения протоколов встреч, выявления ключевых задач и оптимизации координации работы команды по всем проектам. Получите сравнение бесплатных и платных версий, а также результаты реальных тестов и еженедельно обновляемые рейтинги, которые помогут вам найти идеальный инструмент. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть потенциал искусственного интеллекта!
9 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые инструменты для очистки данных с ИИ, предназначенные для быстрого устранения пропущенных значений и дубликатов. В этом тщательно отобранном списке представлены мощные решения, способные кардинально повысить производительность. Каждый инструмент прошёл строгие тестирования в реальных условиях для обеспечения надёжности. Получите бесплатное сравнение версий с платной и найдите инструмент, который наилучшим образом соответствует вашим потребностям. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть полный потенциал работы с ИИ.
11 инструментов
xix.ai












