


 Heim
Tencent stellt OpenSearch-VL vor: einen Open-Source-Agenten für multimodale Deep-Search-Anwendungen
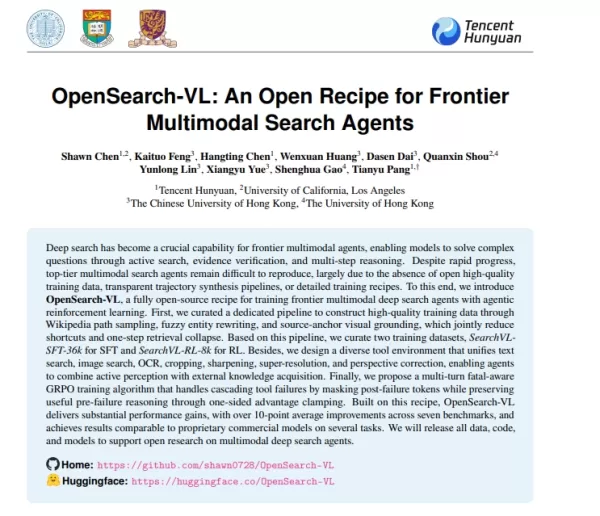
Angesichts der rasanten Weiterentwicklung multimodaler großer Sprachmodelle (MLLMs) verlagert sich die zentrale Herausforderung im KI-Wettbewerb vom bloßen „passiven Verstehen von Bildern“ hin zum aktiven Suchen nach Belegen und zum Schlussfolgern. Doch der Mangel an hochwertigen Trainingsdaten, automatisierten Pipelines zur Trajektoriensynthese und detaillierten Trainingsanleitungen hat es der Open-Source-Community erschwert, multimodale Suchagenten der Spitzenklasse nachzubilden.
Um diesen Engpass zu überwinden, hat ein Forschungsteam von Tencent Hunyuan gemeinsam mit der UCLA und der Chinese University of Hong Kong OpenSearch-VL ins Leben gerufen. Dieser vollständig quelloffene Entwurf bietet einen Weg zum Aufbau eines hochmodernen Deep-Search-Agenten mittels bestärkendem Lernen (RL).
Innovative Datenpipeline überwindet Suchabkürzungen
Das Team identifizierte hochwertige Trainingsdaten als den primären Engpass für die Weiterentwicklung von Modellen. Um Modelle für mehrstufiges Schlussfolgern zu trainieren – über die einfache Bilderkennung per Mausklick hinaus –, entwarf es eine sorgfältig durchdachte Pipeline zur Datenkonsolidierung.
Diese Pipeline entnimmt Stichproben aus dem Hyperlink-Graphen von Wikipedia und wandelt komplexe Entitätsbeziehungen in Multi-Hop-Frage-Antwort-Paare um. Um das Lernen von Abkürzungen zu verhindern, wandten die Forscher eine unscharfe Entitätsumschreibung an, um direkte Antworten zu verbergen, und integrierten eine am Quellcode verankerte visuelle Lokalisierung. Dieser Ansatz zwingt das Modell dazu, zunächst visuelle Signale zu erkennen und anschließend Informationen mithilfe externer Tools iterativ abzurufen, wodurch ein Leistungsabfall während des Abrufs verhindert wird. Als Ergebnis erstellte das Team die SearchVL-SFT-Datenbank (36.000 Feinabstimmungsverläufe anhand von Anweisungen) und die SearchVL-RL-Datenbank (8.000 Verläufe des verstärkenden Lernens).
Vielseitiges Toolset, das über die einfache Suche hinausgeht
OpenSearch-VL geht über die einfache Textsuche hinaus. In der Praxis sind von Nutzern bereitgestellte Bilder oft unscharf, verzerrt oder haben eine geringe Auflösung, wodurch herkömmliche Suchwerkzeuge unwirksam werden.
Um diesem Problem zu begegnen, umfasst das Projekt eine umfangreiche Palette an Werkzeugen: Websuche, umgekehrte Bildersuche, OCR, Bildzuschnitt, Schärfung, Superauflösung und Perspektivkorrektur. Der Agent erkennt und korrigiert unvollkommene Bilddaten aktiv – ähnlich wie ein Mensch –, bevor er externes Wissen abfragt, und gewährleistet so zuverlässige nachfolgende Suchvorgänge.
Fehlerbewusster Algorithmus ermöglicht das Lernen aus Fehlern
Bei Aufgaben mit langem Zeithorizont können Tool-Aufrufe kaskadierende Fehler verursachen. Ein einziges Timeout oder ein einziger Fehler kann die gesamte Aufgabe zum Scheitern bringen. Herkömmliches RL verwirft diese fehlgeschlagenen Verläufe oft, wodurch Trainingsressourcen verschwendet werden.
OpenSearch-VL führt „Multi-round Fault-Aware GRPO“ ein, einen Trainingsalgorithmus, der kritische Fehlerpunkte bei Tool-Aufrufen identifiziert. Er nutzt Maskierung, um ungültige Informationen nach einem Fehler herauszufiltern, und wendet einseitiges Advantage-Clipping an, um nützliche Logik aus früheren Schritten zu bewahren. Auf diese Weise lernt das Modell selbst bei einem endgültigen Fehlschlag aus den vorangegangenen Phasen effektive Suchpfade und Erkundungsstrategien.
Experimentelle Ergebnisse konkurrieren mit kommerziellen proprietären Modellen
Die Auswertungsergebnisse belegen eine starke Leistung bei sieben gängigen Benchmarks für multimodale Deep-Search-Verfahren, wobei die durchschnittliche Verbesserung 10 Prozentpunkte übersteigt. Bei bestimmten spezifischen Aufgaben erreicht OpenSearch-VL bereits das Niveau der führenden kommerziellen Closed-Source-Modelle.
Das Team plant, alle Trainingsdaten, den Code und die Modellgewichte für OpenSearch-VL vollständig als Open Source zur Verfügung zu stellen und bietet Entwicklern weltweit damit eine reproduzierbare und verbesserungsfähige Grundlage, die die Forschung zu multimodalen Agenten in tiefere Bereiche vorantreibt.
Artikel: https://arxiv.org/pdf/2605.05185
Verwandter Artikel
 Inside Details Exposed About Next-Gen Gemini: Strained Computing Power, Internal Teams Disagreed on Development Priorities and Resource Allocation
Berichten zufolge wurde der Start des hocherwarteten Next-Generation-Gemini-Modells von Google verschoben. Interne Uneinigkeiten über Entwicklungsprioritäten und Ressourcenallokation, kombiniert mit begrenzter Rechenkapazität und komplexen Genehmigun
OpenAI entkräftet Bedenken bezüglich des verlangsamen Wachstums und erklärt, dass mehrere Geschäftsbereiche ihre Expansion beschleunigen
Als Reaktion auf externe Kritik bezüglich des nachlassenden Umsatzwachstums und verpasster interner Zielvorgaben gab der KI-Pionier OpenAI am Dienstag, den 28. April, eine selbstbewusste Erklärung ab. Das Unternehmen präzisierte, dass seine Verbrauch
Alibaba Super Cup: Qwen3.8-Max debütiert mit verbesserten Coding- und Bürotools
Alibaba hat offiziell Qwen3.8-Max vorgestellt, ein hochmodernes Foundation-Modell mit 2,4 Billionen Parametern. Diese bedeutende KI-Entwicklung bietet erhebliche Leistungssteigerungen in Kernbereichen wie Programmierung und professionelle Büroaufgabe
Empfehlungen zu verwandten Spezialthemen
Musikkomposition
 Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
 8 Tools
 xix.ai
Chatbot
Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai
Design & Kunst
Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai
Comic-Erstellung
Die besten KI-Tools für Sprechblasen zum visuellen Geschichtenerzählen
Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai
Besprechungsassistent
Die besten Tools zur Zusammenfassung von KI-Meetings: Entscheidungen und Folgemaßnahmen übersichtlich nachverfolgen
Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai
Datenanalyse
Die besten Tools für die KI-gestützte Datenreinigung: Fehlende Werte und Duplikate schnell beheben
2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai

 Kommentare (0)
Angesichts der rasanten Weiterentwicklung multimodaler großer Sprachmodelle (MLLMs) verlagert sich die zentrale Herausforderung im KI-Wettbewerb vom bloßen „passiven Verstehen von Bildern“ hin zum aktiven Suchen nach Belegen und zum Schlussfolgern. Doch der Mangel an hochwertigen Trainingsdaten, automatisierten Pipelines zur Trajektoriensynthese und detaillierten Trainingsanleitungen hat es der Open-Source-Community erschwert, multimodale Suchagenten der Spitzenklasse nachzubilden.
Um diesen Engpass zu überwinden, hat ein Forschungsteam von Tencent Hunyuan gemeinsam mit der UCLA und der Chinese University of Hong Kong OpenSearch-VL ins Leben gerufen. Dieser vollständig quelloffene Entwurf bietet einen Weg zum Aufbau eines hochmodernen Deep-Search-Agenten mittels bestärkendem Lernen (RL).
Innovative Datenpipeline überwindet Suchabkürzungen
Das Team identifizierte hochwertige Trainingsdaten als den primären Engpass für die Weiterentwicklung von Modellen. Um Modelle für mehrstufiges Schlussfolgern zu trainieren – über die einfache Bilderkennung per Mausklick hinaus –, entwarf es eine sorgfältig durchdachte Pipeline zur Datenkonsolidierung.
Diese Pipeline entnimmt Stichproben aus dem Hyperlink-Graphen von Wikipedia und wandelt komplexe Entitätsbeziehungen in Multi-Hop-Frage-Antwort-Paare um. Um das Lernen von Abkürzungen zu verhindern, wandten die Forscher eine unscharfe Entitätsumschreibung an, um direkte Antworten zu verbergen, und integrierten eine am Quellcode verankerte visuelle Lokalisierung. Dieser Ansatz zwingt das Modell dazu, zunächst visuelle Signale zu erkennen und anschließend Informationen mithilfe externer Tools iterativ abzurufen, wodurch ein Leistungsabfall während des Abrufs verhindert wird. Als Ergebnis erstellte das Team die SearchVL-SFT-Datenbank (36.000 Feinabstimmungsverläufe anhand von Anweisungen) und die SearchVL-RL-Datenbank (8.000 Verläufe des verstärkenden Lernens).
Vielseitiges Toolset, das über die einfache Suche hinausgeht
OpenSearch-VL geht über die einfache Textsuche hinaus. In der Praxis sind von Nutzern bereitgestellte Bilder oft unscharf, verzerrt oder haben eine geringe Auflösung, wodurch herkömmliche Suchwerkzeuge unwirksam werden.
Um diesem Problem zu begegnen, umfasst das Projekt eine umfangreiche Palette an Werkzeugen: Websuche, umgekehrte Bildersuche, OCR, Bildzuschnitt, Schärfung, Superauflösung und Perspektivkorrektur. Der Agent erkennt und korrigiert unvollkommene Bilddaten aktiv – ähnlich wie ein Mensch –, bevor er externes Wissen abfragt, und gewährleistet so zuverlässige nachfolgende Suchvorgänge.
Fehlerbewusster Algorithmus ermöglicht das Lernen aus Fehlern
Bei Aufgaben mit langem Zeithorizont können Tool-Aufrufe kaskadierende Fehler verursachen. Ein einziges Timeout oder ein einziger Fehler kann die gesamte Aufgabe zum Scheitern bringen. Herkömmliches RL verwirft diese fehlgeschlagenen Verläufe oft, wodurch Trainingsressourcen verschwendet werden.
OpenSearch-VL führt „Multi-round Fault-Aware GRPO“ ein, einen Trainingsalgorithmus, der kritische Fehlerpunkte bei Tool-Aufrufen identifiziert. Er nutzt Maskierung, um ungültige Informationen nach einem Fehler herauszufiltern, und wendet einseitiges Advantage-Clipping an, um nützliche Logik aus früheren Schritten zu bewahren. Auf diese Weise lernt das Modell selbst bei einem endgültigen Fehlschlag aus den vorangegangenen Phasen effektive Suchpfade und Erkundungsstrategien.
Experimentelle Ergebnisse konkurrieren mit kommerziellen proprietären Modellen
Die Auswertungsergebnisse belegen eine starke Leistung bei sieben gängigen Benchmarks für multimodale Deep-Search-Verfahren, wobei die durchschnittliche Verbesserung 10 Prozentpunkte übersteigt. Bei bestimmten spezifischen Aufgaben erreicht OpenSearch-VL bereits das Niveau der führenden kommerziellen Closed-Source-Modelle.
Das Team plant, alle Trainingsdaten, den Code und die Modellgewichte für OpenSearch-VL vollständig als Open Source zur Verfügung zu stellen und bietet Entwicklern weltweit damit eine reproduzierbare und verbesserungsfähige Grundlage, die die Forschung zu multimodalen Agenten in tiefere Bereiche vorantreibt.
Artikel: https://arxiv.org/pdf/2605.05185








 Inside Details Exposed About Next-Gen Gemini: Strained Computing Power, Internal Teams Disagreed on Development Priorities and Resource Allocation
Berichten zufolge wurde der Start des hocherwarteten Next-Generation-Gemini-Modells von Google verschoben. Interne Uneinigkeiten über Entwicklungsprioritäten und Ressourcenallokation, kombiniert mit begrenzter Rechenkapazität und komplexen Genehmigun
 OpenAI entkräftet Bedenken bezüglich des verlangsamen Wachstums und erklärt, dass mehrere Geschäftsbereiche ihre Expansion beschleunigen
Als Reaktion auf externe Kritik bezüglich des nachlassenden Umsatzwachstums und verpasster interner Zielvorgaben gab der KI-Pionier OpenAI am Dienstag, den 28. April, eine selbstbewusste Erklärung ab. Das Unternehmen präzisierte, dass seine Verbrauch
 Alibaba Super Cup: Qwen3.8-Max debütiert mit verbesserten Coding- und Bürotools
Alibaba hat offiziell Qwen3.8-Max vorgestellt, ein hochmodernes Foundation-Modell mit 2,4 Billionen Parametern. Diese bedeutende KI-Entwicklung bietet erhebliche Leistungssteigerungen in Kernbereichen wie Programmierung und professionelle Büroaufgabe

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai












