


 Hogar
Tencent presenta OpenSearch-VL: un agente de búsqueda profunda multimodal de código abierto
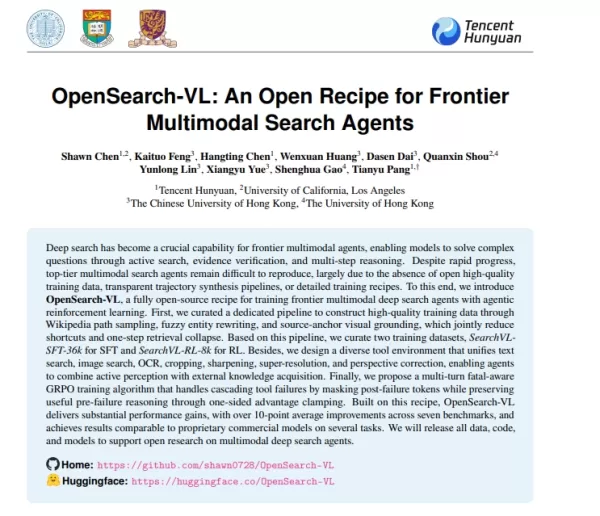
A medida que los modelos de lenguaje multimodales a gran escala (MLLM) avanzan rápidamente, el principal reto en el ámbito de la IA está pasando de la mera «comprensión pasiva de imágenes» a la búsqueda activa de pruebas y al razonamiento. Sin embargo, la falta de datos de entrenamiento de alta calidad, de procesos automatizados de síntesis de trayectorias y de protocolos de entrenamiento detallados ha dificultado que la comunidad de código abierto pueda replicar los agentes de búsqueda multimodal de primer nivel.
Para superar este cuello de botella, un equipo de investigación de Tencent Hunyuan, junto con la UCLA y la Universidad China de Hong Kong, ha lanzado OpenSearch-VL. Este proyecto, totalmente de código abierto, ofrece una vía para crear un agente de búsqueda profunda de última generación mediante el aprendizaje por refuerzo (RL).
Un innovador proceso de datos supera los atajos en la búsqueda
El equipo identificó los datos de entrenamiento de alta calidad como el principal cuello de botella para el avance de los modelos. Para entrenar modelos capaces de realizar razonamientos de varios pasos —más allá del simple reconocimiento de imágenes con un solo clic—, diseñaron un meticuloso proceso de consolidación de datos.
Este proceso toma muestras de rutas del grafo de hipervínculos de Wikipedia, convirtiendo las complejas relaciones entre entidades en pares de preguntas y respuestas de múltiples saltos. Para evitar el aprendizaje por atajos, los investigadores aplicaron una reescritura difusa de entidades para ocultar las respuestas directas e integraron una localización visual anclada al código fuente. Este enfoque obliga al modelo a detectar primero las señales visuales y, a continuación, a recuperar información de forma iterativa utilizando herramientas externas, lo que evita la degradación de la capacidad durante la recuperación. Como resultado, el equipo creó la base de datos SearchVL-SFT (36 000 trayectorias de ajuste fino mediante instrucciones) y la base de datos SearchVL-RL (8 000 trayectorias de aprendizaje por refuerzo).
Un conjunto de herramientas versátil que va más allá de la simple búsqueda
OpenSearch-VL va más allá de la búsqueda básica de texto. En la práctica, las imágenes proporcionadas por los usuarios suelen estar borrosas, distorsionadas o tener baja resolución, lo que hace que las herramientas de búsqueda convencionales resulten ineficaces.
Para hacer frente a esto, el proyecto incorpora un amplio conjunto de herramientas: búsqueda en la web, búsqueda inversa de imágenes, OCR, recorte de imágenes, mejora de nitidez, superresolución y corrección de perspectiva. El agente percibe y corrige activamente los elementos visuales imperfectos —al igual que lo haría un ser humano— antes de consultar fuentes de conocimiento externas, lo que garantiza la fiabilidad de las búsquedas posteriores.
El algoritmo sensible a los errores permite aprender de los fallos
En tareas de largo plazo, las llamadas a herramientas pueden provocar fallos en cadena. Un solo tiempo de espera agotado o un error pueden hacer fracasar toda la tarea. El aprendizaje por refuerzo (RL) tradicional suele descartar estas trayectorias fallidas, desperdiciando recursos de entrenamiento.
OpenSearch-VL introduce el GRPO multironda sensible a fallos, un algoritmo de entrenamiento que identifica puntos críticos de fallo en las llamadas a herramientas. Utiliza el enmascaramiento para filtrar la información inválida posterior al fallo y aplica un recorte de ventaja unilateral para conservar la lógica útil de los pasos anteriores. De este modo, incluso cuando el resultado final es un fallo, el modelo sigue aprendiendo rutas de búsqueda y estrategias de exploración eficaces a partir de las etapas anteriores.
Los resultados experimentales rivalizan con los modelos comerciales propietarios
Los resultados de la evaluación demuestran un sólido rendimiento en siete pruebas de referencia principales de búsqueda profunda multimodal, con una mejora media que supera los 10 puntos porcentuales. En determinadas tareas específicas, OpenSearch-VL ya está a la altura de los mejores modelos comerciales de código cerrado.
El equipo tiene previsto publicar en código abierto todos los datos de entrenamiento, el código y los pesos del modelo de OpenSearch-VL, ofreciendo así a los desarrolladores de todo el mundo una base reproducible y mejorable que impulse la investigación sobre agentes multimodales hacia un territorio más profundo.
Artículo: https://arxiv.org/pdf/2605.05185
Artículo relacionado
 CEO de DeepMind, Hassabis: Duermo seis horas al día y generalmente me siento con energía alrededor de la 1 a. m.
Fortune ha presentado recientemente una entrevista con Demis Hassabis, director ejecutivo de Google DeepMind, en la que revela su enfoque poco convencional para el descanso y la productividad. Hassabis ha revelado que duerme muy poco, estructurando s
OpenAI y Anthropic compiten por la cuota de mercado a pesar de la caída de los ingresos
A pesar de los recientes informes que sugieren que OpenAI no ha alcanzado sus objetivos de ingresos —lo que ha generado presión sobre las acciones tecnológicas este martes—, los inversores privados en
Cumplimiento de la normativa sobre vehículos autónomos en California: una nueva era de multas, geovallas y 1 millón de millas
Guident opera un servicio de transporte de AuveTech en el sur de Florida, gestionando una ruta de cuatro millas en West Palm Beach y otra de una milla en Boca Ratón mediante su tecnología de monitoriz
Recomendaciones de temas especiales relacionados
chatbot
 Las mejores aplicaciones de chat de roleplay con IA para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria
¡Las mejores aplicaciones de chat de roleplay con IA de 2026, mejor valoradas, para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria! XIX.AI selecciona una poderosa colección revolucionaria que ofrece comparaciones entre versiones gratuitas y de pago, pruebas del mundo real y clasificaciones actualizadas semanalmente. Estas herramientas imprescindibles te ayudan a mejorar tus habilidades de escritura, superar los desafíos de fluidez y aumentar la eficiencia comunicativa en todas las situaciones cotidianas. ¡Explora ahora para descubrir tu herramienta perfecta para el crecimiento lingüístico!
 10 herramientas
 xix.ai
composicion musical
Herramientas de separación de pistas con IA para la producción de remezclas, la preparación de samples y las pistas maestras de karaoke
Las mejores herramientas de separación de pistas con IA de 2026, seleccionadas para la producción de remixes, la preparación de samples y la creación de temas de karaoke. Estas potentes herramientas revolucionarias se han sometido a pruebas en condiciones reales para ofrecer un aislamiento de audio preciso, lo que aumenta significativamente la productividad. XIX.AI ofrece una guía comparativa entre versiones gratuitas y de pago, actualizada semanalmente, para ayudarte a encontrar la solución imprescindible que mejor se adapte a tus necesidades. Explórala ahora para sacar el máximo partido a la IA.
8 herramientas
xix.ai
Análisis de datos
Copilotos de AI para SQL destinados a paneles de ingresos, análisis de embudos y métricas de productos
¡Los mejores copilotos de SQL basados en IA de 2026, clasificados entre los más destacados! XIX.AI reúne una poderosa colección que evoluciona constantemente, con pruebas en el mundo real actualizadas semanalmente. Estas herramientas indispensables le permiten generar paneles de control de ingresos precisos, analizar los canales de venta y seguir de cerca las métricas de los productos de manera rápida, lo que aumenta significativamente su productividad. ¡Explórelas ahora para encontrar la herramienta perfecta para tomar decisiones basadas en datos! 238 caracteres
9 herramientas
xix.ai
composicion musical
Mejores herramientas de IA para escribir melodías en borradores de canciones
2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai
chatbot
Mejores herramientas de entrenamiento de conversación con IA para practicar entrevistas
¡Las mejores herramientas de entrenamiento de conversación con IA para prácticas de entrevistas más recientes y mejor valoradas de 2026 ya están disponibles en XIX.AI! Esta colección seleccionada incluye herramientas poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real para ofrecer retroalimentación precisa. Encontrarás una comparación entre opciones gratuitas y de pago, así como clasificaciones detalladas para ayudarte a elegir la opción imprescindible que aumente tu confianza y habilidades. ¡Explora ahora para descubrir tu herramienta perfecta para el éxito en las entrevistas!
12 herramientas
xix.ai
Diseño y Arte
Las mejores herramientas de transferencia de estilos con IA para experimentos creativos
¡Las mejores herramientas de transferencia de estilo con IA de 2026, mejor valoradas para experimentos creativos! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder, capaces de ofrecer resultados excepcionales según pruebas reales y clasificaciones rigurosas. Estas soluciones de primera categoría ayudan a los creativos a aumentar significativamente su productividad, acelerando la creación de contenidos y abriendo un sinfín de posibilidades creativas. ¡Explora ahora mismo para descubrir tu herramienta perfecta y empieza a crear hoy mismo!
9 herramientas
xix.ai

 comentario (0)
0/500
A medida que los modelos de lenguaje multimodales a gran escala (MLLM) avanzan rápidamente, el principal reto en el ámbito de la IA está pasando de la mera «comprensión pasiva de imágenes» a la búsqueda activa de pruebas y al razonamiento. Sin embargo, la falta de datos de entrenamiento de alta calidad, de procesos automatizados de síntesis de trayectorias y de protocolos de entrenamiento detallados ha dificultado que la comunidad de código abierto pueda replicar los agentes de búsqueda multimodal de primer nivel.
Para superar este cuello de botella, un equipo de investigación de Tencent Hunyuan, junto con la UCLA y la Universidad China de Hong Kong, ha lanzado OpenSearch-VL. Este proyecto, totalmente de código abierto, ofrece una vía para crear un agente de búsqueda profunda de última generación mediante el aprendizaje por refuerzo (RL).
Un innovador proceso de datos supera los atajos en la búsqueda
El equipo identificó los datos de entrenamiento de alta calidad como el principal cuello de botella para el avance de los modelos. Para entrenar modelos capaces de realizar razonamientos de varios pasos —más allá del simple reconocimiento de imágenes con un solo clic—, diseñaron un meticuloso proceso de consolidación de datos.
Este proceso toma muestras de rutas del grafo de hipervínculos de Wikipedia, convirtiendo las complejas relaciones entre entidades en pares de preguntas y respuestas de múltiples saltos. Para evitar el aprendizaje por atajos, los investigadores aplicaron una reescritura difusa de entidades para ocultar las respuestas directas e integraron una localización visual anclada al código fuente. Este enfoque obliga al modelo a detectar primero las señales visuales y, a continuación, a recuperar información de forma iterativa utilizando herramientas externas, lo que evita la degradación de la capacidad durante la recuperación. Como resultado, el equipo creó la base de datos SearchVL-SFT (36 000 trayectorias de ajuste fino mediante instrucciones) y la base de datos SearchVL-RL (8 000 trayectorias de aprendizaje por refuerzo).
Un conjunto de herramientas versátil que va más allá de la simple búsqueda
OpenSearch-VL va más allá de la búsqueda básica de texto. En la práctica, las imágenes proporcionadas por los usuarios suelen estar borrosas, distorsionadas o tener baja resolución, lo que hace que las herramientas de búsqueda convencionales resulten ineficaces.
Para hacer frente a esto, el proyecto incorpora un amplio conjunto de herramientas: búsqueda en la web, búsqueda inversa de imágenes, OCR, recorte de imágenes, mejora de nitidez, superresolución y corrección de perspectiva. El agente percibe y corrige activamente los elementos visuales imperfectos —al igual que lo haría un ser humano— antes de consultar fuentes de conocimiento externas, lo que garantiza la fiabilidad de las búsquedas posteriores.
El algoritmo sensible a los errores permite aprender de los fallos
En tareas de largo plazo, las llamadas a herramientas pueden provocar fallos en cadena. Un solo tiempo de espera agotado o un error pueden hacer fracasar toda la tarea. El aprendizaje por refuerzo (RL) tradicional suele descartar estas trayectorias fallidas, desperdiciando recursos de entrenamiento.
OpenSearch-VL introduce el GRPO multironda sensible a fallos, un algoritmo de entrenamiento que identifica puntos críticos de fallo en las llamadas a herramientas. Utiliza el enmascaramiento para filtrar la información inválida posterior al fallo y aplica un recorte de ventaja unilateral para conservar la lógica útil de los pasos anteriores. De este modo, incluso cuando el resultado final es un fallo, el modelo sigue aprendiendo rutas de búsqueda y estrategias de exploración eficaces a partir de las etapas anteriores.
Los resultados experimentales rivalizan con los modelos comerciales propietarios
Los resultados de la evaluación demuestran un sólido rendimiento en siete pruebas de referencia principales de búsqueda profunda multimodal, con una mejora media que supera los 10 puntos porcentuales. En determinadas tareas específicas, OpenSearch-VL ya está a la altura de los mejores modelos comerciales de código cerrado.
El equipo tiene previsto publicar en código abierto todos los datos de entrenamiento, el código y los pesos del modelo de OpenSearch-VL, ofreciendo así a los desarrolladores de todo el mundo una base reproducible y mejorable que impulse la investigación sobre agentes multimodales hacia un territorio más profundo.
Artículo: https://arxiv.org/pdf/2605.05185








 CEO de DeepMind, Hassabis: Duermo seis horas al día y generalmente me siento con energía alrededor de la 1 a. m.
Fortune ha presentado recientemente una entrevista con Demis Hassabis, director ejecutivo de Google DeepMind, en la que revela su enfoque poco convencional para el descanso y la productividad. Hassabis ha revelado que duerme muy poco, estructurando s
 OpenAI y Anthropic compiten por la cuota de mercado a pesar de la caída de los ingresos
A pesar de los recientes informes que sugieren que OpenAI no ha alcanzado sus objetivos de ingresos —lo que ha generado presión sobre las acciones tecnológicas este martes—, los inversores privados en
Cumplimiento de la normativa sobre vehículos autónomos en California: una nueva era de multas, geovallas y 1 millón de millas
Guident opera un servicio de transporte de AuveTech en el sur de Florida, gestionando una ruta de cuatro millas en West Palm Beach y otra de una milla en Boca Ratón mediante su tecnología de monitoriz

¡Las mejores aplicaciones de chat de roleplay con IA de 2026, mejor valoradas, para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria! XIX.AI selecciona una poderosa colección revolucionaria que ofrece comparaciones entre versiones gratuitas y de pago, pruebas del mundo real y clasificaciones actualizadas semanalmente. Estas herramientas imprescindibles te ayudan a mejorar tus habilidades de escritura, superar los desafíos de fluidez y aumentar la eficiencia comunicativa en todas las situaciones cotidianas. ¡Explora ahora para descubrir tu herramienta perfecta para el crecimiento lingüístico!
10 herramientas
xix.ai

Las mejores herramientas de separación de pistas con IA de 2026, seleccionadas para la producción de remixes, la preparación de samples y la creación de temas de karaoke. Estas potentes herramientas revolucionarias se han sometido a pruebas en condiciones reales para ofrecer un aislamiento de audio preciso, lo que aumenta significativamente la productividad. XIX.AI ofrece una guía comparativa entre versiones gratuitas y de pago, actualizada semanalmente, para ayudarte a encontrar la solución imprescindible que mejor se adapte a tus necesidades. Explórala ahora para sacar el máximo partido a la IA.
8 herramientas
xix.ai

¡Los mejores copilotos de SQL basados en IA de 2026, clasificados entre los más destacados! XIX.AI reúne una poderosa colección que evoluciona constantemente, con pruebas en el mundo real actualizadas semanalmente. Estas herramientas indispensables le permiten generar paneles de control de ingresos precisos, analizar los canales de venta y seguir de cerca las métricas de los productos de manera rápida, lo que aumenta significativamente su productividad. ¡Explórelas ahora para encontrar la herramienta perfecta para tomar decisiones basadas en datos! 238 caracteres
9 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai

¡Las mejores herramientas de entrenamiento de conversación con IA para prácticas de entrevistas más recientes y mejor valoradas de 2026 ya están disponibles en XIX.AI! Esta colección seleccionada incluye herramientas poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real para ofrecer retroalimentación precisa. Encontrarás una comparación entre opciones gratuitas y de pago, así como clasificaciones detalladas para ayudarte a elegir la opción imprescindible que aumente tu confianza y habilidades. ¡Explora ahora para descubrir tu herramienta perfecta para el éxito en las entrevistas!
12 herramientas
xix.ai

¡Las mejores herramientas de transferencia de estilo con IA de 2026, mejor valoradas para experimentos creativos! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder, capaces de ofrecer resultados excepcionales según pruebas reales y clasificaciones rigurosas. Estas soluciones de primera categoría ayudan a los creativos a aumentar significativamente su productividad, acelerando la creación de contenidos y abriendo un sinfín de posibilidades creativas. ¡Explora ahora mismo para descubrir tu herramienta perfecta y empieza a crear hoy mismo!
9 herramientas
xix.ai












