


 Maison
Tencent dévoile OpenSearch-VL : un agent de recherche profonde multimodale open source
À mesure que les grands modèles linguistiques multimodaux (MLLM) progressent rapidement, le principal défi dans le domaine de l’IA évolue : il ne s’agit plus simplement de « comprendre passivement des images », mais de rechercher activement des indices et de raisonner. Cependant, le manque de données d’entraînement de haute qualité, de pipelines automatisés de synthèse de trajectoires et de procédures d’entraînement détaillées a rendu difficile pour la communauté open source de reproduire des agents de recherche multimodaux de haut niveau.
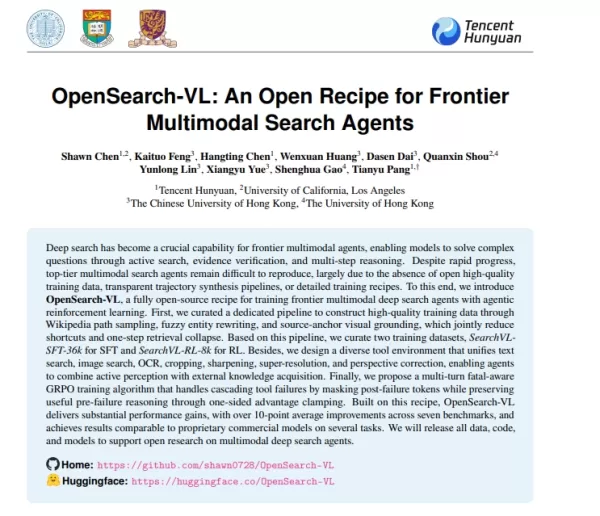
Pour surmonter ce goulot d’étranglement, une équipe de recherche de Tencent Hunyuan, en collaboration avec l’UCLA et l’Université chinoise de Hong Kong, a lancé OpenSearch-VL. Ce plan de développement entièrement open source ouvre la voie à la création d’un agent de recherche profonde de pointe grâce à l’apprentissage par renforcement (RL).
Un pipeline de données innovant pour surmonter les raccourcis de recherche
L’équipe a identifié le manque de données d’entraînement de haute qualité comme le principal goulot d’étranglement pour l’avancement des modèles. Afin d’entraîner des modèles capables d’un raisonnement en plusieurs étapes — au-delà de la simple reconnaissance d’images en un clic —, elle a conçu un pipeline de consolidation des données minutieux.
Ce pipeline échantillonne des chemins à partir du graphe d’hyperliens de Wikipédia, convertissant les relations complexes entre entités en paires de questions-réponses à plusieurs sauts. Pour empêcher l’apprentissage par raccourcis, les chercheurs ont appliqué une réécriture floue des entités afin de masquer les réponses directes et ont intégré une localisation visuelle ancrée au code source. Cette approche oblige le modèle à détecter d’abord les signaux visuels, puis à récupérer les informations de manière itérative à l’aide d’outils externes, ce qui empêche la dégradation des compétences lors de la récupération. L’équipe a ainsi constitué la base de données SearchVL-SFT (36 000 trajectoires d’affinage par instructions) et la base de données SearchVL-RL (8 000 trajectoires d’apprentissage par renforcement).
Une boîte à outils polyvalente allant au-delà de la simple recherche
OpenSearch-VL va au-delà de la simple recherche textuelle. Dans la pratique, les images fournies par les utilisateurs sont souvent floues, déformées ou de faible résolution, ce qui rend les outils de recherche conventionnels inefficaces.
Pour remédier à cela, le projet intègre un ensemble complet d’outils : recherche sur le Web, recherche d’images par image, OCR, recadrage d’images, amélioration de la netteté, super-résolution et correction de la perspective. L’agent perçoit et corrige activement les visuels imparfaits — à l’instar d’un être humain — avant d’interroger des sources de connaissances externes, garantissant ainsi la fiabilité des recherches ultérieures.
Un algorithme sensible aux erreurs permet d’apprendre de ses erreurs
Dans les tâches à long terme, les appels d’outils peuvent entraîner des défaillances en cascade. Un simple délai d’expiration ou une seule erreur peut faire dérailler l’ensemble de la tâche. L’apprentissage par renforcement (RL) traditionnel écarte souvent ces trajectoires ayant échoué, ce qui gaspille les ressources d’entraînement.
OpenSearch-VL introduit le GRPO multi-itérations sensible aux défaillances, un algorithme d’entraînement qui identifie les points de défaillance critiques dans les appels d’outils. Il utilise le masquage pour filtrer les informations invalides post-défaillance et applique un écrêtage unilatéral des avantages afin de préserver la logique utile issue des étapes précédentes. De cette manière, même lorsque le résultat final est un échec, le modèle apprend tout de même des chemins de recherche et des stratégies d’exploration efficaces à partir des étapes précédentes.
Des résultats expérimentaux rivalisant avec ceux des modèles commerciaux propriétaires
Les résultats d’évaluation démontrent de solides performances sur sept benchmarks courants de recherche profonde multimodale, avec une amélioration moyenne dépassant 10 points de pourcentage. Sur certaines tâches spécifiques, OpenSearch-VL rivalise déjà avec les meilleurs modèles commerciaux à code source fermé.
L’équipe prévoit de mettre entièrement en open source l’ensemble des données d’entraînement, du code et des poids du modèle pour OpenSearch-VL, offrant ainsi aux développeurs du monde entier une base reproductible et perfectible qui fera progresser la recherche sur les agents multimodaux vers des horizons plus profonds.
Article : https://arxiv.org/pdf/2605.05185
Article connexe
 Les lunettes intelligentes d’Apple pourraient être présentées lors de la WWDC27, mettant en avant la protection de la vie privée
Mark Gurman de Bloomberg rapporte que les lunettes intelligentes d’Apple, codifiées N50, sont prévues pour une présentation lors de la WWDC27 en juin 2027, avec un lancement commercial attendu à l’automne 2027. Initialement destinées à la fin de cett
À l’intérieur des détails révélés sur le prochain Gemini : une puissance de calcul mise à rude épreuve, des équipes internes en désaccord sur les priorités de développement et l’allocation des ressources
Les rapports indiquent que le lancement du modèle Gemini de nouvelle génération, tant attendu par Google, a été repoussé. Des désaccords internes concernant les priorités de développement et l'allocation des ressources, combinés à une capacité de cal
OpenAI rejette les inquiétudes concernant un ralentissement de la croissance, affirmant que plusieurs unités commerciales accélèrent
En réponse aux critiques externes concernant la décélération de la croissance des ventes et le non-respect des objectifs internes, le leader de l'IA, OpenAI, a publié une déclaration rassurante le mardi 28 avril. L'entreprise a précisé que ses produi
Recommandations de sujets spéciaux liés
Analyse des données
 Copilotes SQL basés sur l’IA pour les tableaux de bord de chiffre d’affaires, l’analyse des funnels et les indicateurs de produits
2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
 9 outils
 xix.ai
Composition musicale
Meilleurs outils d’écriture de mélodies par IA pour les ébauches de chansons
2026 Derniers Meilleurs Outils d’Écriture de Mélodie par IA les Mieux Notés pour des Ébauches de Chansons ! XIX.AI a sélectionné une collection hautement puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles, afin d’offrir la meilleure expérience d’écriture. Vous pouvez y trouver des comparaisons détaillées entre versions gratuites et payantes, des classements précis, ainsi que des options incontournables conçues pour vous aider à créer sans effort des ébauches de chansons remarquables et à booster significativement votre productivité créative. Explorez dès maintenant pour découvrir l’outil qui vous correspond parfaitement !
8 outils
xix.ai
chatbot
Meilleurs outils d’entraînement à la conversation par IA pour la préparation aux entretiens
Les derniers outils de formation à la conversation par IA les mieux notés pour 2026 sont disponibles sur XIX.AI ! Cette sélection rigoureuse propose des outils puissants et révolutionnaires, testés rigoureusement dans des conditions réelles pour fournir des retours précis. Vous y trouverez une comparaison entre les versions gratuites et payantes, ainsi que des classements détaillés pour vous aider à choisir l’option incontournable qui renforce votre confiance et vos compétences. Explorez dès maintenant pour découvrir l’outil parfait pour réussir vos entretiens !
12 outils
xix.ai
Conception et art
Les meilleurs outils de transfert de style basés sur l'IA pour des expériences créatives
Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai
Création de bande dessinée
Les meilleurs outils d'IA pour créer des bulles de dialogue destinés à la narration visuelle
Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai
Assistante de réunion
Les meilleurs outils de synthèse de réunions basés sur l'IA : suivez clairement les décisions et les actions à mener
2026 : les meilleurs outils d'IA pour la synthèse de réunions, les mieux notés, pour un suivi clair des décisions et des relances sans effort. Cette sélection présente des solutions puissantes et révolutionnaires qui boostent considérablement la productivité en automatisant la prise de notes lors des réunions, en identifiant les actions clés et en rationalisant la coordination des équipes sur l'ensemble des projets. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai

 commentaires (0)
À mesure que les grands modèles linguistiques multimodaux (MLLM) progressent rapidement, le principal défi dans le domaine de l’IA évolue : il ne s’agit plus simplement de « comprendre passivement des images », mais de rechercher activement des indices et de raisonner. Cependant, le manque de données d’entraînement de haute qualité, de pipelines automatisés de synthèse de trajectoires et de procédures d’entraînement détaillées a rendu difficile pour la communauté open source de reproduire des agents de recherche multimodaux de haut niveau.
Pour surmonter ce goulot d’étranglement, une équipe de recherche de Tencent Hunyuan, en collaboration avec l’UCLA et l’Université chinoise de Hong Kong, a lancé OpenSearch-VL. Ce plan de développement entièrement open source ouvre la voie à la création d’un agent de recherche profonde de pointe grâce à l’apprentissage par renforcement (RL).
Un pipeline de données innovant pour surmonter les raccourcis de recherche
L’équipe a identifié le manque de données d’entraînement de haute qualité comme le principal goulot d’étranglement pour l’avancement des modèles. Afin d’entraîner des modèles capables d’un raisonnement en plusieurs étapes — au-delà de la simple reconnaissance d’images en un clic —, elle a conçu un pipeline de consolidation des données minutieux.
Ce pipeline échantillonne des chemins à partir du graphe d’hyperliens de Wikipédia, convertissant les relations complexes entre entités en paires de questions-réponses à plusieurs sauts. Pour empêcher l’apprentissage par raccourcis, les chercheurs ont appliqué une réécriture floue des entités afin de masquer les réponses directes et ont intégré une localisation visuelle ancrée au code source. Cette approche oblige le modèle à détecter d’abord les signaux visuels, puis à récupérer les informations de manière itérative à l’aide d’outils externes, ce qui empêche la dégradation des compétences lors de la récupération. L’équipe a ainsi constitué la base de données SearchVL-SFT (36 000 trajectoires d’affinage par instructions) et la base de données SearchVL-RL (8 000 trajectoires d’apprentissage par renforcement).
Une boîte à outils polyvalente allant au-delà de la simple recherche
OpenSearch-VL va au-delà de la simple recherche textuelle. Dans la pratique, les images fournies par les utilisateurs sont souvent floues, déformées ou de faible résolution, ce qui rend les outils de recherche conventionnels inefficaces.
Pour remédier à cela, le projet intègre un ensemble complet d’outils : recherche sur le Web, recherche d’images par image, OCR, recadrage d’images, amélioration de la netteté, super-résolution et correction de la perspective. L’agent perçoit et corrige activement les visuels imparfaits — à l’instar d’un être humain — avant d’interroger des sources de connaissances externes, garantissant ainsi la fiabilité des recherches ultérieures.
Un algorithme sensible aux erreurs permet d’apprendre de ses erreurs
Dans les tâches à long terme, les appels d’outils peuvent entraîner des défaillances en cascade. Un simple délai d’expiration ou une seule erreur peut faire dérailler l’ensemble de la tâche. L’apprentissage par renforcement (RL) traditionnel écarte souvent ces trajectoires ayant échoué, ce qui gaspille les ressources d’entraînement.
OpenSearch-VL introduit le GRPO multi-itérations sensible aux défaillances, un algorithme d’entraînement qui identifie les points de défaillance critiques dans les appels d’outils. Il utilise le masquage pour filtrer les informations invalides post-défaillance et applique un écrêtage unilatéral des avantages afin de préserver la logique utile issue des étapes précédentes. De cette manière, même lorsque le résultat final est un échec, le modèle apprend tout de même des chemins de recherche et des stratégies d’exploration efficaces à partir des étapes précédentes.
Des résultats expérimentaux rivalisant avec ceux des modèles commerciaux propriétaires
Les résultats d’évaluation démontrent de solides performances sur sept benchmarks courants de recherche profonde multimodale, avec une amélioration moyenne dépassant 10 points de pourcentage. Sur certaines tâches spécifiques, OpenSearch-VL rivalise déjà avec les meilleurs modèles commerciaux à code source fermé.
L’équipe prévoit de mettre entièrement en open source l’ensemble des données d’entraînement, du code et des poids du modèle pour OpenSearch-VL, offrant ainsi aux développeurs du monde entier une base reproductible et perfectible qui fera progresser la recherche sur les agents multimodaux vers des horizons plus profonds.
Article : https://arxiv.org/pdf/2605.05185








 Les lunettes intelligentes d’Apple pourraient être présentées lors de la WWDC27, mettant en avant la protection de la vie privée
Mark Gurman de Bloomberg rapporte que les lunettes intelligentes d’Apple, codifiées N50, sont prévues pour une présentation lors de la WWDC27 en juin 2027, avec un lancement commercial attendu à l’automne 2027. Initialement destinées à la fin de cett
 À l’intérieur des détails révélés sur le prochain Gemini : une puissance de calcul mise à rude épreuve, des équipes internes en désaccord sur les priorités de développement et l’allocation des ressources
Les rapports indiquent que le lancement du modèle Gemini de nouvelle génération, tant attendu par Google, a été repoussé. Des désaccords internes concernant les priorités de développement et l'allocation des ressources, combinés à une capacité de cal
 OpenAI rejette les inquiétudes concernant un ralentissement de la croissance, affirmant que plusieurs unités commerciales accélèrent
En réponse aux critiques externes concernant la décélération de la croissance des ventes et le non-respect des objectifs internes, le leader de l'IA, OpenAI, a publié une déclaration rassurante le mardi 28 avril. L'entreprise a précisé que ses produi

2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
9 outils
xix.ai

2026 Derniers Meilleurs Outils d’Écriture de Mélodie par IA les Mieux Notés pour des Ébauches de Chansons ! XIX.AI a sélectionné une collection hautement puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles, afin d’offrir la meilleure expérience d’écriture. Vous pouvez y trouver des comparaisons détaillées entre versions gratuites et payantes, des classements précis, ainsi que des options incontournables conçues pour vous aider à créer sans effort des ébauches de chansons remarquables et à booster significativement votre productivité créative. Explorez dès maintenant pour découvrir l’outil qui vous correspond parfaitement !
8 outils
xix.ai

Les derniers outils de formation à la conversation par IA les mieux notés pour 2026 sont disponibles sur XIX.AI ! Cette sélection rigoureuse propose des outils puissants et révolutionnaires, testés rigoureusement dans des conditions réelles pour fournir des retours précis. Vous y trouverez une comparaison entre les versions gratuites et payantes, ainsi que des classements détaillés pour vous aider à choisir l’option incontournable qui renforce votre confiance et vos compétences. Explorez dès maintenant pour découvrir l’outil parfait pour réussir vos entretiens !
12 outils
xix.ai

Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai

Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai

2026 : les meilleurs outils d'IA pour la synthèse de réunions, les mieux notés, pour un suivi clair des décisions et des relances sans effort. Cette sélection présente des solutions puissantes et révolutionnaires qui boostent considérablement la productivité en automatisant la prise de notes lors des réunions, en identifiant les actions clés et en rationalisant la coordination des équipes sur l'ensemble des projets. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai












