


 Lar
A Tencent apresenta o OpenSearch-VL: um agente de pesquisa profunda multimodal de código aberto
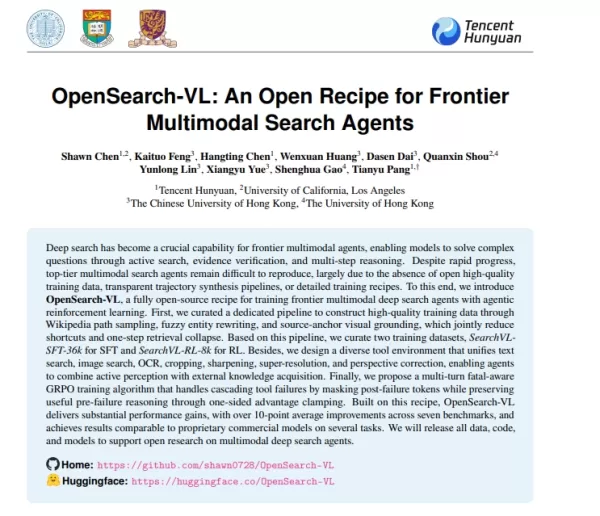
À medida que os modelos de linguagem multimodais de grande porte (MLLMs) avançam rapidamente, o principal desafio na competição em IA está mudando de simplesmente “compreender imagens de forma passiva” para buscar ativamente evidências e raciocinar. No entanto, a falta de dados de treinamento de alta qualidade, de pipelines automatizados de síntese de trajetórias e de orientações detalhadas de treinamento tem dificultado que a comunidade de código aberto reproduza os melhores agentes de busca multimodal.
Para superar esse gargalo, uma equipe de pesquisa da Tencent Hunyuan, em parceria com a UCLA e a Universidade Chinesa de Hong Kong, lançou o OpenSearch-VL. Esse projeto totalmente de código aberto oferece um caminho para a construção de um agente de busca profunda de última geração por meio do aprendizado por reforço (RL).
Fluxo de dados inovador supera atalhos na pesquisa
A equipe identificou os dados de treinamento de alta qualidade como o principal gargalo para o avanço dos modelos. Para treinar modelos para raciocínio em múltiplas etapas — além do simples reconhecimento de imagens com um clique —, eles projetaram um pipeline meticuloso de consolidação de dados.
Esse pipeline amostra caminhos a partir do grafo de hiperlinks da Wikipédia, convertendo relações complexas entre entidades em pares de perguntas e respostas com múltiplos saltos. Para evitar o aprendizado por atalhos, os pesquisadores aplicaram reescrita difusa de entidades para ocultar respostas diretas e integraram a localização visual ancorada ao código-fonte. Essa abordagem obriga o modelo a primeiro detectar sinais visuais e, em seguida, recuperar informações de forma iterativa usando ferramentas externas, evitando a degradação da habilidade durante a recuperação. Como resultado, a equipe construiu o banco de dados SearchVL-SFT (36.000 trajetórias de ajuste fino por instrução) e o banco de dados SearchVL-RL (8.000 trajetórias de aprendizado por reforço).
Conjunto de ferramentas versátil que vai além da simples pesquisa
O OpenSearch-VL vai além da pesquisa básica de texto. No uso no mundo real, as imagens fornecidas pelos usuários costumam estar desfocadas, distorcidas ou com baixa resolução, tornando as ferramentas de pesquisa convencionais ineficazes.
Para lidar com isso, o projeto incorpora um rico conjunto de ferramentas: pesquisa na web, pesquisa reversa de imagens, OCR, recorte de imagens, nitidez, super-resolução e correção de perspectiva. O agente percebe e corrige ativamente elementos visuais imperfeitos — assim como um ser humano — antes de consultar conhecimentos externos, garantindo pesquisas subsequentes confiáveis.
Algoritmo sensível a falhas permite aprender com os erros
Em tarefas de longo prazo, as chamadas de ferramentas podem gerar falhas em cascata. Um único tempo limite excedido ou erro pode comprometer toda a tarefa. O RL tradicional frequentemente descarta essas trajetórias malsucedidas, desperdiçando recursos de treinamento.
O OpenSearch-VL apresenta o GRPO sensível a falhas em múltiplas rodadas, um algoritmo de treinamento que identifica pontos críticos de falha nas chamadas de ferramentas. Ele usa mascaramento para filtrar informações inválidas pós-falha e aplica um recorte unilateral de vantagem para preservar a lógica útil das etapas anteriores. Dessa forma, mesmo quando o resultado final é uma falha, o modelo ainda aprende caminhos de busca e estratégias de exploração eficazes a partir das etapas anteriores.
Resultados experimentais rivalizam com modelos comerciais proprietários
Os resultados da avaliação demonstram forte desempenho em sete benchmarks convencionais de pesquisa profunda multimodal, com uma melhoria média superior a 10 pontos percentuais. Em certas tarefas específicas, o OpenSearch-VL já se equipara aos principais modelos comerciais de código fechado.
A equipe planeja disponibilizar totalmente em código aberto todos os dados de treinamento, o código-fonte e os pesos do modelo do OpenSearch-VL, oferecendo aos desenvolvedores globais uma base reproduzível e aprimorável que leva a pesquisa de agentes multimodais a um território mais profundo.
Artigo: https://arxiv.org/pdf/2605.05185
Artigo relacionado
 Dentro dos Detalhes Revelados Sobre o Gemini de Próxima Geração: Poder de Cálculo Sobrecarregado, Equipes Internas Discordaram Sobre Prioridades de Desenvolvimento e Alocação de Recursos
Os relatórios indicam que o lançamento do tão aguardado modelo Gemini de próxima geração do Google foi adiado. Desentendimentos internos sobre prioridades de desenvolvimento e alocação de recursos, combinados com capacidade computacional limitada e p
A OpenAI descarta preocupações com a desaceleração do crescimento e afirma que múltiplas unidades de negócio estão acelerando.
Em resposta à escrutínio externo sobre o desaceleramento do crescimento das vendas e o não cumprimento de metas internas, o líder em inteligência artificial, OpenAI, emitiu uma declaração confiante na terça-feira, 28 de abril. A empresa esclareceu qu
Alibaba Super Cup: Qwen3.8-Max estreia com aprimoramento nas ferramentas de programação e escritório
A Alibaba revelou oficialmente o Qwen3.8-Max, um modelo de base de próxima geração com 2,4 trilhão de parâmetros. Este avanço significativo em IA oferece ganhos substanciais de desempenho em áreas principais, como programação e tarefas profissionais
Recomendações de tópicos especiais relacionados
Composição musical
 Melhores Ferramentas de IA para Criação de Melodias para Rascunhos de Músicas
2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
 8 ferramentas
 xix.ai
chatbot
Melhores ferramentas de treinamento de conversação com IA para prática de entrevistas
As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai
Design e Arte
As melhores ferramentas de transferência de estilo com IA para experimentos criativos
As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai
Criação de quadrinhos
As melhores ferramentas de balões de diálogo com IA para a narrativa visual
As melhores e mais bem avaliadas ferramentas de balões de diálogo com IA para narrativa visual de 2026 já estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que ajudam os criadores a aumentar a produtividade e superar gargalos criativos. Veja uma comparação entre versões gratuitas e pagas, confira testes reais e verifique os rankings mais recentes para encontrar as soluções imperdíveis, perfeitas para criar narrativas visuais envolventes. Explore agora e descubra sua ferramenta ideal!
10 ferramentas
xix.ai
Assistente de Reunião
As melhores ferramentas de resumo de reuniões com IA: acompanhe decisões e ações de acompanhamento com clareza
As melhores e mais bem avaliadas ferramentas de resumo de reuniões com IA de 2026 para um acompanhamento claro das decisões e acompanhamentos sem esforço. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam drasticamente a produtividade ao automatizar notas de reuniões, identificar ações-chave e otimizar a coordenação da equipe em todos os projetos. Veja uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente para ajudá-lo a encontrar a ferramenta perfeita. Explore agora para aproveitar ao máximo as vantagens da IA!
9 ferramentas
xix.ai
Análise de dados
Melhores ferramentas de limpeza de dados com IA: corrija valores faltantes e duplicatas rapidamente
2026 – Os melhores e mais bem avaliados ferramentas de limpeza de dados com IA, atualizadas para corrigir rapidamente valores faltantes e duplicatas. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam significativamente a produtividade. Cada opção passou por testes rigorosos em condições reais para garantir sua confiabilidade. Acesse uma comparação gratuita entre as versões pagas e gratuitas e descubra a ferramenta indispensável que melhor atende às suas necessidades. Explore agora em XIX.AI para aproveitar todos os benefícios oferecidos pela IA.
11 ferramentas
xix.ai

 Comentários (0)
À medida que os modelos de linguagem multimodais de grande porte (MLLMs) avançam rapidamente, o principal desafio na competição em IA está mudando de simplesmente “compreender imagens de forma passiva” para buscar ativamente evidências e raciocinar. No entanto, a falta de dados de treinamento de alta qualidade, de pipelines automatizados de síntese de trajetórias e de orientações detalhadas de treinamento tem dificultado que a comunidade de código aberto reproduza os melhores agentes de busca multimodal.
Para superar esse gargalo, uma equipe de pesquisa da Tencent Hunyuan, em parceria com a UCLA e a Universidade Chinesa de Hong Kong, lançou o OpenSearch-VL. Esse projeto totalmente de código aberto oferece um caminho para a construção de um agente de busca profunda de última geração por meio do aprendizado por reforço (RL).
Fluxo de dados inovador supera atalhos na pesquisa
A equipe identificou os dados de treinamento de alta qualidade como o principal gargalo para o avanço dos modelos. Para treinar modelos para raciocínio em múltiplas etapas — além do simples reconhecimento de imagens com um clique —, eles projetaram um pipeline meticuloso de consolidação de dados.
Esse pipeline amostra caminhos a partir do grafo de hiperlinks da Wikipédia, convertendo relações complexas entre entidades em pares de perguntas e respostas com múltiplos saltos. Para evitar o aprendizado por atalhos, os pesquisadores aplicaram reescrita difusa de entidades para ocultar respostas diretas e integraram a localização visual ancorada ao código-fonte. Essa abordagem obriga o modelo a primeiro detectar sinais visuais e, em seguida, recuperar informações de forma iterativa usando ferramentas externas, evitando a degradação da habilidade durante a recuperação. Como resultado, a equipe construiu o banco de dados SearchVL-SFT (36.000 trajetórias de ajuste fino por instrução) e o banco de dados SearchVL-RL (8.000 trajetórias de aprendizado por reforço).
Conjunto de ferramentas versátil que vai além da simples pesquisa
O OpenSearch-VL vai além da pesquisa básica de texto. No uso no mundo real, as imagens fornecidas pelos usuários costumam estar desfocadas, distorcidas ou com baixa resolução, tornando as ferramentas de pesquisa convencionais ineficazes.
Para lidar com isso, o projeto incorpora um rico conjunto de ferramentas: pesquisa na web, pesquisa reversa de imagens, OCR, recorte de imagens, nitidez, super-resolução e correção de perspectiva. O agente percebe e corrige ativamente elementos visuais imperfeitos — assim como um ser humano — antes de consultar conhecimentos externos, garantindo pesquisas subsequentes confiáveis.
Algoritmo sensível a falhas permite aprender com os erros
Em tarefas de longo prazo, as chamadas de ferramentas podem gerar falhas em cascata. Um único tempo limite excedido ou erro pode comprometer toda a tarefa. O RL tradicional frequentemente descarta essas trajetórias malsucedidas, desperdiçando recursos de treinamento.
O OpenSearch-VL apresenta o GRPO sensível a falhas em múltiplas rodadas, um algoritmo de treinamento que identifica pontos críticos de falha nas chamadas de ferramentas. Ele usa mascaramento para filtrar informações inválidas pós-falha e aplica um recorte unilateral de vantagem para preservar a lógica útil das etapas anteriores. Dessa forma, mesmo quando o resultado final é uma falha, o modelo ainda aprende caminhos de busca e estratégias de exploração eficazes a partir das etapas anteriores.
Resultados experimentais rivalizam com modelos comerciais proprietários
Os resultados da avaliação demonstram forte desempenho em sete benchmarks convencionais de pesquisa profunda multimodal, com uma melhoria média superior a 10 pontos percentuais. Em certas tarefas específicas, o OpenSearch-VL já se equipara aos principais modelos comerciais de código fechado.
A equipe planeja disponibilizar totalmente em código aberto todos os dados de treinamento, o código-fonte e os pesos do modelo do OpenSearch-VL, oferecendo aos desenvolvedores globais uma base reproduzível e aprimorável que leva a pesquisa de agentes multimodais a um território mais profundo.
Artigo: https://arxiv.org/pdf/2605.05185








 Dentro dos Detalhes Revelados Sobre o Gemini de Próxima Geração: Poder de Cálculo Sobrecarregado, Equipes Internas Discordaram Sobre Prioridades de Desenvolvimento e Alocação de Recursos
Os relatórios indicam que o lançamento do tão aguardado modelo Gemini de próxima geração do Google foi adiado. Desentendimentos internos sobre prioridades de desenvolvimento e alocação de recursos, combinados com capacidade computacional limitada e p
 A OpenAI descarta preocupações com a desaceleração do crescimento e afirma que múltiplas unidades de negócio estão acelerando.
Em resposta à escrutínio externo sobre o desaceleramento do crescimento das vendas e o não cumprimento de metas internas, o líder em inteligência artificial, OpenAI, emitiu uma declaração confiante na terça-feira, 28 de abril. A empresa esclareceu qu
 Alibaba Super Cup: Qwen3.8-Max estreia com aprimoramento nas ferramentas de programação e escritório
A Alibaba revelou oficialmente o Qwen3.8-Max, um modelo de base de próxima geração com 2,4 trilhão de parâmetros. Este avanço significativo em IA oferece ganhos substanciais de desempenho em áreas principais, como programação e tarefas profissionais

2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai

As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de balões de diálogo com IA para narrativa visual de 2026 já estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que ajudam os criadores a aumentar a produtividade e superar gargalos criativos. Veja uma comparação entre versões gratuitas e pagas, confira testes reais e verifique os rankings mais recentes para encontrar as soluções imperdíveis, perfeitas para criar narrativas visuais envolventes. Explore agora e descubra sua ferramenta ideal!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de resumo de reuniões com IA de 2026 para um acompanhamento claro das decisões e acompanhamentos sem esforço. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam drasticamente a produtividade ao automatizar notas de reuniões, identificar ações-chave e otimizar a coordenação da equipe em todos os projetos. Veja uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente para ajudá-lo a encontrar a ferramenta perfeita. Explore agora para aproveitar ao máximo as vantagens da IA!
9 ferramentas
xix.ai

2026 – Os melhores e mais bem avaliados ferramentas de limpeza de dados com IA, atualizadas para corrigir rapidamente valores faltantes e duplicatas. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam significativamente a produtividade. Cada opção passou por testes rigorosos em condições reais para garantir sua confiabilidade. Acesse uma comparação gratuita entre as versões pagas e gratuitas e descubra a ferramenta indispensável que melhor atende às suas necessidades. Explore agora em XIX.AI para aproveitar todos os benefícios oferecidos pela IA.
11 ferramentas
xix.ai












