


 Дом
Команда Шанхайского университета Цзяотун представила тестовый набор SWE-Explore, выявивший недостатки локализации на уровне строк в кодирующих агентах ИИ
Международная исследовательская группа, в состав которой входит Шанхайский университет Цзяо Тун, сегодня представила SWE-Explore — новый инструмент для тестирования по эталонным показателям. Он позволяет количественно выявить существенные технические недостатки современных агентов по кодированию на основе ИИ на уровне «точности на уровне строк», отделяя процесс поиска кода от этапа фактического исправления. Данное исследование выходит за рамки прежней модели оценки, основанной исключительно на «конечном коэффициенте исправлений», предлагая новый стандарт для непосредственной оценки качества этапа предварительного поиска в агентах и способствуя развитию оценки программной инженерии на базе ИИ в более глубоких областях.
Традиционные тестовые наборы, такие как SWE-bench, часто маскируют реальные недостатки агентов на этапах чтения и понимания кода, поскольку они сосредоточены исключительно на конечных результатах. Чтобы решить эту проблему, исследовательская группа извлекла консенсусные сегменты кода из нескольких независимых путей решения на основе траекторий успешной работы основных крупных моделей, таких как GPT-5.4, Gemini3Pro, Claude Sonnet4.6 и Kimi K2.6, создав набор данных, содержащий 848 задач с дефектами на 10 языках программирования и в 203 проектах с открытым исходным кодом.
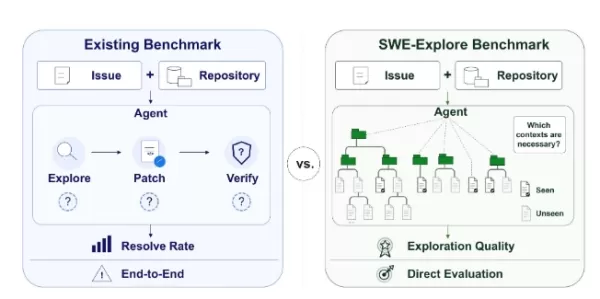
Результаты оценки показывают, что, хотя общие агенты кодирования, такие как Claude Code и OpenHands, демонстрируют хорошие результаты при позиционировании на «уровне файла», их охват ключевых областей резко падает до 14–19 %, когда внимание сосредотачивается на конкретных «строках кода». Эксперименты по абляции дополнительно подтвердили эффект «минимального порогового значения контекста»: когда видимая доля ключевых основных областей составляет менее 50%, исправление моделью, как правило, заканчивается неудачей; однако, как только она превышает пороговое значение от 50% до 75%, вероятность успешного исправления резко возрастает.
Результаты данного исследования указывают на то, что текущее «узкое место» для ИИ-агентов заключается не столько в способности писать патчи, сколько в точном фильтрировании и улавливании критически важного контекста. В современных условиях отрасли, когда руководители проектов отклоняют половину предложений по внедрению автоматизированных решений, техническое направление «меньше фильтрации, больше чтения», предложенное SWE-Explore, не только указывает путь к оптимизации архитектуры специализированных систем локализации кода следующего поколения (таких как CoSIL), но и ускоряет смену парадигмы автоматизированной разработки программного обеспечения с «генерации методом перебора» на «точный поиск».
Связанная статья
 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех
Рекомендации по связанным специальным темам
письмо
 Инструменты для создания плана статей с использованием ИИ при написании длинных текстов
2026: лучшие и самые популярные инструменты для создания планов статей с помощью ИИ для написания длинных текстов! В эту тщательно подобранную подборку вошли мощные, революционные инструменты, которые генерируют точные и структурированные планы, прошедшие проверку на практике, что позволяет значительно повысить эффективность написания текстов. XIX.AI входит в эту элитную подборку. Получите сравнение бесплатных и платных версий, чтобы выбрать идеальный инструмент. Изучите их прямо сейчас и раскройте свой потенциал с помощью ИИ!
 9 инструментов
 xix.ai
чат-бот
Лучшие приложения для ролевых чатов с ИИ для практики языка, подготовки к собеседованиям и ежедневной разговорной практики
2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты разделения стемов с использованием ИИ для создания ремиксов, подготовки образцов звука и формирования финальных версий караоке.
2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai
Анализ данных
ИИ-копилоты для SQL, предназначенные для создания панелей управления доходами, анализа воронки продаж и отслеживания показателей продуктов.
2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai
Музыкальная композиция
Лучшие инструменты для написания мелодий с помощью ИИ для черновиков песен
2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai
чат-бот
Лучшие инструменты для тренировки разговоров с помощью ИИ для подготовки к собеседованиям
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

 Комментарии (0)
Международная исследовательская группа, в состав которой входит Шанхайский университет Цзяо Тун, сегодня представила SWE-Explore — новый инструмент для тестирования по эталонным показателям. Он позволяет количественно выявить существенные технические недостатки современных агентов по кодированию на основе ИИ на уровне «точности на уровне строк», отделяя процесс поиска кода от этапа фактического исправления. Данное исследование выходит за рамки прежней модели оценки, основанной исключительно на «конечном коэффициенте исправлений», предлагая новый стандарт для непосредственной оценки качества этапа предварительного поиска в агентах и способствуя развитию оценки программной инженерии на базе ИИ в более глубоких областях.
Традиционные тестовые наборы, такие как SWE-bench, часто маскируют реальные недостатки агентов на этапах чтения и понимания кода, поскольку они сосредоточены исключительно на конечных результатах. Чтобы решить эту проблему, исследовательская группа извлекла консенсусные сегменты кода из нескольких независимых путей решения на основе траекторий успешной работы основных крупных моделей, таких как GPT-5.4, Gemini3Pro, Claude Sonnet4.6 и Kimi K2.6, создав набор данных, содержащий 848 задач с дефектами на 10 языках программирования и в 203 проектах с открытым исходным кодом.
Результаты оценки показывают, что, хотя общие агенты кодирования, такие как Claude Code и OpenHands, демонстрируют хорошие результаты при позиционировании на «уровне файла», их охват ключевых областей резко падает до 14–19 %, когда внимание сосредотачивается на конкретных «строках кода». Эксперименты по абляции дополнительно подтвердили эффект «минимального порогового значения контекста»: когда видимая доля ключевых основных областей составляет менее 50%, исправление моделью, как правило, заканчивается неудачей; однако, как только она превышает пороговое значение от 50% до 75%, вероятность успешного исправления резко возрастает.
Результаты данного исследования указывают на то, что текущее «узкое место» для ИИ-агентов заключается не столько в способности писать патчи, сколько в точном фильтрировании и улавливании критически важного контекста. В современных условиях отрасли, когда руководители проектов отклоняют половину предложений по внедрению автоматизированных решений, техническое направление «меньше фильтрации, больше чтения», предложенное SWE-Explore, не только указывает путь к оптимизации архитектуры специализированных систем локализации кода следующего поколения (таких как CoSIL), но и ускоряет смену парадигмы автоматизированной разработки программного обеспечения с «генерации методом перебора» на «точный поиск».








 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
 OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех

2026: лучшие и самые популярные инструменты для создания планов статей с помощью ИИ для написания длинных текстов! В эту тщательно подобранную подборку вошли мощные, революционные инструменты, которые генерируют точные и структурированные планы, прошедшие проверку на практике, что позволяет значительно повысить эффективность написания текстов. XIX.AI входит в эту элитную подборку. Получите сравнение бесплатных и платных версий, чтобы выбрать идеальный инструмент. Изучите их прямо сейчас и раскройте свой потенциал с помощью ИИ!
9 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
10 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai

2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai

2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai












