


 Maison
Une équipe de l'université Jiao Tong de Shanghai publie le benchmark SWE-Explore, mettant en évidence des failles de localisation au niveau des lignes de code chez les agents de codage basés sur l'IA
Une équipe de recherche internationale, à laquelle participe l’université Jiao Tong de Shanghai, a lancé aujourd’hui SWE-Explore, un nouvel outil de test de référence. Celui-ci met en évidence, de manière quantitative, d’importantes lacunes techniques des agents de codage IA actuels au niveau de la « précision au niveau de la ligne de code », en dissociant la recherche de code de la phase de correction proprement dite. Cette étude va au-delà du modèle d’évaluation unique précédent, qui reposait uniquement sur le « taux de correction final », en proposant une nouvelle norme permettant de mesurer directement la qualité de la recherche en amont chez les agents, et en faisant évoluer l’évaluation de l’ingénierie logicielle IA vers des domaines plus approfondis.
Les benchmarks traditionnels tels que SWE-bench masquent souvent les véritables défauts des agents lors des étapes de lecture et de compréhension du code, car ils se concentrent uniquement sur les résultats de bout en bout. Pour remédier à cela, l’équipe de recherche a extrait des segments de code consensuels à partir de multiples chemins de solution indépendants, en s’appuyant sur les trajectoires opérationnelles réussies de grands modèles courants tels que GPT-5.4, Gemini3Pro, Claude Sonnet4.6 et Kimi K2.6, et a constitué un ensemble de données comprenant 848 tâches de détection de défauts réparties sur 10 langages de programmation et 203 projets open source.
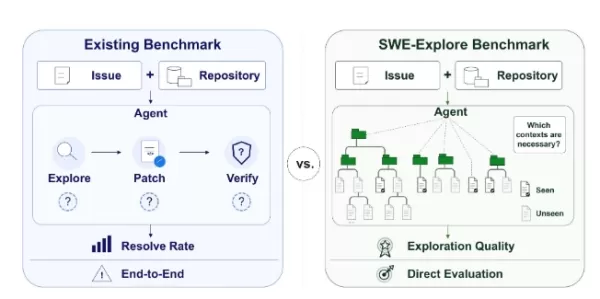
Les résultats d’évaluation montrent que, bien que les agents de codage généraux tels que Claude Code et OpenHands affichent de bonnes performances en matière de localisation « au niveau du fichier », leur couverture des zones clés chute brutalement pour se situer entre 14 % et 19 % lorsqu’ils se concentrent sur des « lignes de code » spécifiques. Des expériences d’ablation ont en outre confirmé l’effet du « seuil minimal de contexte » : lorsque la proportion visible des zones clés est inférieure à 50 %, la réparation par le modèle échoue généralement ; en revanche, dès que ce seuil est franchi (entre 50 % et 75 %), le taux de réussite de la réparation augmente considérablement.
Ce résultat de recherche indique que le goulot d’étranglement actuel pour les agents d’IA ne réside pas entièrement dans la capacité à rédiger des correctifs, mais plutôt dans la capacité à filtrer et à capturer avec précision le contexte critique. Dans le contexte actuel du secteur, où les chefs de projet rejettent la moitié des propositions d’adoption automatisée, l’orientation technique « moins de filtrage, plus de lecture » proposée par SWE-Explore ouvre non seulement la voie à l’optimisation architecturale des systèmes spécialisés de localisation de code de nouvelle génération (tels que CoSIL), mais accélère également le changement de paradigme de l’ingénierie logicielle automatisée, passant de la « génération par force brute » à la « recherche précise ».
Article connexe
 Meta supprime la fonction de retouche photo par IA suite aux critiques des utilisateurs
Meta, le géant des réseaux sociaux, est une fois de plus au cœur d’un débat public concernant l’équilibre délicat entre l’intelligence artificielle et la vie privée des utilisateurs. Selon TechCrunch, les Superintelligence Labs de Meta ont présenté u
PDG de DeepMind, Hassabis : Je dors six heures par jour et je me sens généralement plein d’énergie vers 1 h du matin.
Fortune a récemment publié une interview avec Demis Hassabis, PDG de Google DeepMind, révélant son approche non conventionnelle du repos et de la productivité. Hassabis a divulgué qu’il dort très peu, structurant ses heures d’éveil en deux blocs de t
OpenAI et Anthropic se disputent des parts de marché malgré des résultats en deçà des attentes
Bien que des informations récentes laissent entendre qu’OpenAI n’aurait pas atteint ses objectifs de chiffre d’affaires, ce qui a pesé sur les valeurs technologiques ce mardi, les investisseurs privés
Recommandations de sujets spéciaux liés
Création d'animations
 Outils d'animation de scènes basés sur l'IA pour les contenus destinés aux réseaux sociaux
XIX.AI vous présente ici les meilleurs outils d'animation de scènes par IA les mieux notés de 2026 pour les contenus destinés aux réseaux sociaux. Ces outils puissants et révolutionnaires font l'objet de tests en conditions réelles et d'une comparaison détaillée entre les versions gratuites et payantes, aidant ainsi les créateurs à booster considérablement leur productivité. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA.
 9 outils
 xix.ai
Création vidéo
Générateurs d'accroches pour vidéos courtes basés sur l'IA, destinés aux Reels, aux Shorts et aux campagnes de lancement de produits
Les meilleurs générateurs de accroches pour vidéos courtes basées sur l'IA en 2026 : pour Reels, Shorts et campagnes de lancement de produits ! XIX.AI sélectionne les outils les mieux notés, puissants et révolutionnaires, qui offrent des résultats incontournables grâce à des tests en conditions réelles. Cette page, mise à jour chaque semaine, propose des classements comparatifs entre les solutions gratuites et payantes pour vous aider à trouver la solution idéale afin de booster votre créativité et votre productivité en matière de contenu. Découvrez-la dès maintenant pour exploiter pleinement le potentiel de l’IA !
11 outils
xix.ai
en écrivant
Outils d'IA pour la structuration d'articles destinés à la rédaction de textes longs
2026 : les meilleurs outils d'aide à la rédaction de plans pour les textes longs, sélectionnés parmi les mieux notés ! Cette sélection rigoureuse regroupe des outils puissants et révolutionnaires qui fournissent des plans précis et structurés, validés par des tests concrets, afin d'améliorer considérablement l'efficacité de la rédaction. XIX.AI fait partie de cette sélection d'élite. Consultez notre comparatif entre les versions gratuites et payantes pour vous aider à choisir l'outil idéal. Découvrez-les dès maintenant et tirez parti de l'IA !
9 outils
xix.ai
chatbot
Meilleures applications de chat de jeu de rôle par IA pour la pratique des langues, la préparation aux entretiens et la fluidité quotidienne
2026 Dernières Meilleures Applications de Chat IA pour le Jeu de Rôle, les plus bien notées pour la Pratique des Langues, la Préparation aux Entretiens et la Fluidité Quotidienne ! XIX.AI sélectionne une collection puissante et révolutionnaire qui propose une comparaison gratuit vs payant, des tests en conditions réelles et des classements mis à jour chaque semaine. Ces outils à essayer absolument vous aident à améliorer vos compétences en écriture, à surmonter les défis de fluidité et à optimiser l’efficacité de la communication dans tous les scénarios quotidiens. Explorez dès maintenant pour découvrir l’outil parfait pour votre progression linguistique !
10 outils
xix.ai
Composition musicale
Outils de séparation des pistes audio par IA pour la production de remix, la préparation de samples et les masters de karaoké
2026 : Les meilleures et plus récentes outils de séparation des pistes audio par IA, hautement notés, sélectionnés spécialement pour la production de remix, la préparation de samples et l’enregistrement de karaokés. Ces outils puissants et révolutionnaires, éprouvés dans des conditions réelles, permettent une isolation audio précise, ce qui améliore considérablement la productivité. XIX.AI propose un guide de comparaison gratuit mis à jour chaque semaine entre les versions payantes et gratuites, afin de vous aider à trouver la solution idéale adaptée à vos besoins. Découvrez-les dès maintenant pour tirer parti des avantages offerts par l’IA.
8 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l’IA pour les tableaux de bord de chiffre d’affaires, l’analyse des funnels et les indicateurs de produits
2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
9 outils
xix.ai

 commentaires (0)
Une équipe de recherche internationale, à laquelle participe l’université Jiao Tong de Shanghai, a lancé aujourd’hui SWE-Explore, un nouvel outil de test de référence. Celui-ci met en évidence, de manière quantitative, d’importantes lacunes techniques des agents de codage IA actuels au niveau de la « précision au niveau de la ligne de code », en dissociant la recherche de code de la phase de correction proprement dite. Cette étude va au-delà du modèle d’évaluation unique précédent, qui reposait uniquement sur le « taux de correction final », en proposant une nouvelle norme permettant de mesurer directement la qualité de la recherche en amont chez les agents, et en faisant évoluer l’évaluation de l’ingénierie logicielle IA vers des domaines plus approfondis.
Les benchmarks traditionnels tels que SWE-bench masquent souvent les véritables défauts des agents lors des étapes de lecture et de compréhension du code, car ils se concentrent uniquement sur les résultats de bout en bout. Pour remédier à cela, l’équipe de recherche a extrait des segments de code consensuels à partir de multiples chemins de solution indépendants, en s’appuyant sur les trajectoires opérationnelles réussies de grands modèles courants tels que GPT-5.4, Gemini3Pro, Claude Sonnet4.6 et Kimi K2.6, et a constitué un ensemble de données comprenant 848 tâches de détection de défauts réparties sur 10 langages de programmation et 203 projets open source.
Les résultats d’évaluation montrent que, bien que les agents de codage généraux tels que Claude Code et OpenHands affichent de bonnes performances en matière de localisation « au niveau du fichier », leur couverture des zones clés chute brutalement pour se situer entre 14 % et 19 % lorsqu’ils se concentrent sur des « lignes de code » spécifiques. Des expériences d’ablation ont en outre confirmé l’effet du « seuil minimal de contexte » : lorsque la proportion visible des zones clés est inférieure à 50 %, la réparation par le modèle échoue généralement ; en revanche, dès que ce seuil est franchi (entre 50 % et 75 %), le taux de réussite de la réparation augmente considérablement.
Ce résultat de recherche indique que le goulot d’étranglement actuel pour les agents d’IA ne réside pas entièrement dans la capacité à rédiger des correctifs, mais plutôt dans la capacité à filtrer et à capturer avec précision le contexte critique. Dans le contexte actuel du secteur, où les chefs de projet rejettent la moitié des propositions d’adoption automatisée, l’orientation technique « moins de filtrage, plus de lecture » proposée par SWE-Explore ouvre non seulement la voie à l’optimisation architecturale des systèmes spécialisés de localisation de code de nouvelle génération (tels que CoSIL), mais accélère également le changement de paradigme de l’ingénierie logicielle automatisée, passant de la « génération par force brute » à la « recherche précise ».








 Meta supprime la fonction de retouche photo par IA suite aux critiques des utilisateurs
Meta, le géant des réseaux sociaux, est une fois de plus au cœur d’un débat public concernant l’équilibre délicat entre l’intelligence artificielle et la vie privée des utilisateurs. Selon TechCrunch, les Superintelligence Labs de Meta ont présenté u
 PDG de DeepMind, Hassabis : Je dors six heures par jour et je me sens généralement plein d’énergie vers 1 h du matin.
Fortune a récemment publié une interview avec Demis Hassabis, PDG de Google DeepMind, révélant son approche non conventionnelle du repos et de la productivité. Hassabis a divulgué qu’il dort très peu, structurant ses heures d’éveil en deux blocs de t
 OpenAI et Anthropic se disputent des parts de marché malgré des résultats en deçà des attentes
Bien que des informations récentes laissent entendre qu’OpenAI n’aurait pas atteint ses objectifs de chiffre d’affaires, ce qui a pesé sur les valeurs technologiques ce mardi, les investisseurs privés

XIX.AI vous présente ici les meilleurs outils d'animation de scènes par IA les mieux notés de 2026 pour les contenus destinés aux réseaux sociaux. Ces outils puissants et révolutionnaires font l'objet de tests en conditions réelles et d'une comparaison détaillée entre les versions gratuites et payantes, aidant ainsi les créateurs à booster considérablement leur productivité. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA.
9 outils
xix.ai

Les meilleurs générateurs de accroches pour vidéos courtes basées sur l'IA en 2026 : pour Reels, Shorts et campagnes de lancement de produits ! XIX.AI sélectionne les outils les mieux notés, puissants et révolutionnaires, qui offrent des résultats incontournables grâce à des tests en conditions réelles. Cette page, mise à jour chaque semaine, propose des classements comparatifs entre les solutions gratuites et payantes pour vous aider à trouver la solution idéale afin de booster votre créativité et votre productivité en matière de contenu. Découvrez-la dès maintenant pour exploiter pleinement le potentiel de l’IA !
11 outils
xix.ai

2026 : les meilleurs outils d'aide à la rédaction de plans pour les textes longs, sélectionnés parmi les mieux notés ! Cette sélection rigoureuse regroupe des outils puissants et révolutionnaires qui fournissent des plans précis et structurés, validés par des tests concrets, afin d'améliorer considérablement l'efficacité de la rédaction. XIX.AI fait partie de cette sélection d'élite. Consultez notre comparatif entre les versions gratuites et payantes pour vous aider à choisir l'outil idéal. Découvrez-les dès maintenant et tirez parti de l'IA !
9 outils
xix.ai

2026 Dernières Meilleures Applications de Chat IA pour le Jeu de Rôle, les plus bien notées pour la Pratique des Langues, la Préparation aux Entretiens et la Fluidité Quotidienne ! XIX.AI sélectionne une collection puissante et révolutionnaire qui propose une comparaison gratuit vs payant, des tests en conditions réelles et des classements mis à jour chaque semaine. Ces outils à essayer absolument vous aident à améliorer vos compétences en écriture, à surmonter les défis de fluidité et à optimiser l’efficacité de la communication dans tous les scénarios quotidiens. Explorez dès maintenant pour découvrir l’outil parfait pour votre progression linguistique !
10 outils
xix.ai

2026 : Les meilleures et plus récentes outils de séparation des pistes audio par IA, hautement notés, sélectionnés spécialement pour la production de remix, la préparation de samples et l’enregistrement de karaokés. Ces outils puissants et révolutionnaires, éprouvés dans des conditions réelles, permettent une isolation audio précise, ce qui améliore considérablement la productivité. XIX.AI propose un guide de comparaison gratuit mis à jour chaque semaine entre les versions payantes et gratuites, afin de vous aider à trouver la solution idéale adaptée à vos besoins. Découvrez-les dès maintenant pour tirer parti des avantages offerts par l’IA.
8 outils
xix.ai

2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
9 outils
xix.ai












