


 Lar
Equipe da Universidade Jiao Tong de Xangai lança o benchmark SWE-Explore, revelando falhas de localização em nível de linha em agentes de codificação baseados em IA
Uma equipe internacional de pesquisa, da qual faz parte a Universidade Jiao Tong de Xangai, lançou hoje o SWE-Explore, uma nova ferramenta de testes de benchmark. Ela revela quantitativamente deficiências técnicas significativas dos atuais agentes de codificação de IA no que diz respeito à “precisão em nível de linha”, ao separar a busca de código da fase de correção propriamente dita. Este estudo vai além do modelo de avaliação único anterior, que se baseava exclusivamente na “taxa de correção final”, oferecendo um novo padrão para medir diretamente a qualidade da busca inicial nos agentes e impulsionando a evolução da avaliação da engenharia de software de IA em áreas mais aprofundadas.
Benchmarks tradicionais, como o SWE-bench, muitas vezes mascaram os defeitos reais dos agentes nas etapas de leitura e compreensão de código, pois se concentram apenas nos resultados de ponta a ponta. Para resolver isso, a equipe de pesquisa extraiu segmentos de código consensuais de múltiplos caminhos de solução independentes, com base nas trajetórias de operação bem-sucedidas de grandes modelos convencionais, como o GPT-5.4, Gemini3Pro, Claude Sonnet4.6 e Kimi K2.6, construindo um conjunto de dados contendo 848 tarefas com defeitos em 10 linguagens de programação e 203 projetos de código aberto.
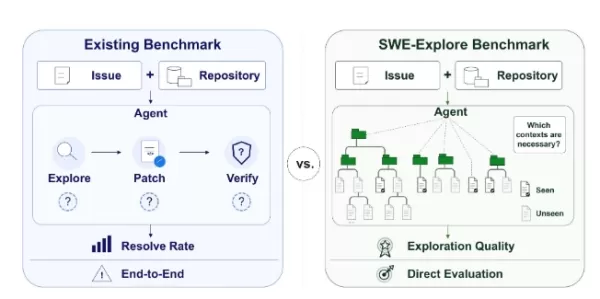
Os resultados da avaliação mostram que, embora agentes de codificação gerais como o Claude Code e o OpenHands apresentem bom desempenho no posicionamento “no nível do arquivo”, sua cobertura da área central cai drasticamente para entre 14% e 19% quando o foco está em “linhas de código” específicas. Experimentos de ablação confirmaram ainda mais o efeito do “limite mínimo de contexto”: quando a proporção visível das principais áreas centrais fica abaixo de 50%, a correção do modelo geralmente falha; no entanto, assim que ultrapassa o limite de 50% a 75%, a taxa de sucesso da correção aumenta drasticamente.
Esse resultado da pesquisa indica que o gargalo atual para os agentes de IA não se refere inteiramente à capacidade de escrever patches, mas sim à filtragem e captura precisas do contexto crítico. No contexto atual do setor, em que gerentes de projeto rejeitam metade das propostas de adoção automatizada, a direção técnica “menos filtragem, mais leitura” proposta pelo SWE-Explore não apenas aponta o caminho para a otimização da arquitetura de sistemas especializados de localização de código de última geração (como o CoSIL), mas também acelera a mudança de paradigma da engenharia de software automatizada, passando da “geração por força bruta” para a “recuperação precisa”.
Artigo relacionado
 CEO da DeepMind, Hassabis: Durmo seis horas por dia, geralmente me sinto energético por volta da 1h
O Fortune recentemente publicou uma entrevista com Demis Hassabis, CEO da Google DeepMind, revelando sua abordagem incomum para descanso e produtividade. Hassabis revelou que dorme muito pouco, estruturando suas horas acordadas em dois blocos de trab
OpenAI e Anthropic disputam participação no mercado, apesar da queda na receita
Apesar de relatos recentes sugerirem que a OpenAI não atingiu suas metas de receita, o que gerou pressão sobre as ações do setor de tecnologia nesta terça-feira, os investidores privados em laboratóri
Conformidade com a regulamentação de veículos autônomos na Califórnia: uma nova era de multas, geocercas e 1 milhão de milhas
A Guident opera um veículo de transporte da AuveTech no sul da Flórida, administrando uma rota de quatro milhas em West Palm Beach e uma rota de uma milha em Boca Raton por meio de sua tecnologia de m
Recomendações de tópicos especiais relacionados
escrita
 Ferramentas de IA para esboço de artigos em formato longo
2026: As melhores e mais bem avaliadas ferramentas de esboço com IA para redação de textos longos! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que geram esboços precisos e estruturados, comprovados em testes reais, para aumentar significativamente a eficiência na redação. A XIX.AI faz parte dessa seleção de elite. Veja uma comparação entre as versões gratuita e paga para ajudá-lo a escolher a ferramenta perfeita. Explore agora e descubra sua vantagem com a IA!
 9 ferramentas
 xix.ai
chatbot
Melhores aplicativos de chat de interpretação de papéis com IA para prática de idiomas, preparação para entrevistas e fluência diária
2026 Últimas Melhores Aplicativos de Chat de Interpretação de Papéis por IA Mais Bem Avaliados para Prática de Idiomas, Preparação para Entrevistas e Fluência Diária! O XIX.AI seleciona uma poderosa coleção revolucionária que oferece comparação entre gratuito e pago, testes do mundo real e classificações atualizadas semanalmente. Essas ferramentas imperdíveis ajudam você a aprimorar suas habilidades de escrita, superar desafios de fluência e melhorar a eficiência da comunicação em todos os cenários diários. Explore agora para descobrir sua ferramenta perfeita para o crescimento do idioma!
10 ferramentas
xix.ai
Composição musical
Ferramentas de separação de stems com IA para produção de remixes, preparação de samples e masters de karaokê
As melhores e mais bem avaliadas ferramentas de separação de faixas com IA de 2026, selecionadas especialmente para produção de remixes, preparação de samples e masters de karaokê. Essas ferramentas poderosas e revolucionárias passaram por testes práticos para oferecer isolamento de áudio preciso, aumentando significativamente a produtividade. A XIX.AI oferece um guia comparativo entre versões gratuitas e pagas, atualizado semanalmente, para ajudá-lo a encontrar a solução imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Análise de dados
Copilotos de IA para SQL voltados para painéis de receita, análise de funis e métricas de produtos
2026: Os melhores copilotos AI para SQL, atualizados e classificados entre os melhores! A XIX.AI reúne uma coleção poderosa e revolucionária, com testes em ambiente real atualizados semanalmente. Essas ferramentas indispensáveis ajudam a gerar painéis de controle de receita precisos, analisar funis de vendas e rastrear métricas de produtos de forma rápida, aumentando significativamente a produtividade. Explore agora e encontre a ferramenta perfeita para tomada de decisões baseadas em dados! 238 caracteres
9 ferramentas
xix.ai
Composição musical
Melhores Ferramentas de IA para Criação de Melodias para Rascunhos de Músicas
2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai
chatbot
Melhores ferramentas de treinamento de conversação com IA para prática de entrevistas
As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai

 Comentários (0)
Uma equipe internacional de pesquisa, da qual faz parte a Universidade Jiao Tong de Xangai, lançou hoje o SWE-Explore, uma nova ferramenta de testes de benchmark. Ela revela quantitativamente deficiências técnicas significativas dos atuais agentes de codificação de IA no que diz respeito à “precisão em nível de linha”, ao separar a busca de código da fase de correção propriamente dita. Este estudo vai além do modelo de avaliação único anterior, que se baseava exclusivamente na “taxa de correção final”, oferecendo um novo padrão para medir diretamente a qualidade da busca inicial nos agentes e impulsionando a evolução da avaliação da engenharia de software de IA em áreas mais aprofundadas.
Benchmarks tradicionais, como o SWE-bench, muitas vezes mascaram os defeitos reais dos agentes nas etapas de leitura e compreensão de código, pois se concentram apenas nos resultados de ponta a ponta. Para resolver isso, a equipe de pesquisa extraiu segmentos de código consensuais de múltiplos caminhos de solução independentes, com base nas trajetórias de operação bem-sucedidas de grandes modelos convencionais, como o GPT-5.4, Gemini3Pro, Claude Sonnet4.6 e Kimi K2.6, construindo um conjunto de dados contendo 848 tarefas com defeitos em 10 linguagens de programação e 203 projetos de código aberto.
Os resultados da avaliação mostram que, embora agentes de codificação gerais como o Claude Code e o OpenHands apresentem bom desempenho no posicionamento “no nível do arquivo”, sua cobertura da área central cai drasticamente para entre 14% e 19% quando o foco está em “linhas de código” específicas. Experimentos de ablação confirmaram ainda mais o efeito do “limite mínimo de contexto”: quando a proporção visível das principais áreas centrais fica abaixo de 50%, a correção do modelo geralmente falha; no entanto, assim que ultrapassa o limite de 50% a 75%, a taxa de sucesso da correção aumenta drasticamente.
Esse resultado da pesquisa indica que o gargalo atual para os agentes de IA não se refere inteiramente à capacidade de escrever patches, mas sim à filtragem e captura precisas do contexto crítico. No contexto atual do setor, em que gerentes de projeto rejeitam metade das propostas de adoção automatizada, a direção técnica “menos filtragem, mais leitura” proposta pelo SWE-Explore não apenas aponta o caminho para a otimização da arquitetura de sistemas especializados de localização de código de última geração (como o CoSIL), mas também acelera a mudança de paradigma da engenharia de software automatizada, passando da “geração por força bruta” para a “recuperação precisa”.








 CEO da DeepMind, Hassabis: Durmo seis horas por dia, geralmente me sinto energético por volta da 1h
O Fortune recentemente publicou uma entrevista com Demis Hassabis, CEO da Google DeepMind, revelando sua abordagem incomum para descanso e produtividade. Hassabis revelou que dorme muito pouco, estruturando suas horas acordadas em dois blocos de trab
 OpenAI e Anthropic disputam participação no mercado, apesar da queda na receita
Apesar de relatos recentes sugerirem que a OpenAI não atingiu suas metas de receita, o que gerou pressão sobre as ações do setor de tecnologia nesta terça-feira, os investidores privados em laboratóri
Conformidade com a regulamentação de veículos autônomos na Califórnia: uma nova era de multas, geocercas e 1 milhão de milhas
A Guident opera um veículo de transporte da AuveTech no sul da Flórida, administrando uma rota de quatro milhas em West Palm Beach e uma rota de uma milha em Boca Raton por meio de sua tecnologia de m

2026: As melhores e mais bem avaliadas ferramentas de esboço com IA para redação de textos longos! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que geram esboços precisos e estruturados, comprovados em testes reais, para aumentar significativamente a eficiência na redação. A XIX.AI faz parte dessa seleção de elite. Veja uma comparação entre as versões gratuita e paga para ajudá-lo a escolher a ferramenta perfeita. Explore agora e descubra sua vantagem com a IA!
9 ferramentas
xix.ai

2026 Últimas Melhores Aplicativos de Chat de Interpretação de Papéis por IA Mais Bem Avaliados para Prática de Idiomas, Preparação para Entrevistas e Fluência Diária! O XIX.AI seleciona uma poderosa coleção revolucionária que oferece comparação entre gratuito e pago, testes do mundo real e classificações atualizadas semanalmente. Essas ferramentas imperdíveis ajudam você a aprimorar suas habilidades de escrita, superar desafios de fluência e melhorar a eficiência da comunicação em todos os cenários diários. Explore agora para descobrir sua ferramenta perfeita para o crescimento do idioma!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de separação de faixas com IA de 2026, selecionadas especialmente para produção de remixes, preparação de samples e masters de karaokê. Essas ferramentas poderosas e revolucionárias passaram por testes práticos para oferecer isolamento de áudio preciso, aumentando significativamente a produtividade. A XIX.AI oferece um guia comparativo entre versões gratuitas e pagas, atualizado semanalmente, para ajudá-lo a encontrar a solução imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

2026: Os melhores copilotos AI para SQL, atualizados e classificados entre os melhores! A XIX.AI reúne uma coleção poderosa e revolucionária, com testes em ambiente real atualizados semanalmente. Essas ferramentas indispensáveis ajudam a gerar painéis de controle de receita precisos, analisar funis de vendas e rastrear métricas de produtos de forma rápida, aumentando significativamente a produtividade. Explore agora e encontre a ferramenta perfeita para tomada de decisões baseadas em dados! 238 caracteres
9 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai

As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai












