


 Heim
Team der Shanghai Jiao Tong University veröffentlicht den SWE-Explore-Benchmark und deckt Schwachstellen bei der Lokalisierung auf Zeilenebene in KI-Codierungsagenten auf
Ein internationales Forschungsteam, zu dem auch die Shanghai Jiao Tong University gehört, hat heute SWE-Explore vorgestellt, ein neues Benchmark-Testtool. Es deckt quantitative technische Defizite aktueller KI-Codierungsagenten auf der Ebene der „Zeilen-Genauigkeit“ auf, indem es die Codesuche von der eigentlichen Reparaturphase entkoppelt. Diese Studie geht über das bisherige Einzelbewertungsmodell hinaus, das sich ausschließlich auf die „endgültige Reparaturrate“ stützte, und bietet einen neuen Standard zur direkten Messung der Qualität der vorgelagerten Suche in Agenten. Damit treibt sie die Weiterentwicklung der Bewertung im Bereich der KI-Softwareentwicklung in tiefgreifendere Bereiche voran.
Herkömmliche Benchmarks wie SWE-bench verschleiern oft die tatsächlichen Mängel der Agenten in den Phasen des Code-Lesens und -Verstehens, da sie sich ausschließlich auf End-to-End-Ergebnisse konzentrieren. Um diesem Problem zu begegnen, extrahierte das Forschungsteam Konsens-Code-Segmente aus mehreren unabhängigen Lösungspfaden auf der Grundlage der erfolgreichen Betriebsverläufe gängiger großer Modelle wie GPT-5.4, Gemini3Pro, Claude Sonnet4.6 und Kimi K2.6 extrahierte das Forschungsteam Konsens-Code-Segmente aus mehreren unabhängigen Lösungswegen und erstellte einen Datensatz mit 848 Fehleraufgaben in 10 Programmiersprachen und 203 Open-Source-Projekten.
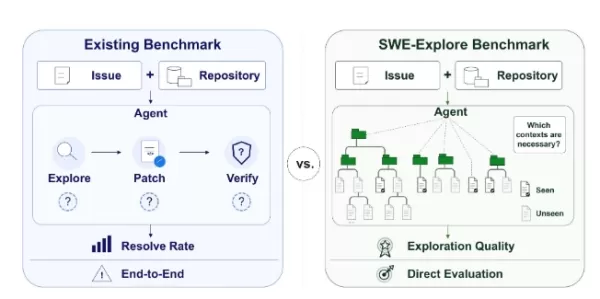
Die Auswertungsergebnisse zeigen, dass allgemeine Programmieragenten wie Claude Code und OpenHands zwar bei der Positionierung auf „Dateiebene“ gute Leistungen erbringen, ihre Abdeckung der Kernbereiche jedoch stark auf 14 % bis 19 % abfällt, wenn der Fokus auf bestimmte „Codezeilen“ gelegt wird. Ablationsexperimente bestätigten zudem den Effekt der „minimalen Kontextschwelle“: Liegt der sichtbare Anteil der zentralen Kernbereiche unter 50 %, schlägt die Fehlerbehebung des Modells in der Regel fehl; sobald jedoch die Schwelle von 50 % bis 75 % überschritten wird, steigt die Erfolgsquote der Fehlerbehebung dramatisch an.
Dieses Forschungsergebnis deutet darauf hin, dass der derzeitige Engpass für KI-Agenten nicht ausschließlich in der Fähigkeit zum Schreiben von Patches liegt, sondern vielmehr im präzisen Filtern und Erfassen kritischer Kontexte. Im aktuellen Branchenkontext, in dem Projektmanager die Hälfte der Vorschläge zur automatisierten Einführung ablehnen, zeigt die von SWE-Explore vorgeschlagene technische Ausrichtung „weniger filtern, mehr lesen“ nicht nur den Weg für die Architekturoptimierung spezialisierter Code-Lokalisierungssysteme der nächsten Generation (wie CoSIL), sondern beschleunigt auch den Paradigmenwechsel im automatisierten Software-Engineering von der „Brute-Force-Generierung“ hin zum „präzisen Abruf“.
Verwandter Artikel
 DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter
Einhaltung der Vorschriften für autonome Fahrzeuge in Kalifornien: Eine neue Ära von Bußgeldern, Geofences und 1 Million Meilen
Guident betreibt einen AuveTech-Shuttle in Südflorida und verwaltet mithilfe seiner Fernüberwachungstechnologie eine vier Meilen lange Strecke in West Palm Beach sowie eine eine Meile lange Strecke in
Empfehlungen zu verwandten Spezialthemen
Chatbot
 Die besten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprechflüssigkeit
2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
 10 Tools
 xix.ai
Musikkomposition
KI-Tools zur Stim-Trennung für die Remix-Produktion, die Vorbereitung von Samples und Karaoke-Master
Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai
Datenanalyse
KI-basierte SQL-Copiloten für Umsatz-Dashboards, Kanalanalysen sowie Produktmetriken
2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai
Musikkomposition
Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai
Chatbot
Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai
Design & Kunst
Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

 Kommentare (0)
Ein internationales Forschungsteam, zu dem auch die Shanghai Jiao Tong University gehört, hat heute SWE-Explore vorgestellt, ein neues Benchmark-Testtool. Es deckt quantitative technische Defizite aktueller KI-Codierungsagenten auf der Ebene der „Zeilen-Genauigkeit“ auf, indem es die Codesuche von der eigentlichen Reparaturphase entkoppelt. Diese Studie geht über das bisherige Einzelbewertungsmodell hinaus, das sich ausschließlich auf die „endgültige Reparaturrate“ stützte, und bietet einen neuen Standard zur direkten Messung der Qualität der vorgelagerten Suche in Agenten. Damit treibt sie die Weiterentwicklung der Bewertung im Bereich der KI-Softwareentwicklung in tiefgreifendere Bereiche voran.
Herkömmliche Benchmarks wie SWE-bench verschleiern oft die tatsächlichen Mängel der Agenten in den Phasen des Code-Lesens und -Verstehens, da sie sich ausschließlich auf End-to-End-Ergebnisse konzentrieren. Um diesem Problem zu begegnen, extrahierte das Forschungsteam Konsens-Code-Segmente aus mehreren unabhängigen Lösungspfaden auf der Grundlage der erfolgreichen Betriebsverläufe gängiger großer Modelle wie GPT-5.4, Gemini3Pro, Claude Sonnet4.6 und Kimi K2.6 extrahierte das Forschungsteam Konsens-Code-Segmente aus mehreren unabhängigen Lösungswegen und erstellte einen Datensatz mit 848 Fehleraufgaben in 10 Programmiersprachen und 203 Open-Source-Projekten.
Die Auswertungsergebnisse zeigen, dass allgemeine Programmieragenten wie Claude Code und OpenHands zwar bei der Positionierung auf „Dateiebene“ gute Leistungen erbringen, ihre Abdeckung der Kernbereiche jedoch stark auf 14 % bis 19 % abfällt, wenn der Fokus auf bestimmte „Codezeilen“ gelegt wird. Ablationsexperimente bestätigten zudem den Effekt der „minimalen Kontextschwelle“: Liegt der sichtbare Anteil der zentralen Kernbereiche unter 50 %, schlägt die Fehlerbehebung des Modells in der Regel fehl; sobald jedoch die Schwelle von 50 % bis 75 % überschritten wird, steigt die Erfolgsquote der Fehlerbehebung dramatisch an.
Dieses Forschungsergebnis deutet darauf hin, dass der derzeitige Engpass für KI-Agenten nicht ausschließlich in der Fähigkeit zum Schreiben von Patches liegt, sondern vielmehr im präzisen Filtern und Erfassen kritischer Kontexte. Im aktuellen Branchenkontext, in dem Projektmanager die Hälfte der Vorschläge zur automatisierten Einführung ablehnen, zeigt die von SWE-Explore vorgeschlagene technische Ausrichtung „weniger filtern, mehr lesen“ nicht nur den Weg für die Architekturoptimierung spezialisierter Code-Lokalisierungssysteme der nächsten Generation (wie CoSIL), sondern beschleunigt auch den Paradigmenwechsel im automatisierten Software-Engineering von der „Brute-Force-Generierung“ hin zum „präzisen Abruf“.








 DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
 OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter
Einhaltung der Vorschriften für autonome Fahrzeuge in Kalifornien: Eine neue Ära von Bußgeldern, Geofences und 1 Million Meilen
Guident betreibt einen AuveTech-Shuttle in Südflorida und verwaltet mithilfe seiner Fernüberwachungstechnologie eine vier Meilen lange Strecke in West Palm Beach sowie eine eine Meile lange Strecke in

2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai












