


 Дом
Meitun Search 3.0 использует крупномасштабные модели для перестройки инфраструктуры поиска информации о повседневной жизни в местных сообществах
По мере развития технологий крупных языковых моделей (LLM) поисковые системы переживают третий сдвиг парадигмы, переходя от традиционного сопоставления текста по ключевым словам к эре 3.0, ориентированной на понимание сложных намерений и когнитивное принятие решений. Недавно техническая команда Meituan опубликовала подробный технический анализ, в котором подробно описаны три итерации Meituan Search 3.0 в контексте ранжирования услуг розничной торговли, а также изложены пути внедрения и основная ценность семантического представления LLM в сложных контекстах повседневной жизни.
I. Прорыв в сфере розничной торговли услугами: от традиционного лексического сопоставления к семантической реконструкции с помощью LLM
Розничная торговля услугами принципиально отличается от розничной торговли товарами по своей бизнес-модели. В отличие от высокостандартизированной розничной торговли товарами, розничная торговля услугами Meituan и сценарии местного образа жизни характеризуются разнообразными категориями, разнообразными поисковыми запросами (транзакционные, информационные и направленные на привлечение потенциальных клиентов) и крайне нестандартизированным предложением.
В повседневных поисковых запросах традиционные модели ранжирования в значительной степени полагаются на лексическое сопоставление. Однако при работе с огромным количеством категорий «длинного хвоста» и сложными намерениями пользователей способность традиционного проектирования признаков к обобщению явно недостаточна. Например, когда пользователь ищет «спа для домашних животных + купание», соответствующее название продавца или товара может звучать как «Пакет услуг по уходу и чистке домашних животных»; при поиске «весеннюю уборку» — как «Пакет услуг по генеральной уборке». В таких типичных случаях на первый взгляд пересечения между запросом и предложением практически нет, но их глубинная семантика тесно связана.
Чтобы преодолеть этот традиционный семантический разрыв, команда Meituan по ранжированию поисковых запросов в сфере розничных услуг в течение последнего года систематически изучала возможности применения LLM в моделях ранжирования. Генерируя высококачественные семантические векторные представления для поисковых запросов (Query), продавцов (POI) и предложений (Deal), они внедрили сигналы семантического сопоставления в модель ранжирования с использованием косинусного сходства, что позволило совершить скачок от точечной проверки признаков к систематической реконструкции, а затем — к межсценарийной миграции и повторному использованию.
II. Три этапа технической эволюции: от проверки осуществимости до полномасштабного построения системы
1. Этап I: внедрение семантических представлений LLM в ранжирование (проверка осуществимости)
На первом этапе основная цель команды была проста: проверить, могут ли представления LLM оказать существенную помощь модели ранжирования.
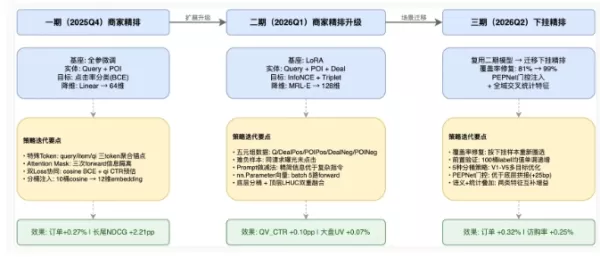
Технический дизайн: для полной настройки параметров была выбрана базовая модель с открытым исходным кодом и небольшим набором параметров, при этом в словарь были введены специальные токены в качестве анкерных элементов для агрегации. Маски внимания были тщательно разработаны для отделения запросов от информации о продавцах. Внедрение признаков: после того как модель сгенерировала вложения, рассчитывалось косинусное сходство и дискретно группировалось, а затем объединялось в качестве обучаемых вложений в признаки модели ранжирования. Результаты в режиме онлайн: офлайн-валидация показала значительное улучшение показателя NDCG по кликам. После развертывания наблюдался значительный рост общего количества платежных заказов по результатам поиска и розничных заказов на услуги, особенно в сценариях «длинного хвоста», где традиционное лексическое сопоставление было наиболее слабым, при этом количество некорректных результатов заметно сократилось. Это напрямую подтвердило огромный потенциал семантического представления LLM в сценарии ранжирования.2. Этап II: Систематическое усовершенствование представлений ранжирования продавцов
Устраняя проблемные моменты, выявленные на этапе I, такие как отсутствие семантического представления со стороны товаров, высокие затраты на полную настройку параметров и неполные цели оптимизации, на этапе II была проведена систематическая реконструкция всего процесса формирования представлений.
Пятерки и контрастивное обучение: был создан обучающий набор данных в виде пятерок, включающий запрос, положительные образцы товаров, положительные образцы продавцов и сложные отрицательные образцы. От традиционной задачи бинарной классификации полностью отказались, а вместо этого были в полной мере внедрены функции потерь InfoNCE и Triplet Loss, что идеально решило проблему «относительного порядка среди нескольких кандидатов», которая действительно важна для модели ранжирования.Легкое и эффективное извлечение: при переходе от тонкой настройки всех параметров к методам LoRA старый подход был заменен независимыми последовательностями и обучаемыми векторами, а снижение размерности было модернизировано до MRL-E (Matryoshka Representation Learning), что повысило эффективность обучения и инференса, одновременно поддерживая гибкие многомасштабные приложения. Результаты онлайн-тестирования: Показатели GAUC по кликам и эффективность конверсии в рейтинге продавцов значительно улучшились. Онлайн-данные продемонстрировали значительный рост эффективных кликов и коэффициента конверсии на странице результатов (QV_CTR), что полностью подтверждает: семантическое представление LLM не только открывает больше возможностей для показа, но и оптимизирует общее качество конверсии за счет точных рекомендаций.3. Этап III: внедрение представлений и кросс-особенностей в последующий этап ранжирования
После завершения систематической реконструкции ранжирования продавцов команда далее применила отработанное решение к последующему ранжированию (т. е. ранжированию конкретных товаров в рамках одного продавца), одновременно совершенствуя управление и дополнение кросс-статистических признаков по всему спектру.
Решение проблем с охватом: из-за фундаментальных различий в распределении запросов между ранжированием продавцов и последующим ранжированием при первоначальном переносе возникли проблемы с низким охватом запросов. Благодаря тонкой настройке и управлению данными на обоих концах команде удалось плавно расширить возможности семантического представления LLM на уровень товаров. Параллельный прогресс: благодаря сочетанию «переноса представлений LLM» с моделированием межмерных взаимосвязей, таких как «персонализация × товар» и «намерение запроса × товар», точность результатов поиска сделала очередной скачок.III. Подведение итогов и перспективы
Эволюция Meituan Search 3.0 показывает, что применение LLM в сфере локальных услуг повседневной жизни — это не мгновенный успех, а требует прохождения четкого пути от точечной валидации характеристик, систематической реконструкции представлений до обобщения и повторного использования в различных сценариях. Преобразовав мощные возможности LLM по семантическому пониманию в плотные непрерывные представления и дискретные биновые признаки, Meituan успешно преодолел барьеры между сложными намерениями и нестандартизированным предложением в сценариях розничной торговли услугами, предоставив пользователям более точный и интеллектуальный опыт поиска местных услуг и развлечений.
Связанная статья
 ChatGPT пережил масштабный сбой, миллионы пользователей столкнулись с проблемами при входе в систему
Стабильность работы серверов по-прежнему остается одним из ключевых приоритетов в сфере искусственного интеллекта. Согласно отчетам, ChatGPT — ведущая в мире чат-платформа на базе ИИ — около 20 август
Moonshot Ventures может провести IPO в Гонконге для финансирования масштабного развития больших моделей
Bloomberg сообщает, что ведущая китайская компания в сфере искусственного интеллекта Moonshot AI рассматривает возможность проведения IPO в Гонконге.Компания Moonshot AI из Пекина, создатель популярно
Marvis представляет функцию создания индивидуальных моделей, интегрирующую GLM от Kimi и Zhipu
1 сентября Marvis, искусственный интеллект на уровне операционной системы от Tencent, официально запустил функцию «Пользовательская модель». Это обновление позволяет пользователям легко интегрировать
Рекомендации по связанным специальным темам
Производительность
 Лучшие помощники с функцией AI Focus: сократите время переключения между задачами и не сбивайтесь с курса
2026: лучшие и самые популярные помощники с ИИ, отобранные специально для сокращения времени переключения между задачами и поддержания вашей продуктивности в течение всего дня. Эти мощные инструменты проходят тщательные тесты в реальных условиях; представлены сравнения бесплатных и платных версий, а также еженедельно обновляемые рейтинги. Найдите свой идеальный инструмент, чтобы повысить эффективность написания текстов, раскрыть творческий потенциал и сохранять концентрацию без отвлекающих факторов. Посетите сайт XIX.AI прямо сейчас, чтобы раскрыть свой потенциал с помощью ИИ.
 9 инструментов
 xix.ai
письмо
Лучшие инструменты ИИ для редактирования текстов с целью создания четкой деловой речи
Лучшие инструменты AI-редактирования 2026 года с высоким рейтингом для качественного делового письма уже доступны на XIX.AI! В этом тщательно отобранном списке представлены мощные решения, способные значительно повысить эффективность работы с текстами благодаря тестированию в реальных условиях и строгой оценке качества. Здесь также приведено сравнение бесплатных и платных версий, которое поможет вам выбрать оптимальный вариант. Ознакомьтесь уже сейчас и раскройте потенциал ИИ в своей работе!
10 инструментов
xix.ai
Создание анимации
Лучшие инструменты для улучшения движений с использованием ИИ для переназначения данных мокапа в роликах Shorts, рекламных материалах и трейлерах игр
2026 год: лучшие и наиболее высоко оценённые инструменты для обработки движения с ИИ, предназначенные для использования в проектах типа Mocap Retargeting в роликах Shorts, рекламе и трейлерах игр! XIX.AI собрал мощный набор инструментов, который регулярно обновляется: здесь представлены еженедельные рейтинги, сравнение бесплатных и платных версий, а также результаты реальных тестов. Всё это поможет вам найти оптимальное решение, способствующее повышению производительности и раскрытию вашего творческого потенциала. Ознакомьтесь с предложениями прямо сейчас, чтобы выбрать идеальный инструмент для безупречной обработки движения.
9 инструментов
xix.ai
Создание комиксов
Лучшие генераторы фонов для манги на основе ИИ для сериализованных историй
2026 г. Последние лучшие топовые генераторы фона для манги на основе ИИ для сериализованных историй! Этот тщательно подобранный список включает мощные инструменты, меняющие правила игры, которые помогают создателям быстро создавать впечатляющий визуальный контент, значительно повышая продуктивность. Каждый вариант прошел реальные тесты для обеспечения высочайшего качества. Ознакомьтесь со сравнением бесплатных и платных версий, а также рейтингами, чтобы найти идеальный вариант. Исследуйте возможности прямо сейчас на XIX.AI, чтобы раскрыть свое преимущество с помощью ИИ в создании манги.
9 инструментов
xix.ai
чат-бот
Лучшие чат-боты на базе ИИ: ведите естественные беседы с использованием долговременной памяти
Рейтинг лучших чат-ботов с ИИ 2026 года представляет самые популярные и мощные инструменты, известные своей способностью вести естественные беседы и сохранять долговременную память. Этот тщательно составленный список включает варианты, которые обязательно стоит попробовать — как бесплатные, так и платные — и основан на результатах реальных тестов и еженедельно обновляемом рейтинге. XIX.AI выделяется в этой элитной подборке как надежный выбор. Ознакомьтесь с ним прямо сейчас, чтобы найти своего идеального чат-бота на базе ИИ и повысить свою продуктивность уже сегодня.
11 инструментов
xix.ai
Создание анимации
Лучшие генераторы ИИ-анимации: быстро превращайте идеи в видеоролики
2026 год: лучшие и самые популярные генераторы анимации на базе ИИ! XIX.AI отбирает мощную коллекцию инструментов, способных изменить правила игры и обязательных к использованию для быстрого превращения творческих идей в высококачественные видеоролики. Каждый вариант прошёл строгие реальные тесты, включает подробное сравнение бесплатных и платных версий, а также еженедельно обновляемый рейтинг, чтобы помочь вам найти идеальное решение для повышения продуктивности в создании анимации. Исследуйте сейчас, чтобы получить преимущество благодаря ИИ!
11 инструментов
xix.ai

 Комментарии (0)
По мере развития технологий крупных языковых моделей (LLM) поисковые системы переживают третий сдвиг парадигмы, переходя от традиционного сопоставления текста по ключевым словам к эре 3.0, ориентированной на понимание сложных намерений и когнитивное принятие решений. Недавно техническая команда Meituan опубликовала подробный технический анализ, в котором подробно описаны три итерации Meituan Search 3.0 в контексте ранжирования услуг розничной торговли, а также изложены пути внедрения и основная ценность семантического представления LLM в сложных контекстах повседневной жизни.
I. Прорыв в сфере розничной торговли услугами: от традиционного лексического сопоставления к семантической реконструкции с помощью LLM
Розничная торговля услугами принципиально отличается от розничной торговли товарами по своей бизнес-модели. В отличие от высокостандартизированной розничной торговли товарами, розничная торговля услугами Meituan и сценарии местного образа жизни характеризуются разнообразными категориями, разнообразными поисковыми запросами (транзакционные, информационные и направленные на привлечение потенциальных клиентов) и крайне нестандартизированным предложением.
В повседневных поисковых запросах традиционные модели ранжирования в значительной степени полагаются на лексическое сопоставление. Однако при работе с огромным количеством категорий «длинного хвоста» и сложными намерениями пользователей способность традиционного проектирования признаков к обобщению явно недостаточна. Например, когда пользователь ищет «спа для домашних животных + купание», соответствующее название продавца или товара может звучать как «Пакет услуг по уходу и чистке домашних животных»; при поиске «весеннюю уборку» — как «Пакет услуг по генеральной уборке». В таких типичных случаях на первый взгляд пересечения между запросом и предложением практически нет, но их глубинная семантика тесно связана.
Чтобы преодолеть этот традиционный семантический разрыв, команда Meituan по ранжированию поисковых запросов в сфере розничных услуг в течение последнего года систематически изучала возможности применения LLM в моделях ранжирования. Генерируя высококачественные семантические векторные представления для поисковых запросов (Query), продавцов (POI) и предложений (Deal), они внедрили сигналы семантического сопоставления в модель ранжирования с использованием косинусного сходства, что позволило совершить скачок от точечной проверки признаков к систематической реконструкции, а затем — к межсценарийной миграции и повторному использованию.
II. Три этапа технической эволюции: от проверки осуществимости до полномасштабного построения системы
1. Этап I: внедрение семантических представлений LLM в ранжирование (проверка осуществимости)
На первом этапе основная цель команды была проста: проверить, могут ли представления LLM оказать существенную помощь модели ранжирования.
Технический дизайн: для полной настройки параметров была выбрана базовая модель с открытым исходным кодом и небольшим набором параметров, при этом в словарь были введены специальные токены в качестве анкерных элементов для агрегации. Маски внимания были тщательно разработаны для отделения запросов от информации о продавцах. Внедрение признаков: после того как модель сгенерировала вложения, рассчитывалось косинусное сходство и дискретно группировалось, а затем объединялось в качестве обучаемых вложений в признаки модели ранжирования. Результаты в режиме онлайн: офлайн-валидация показала значительное улучшение показателя NDCG по кликам. После развертывания наблюдался значительный рост общего количества платежных заказов по результатам поиска и розничных заказов на услуги, особенно в сценариях «длинного хвоста», где традиционное лексическое сопоставление было наиболее слабым, при этом количество некорректных результатов заметно сократилось. Это напрямую подтвердило огромный потенциал семантического представления LLM в сценарии ранжирования.2. Этап II: Систематическое усовершенствование представлений ранжирования продавцов
Устраняя проблемные моменты, выявленные на этапе I, такие как отсутствие семантического представления со стороны товаров, высокие затраты на полную настройку параметров и неполные цели оптимизации, на этапе II была проведена систематическая реконструкция всего процесса формирования представлений.
Пятерки и контрастивное обучение: был создан обучающий набор данных в виде пятерок, включающий запрос, положительные образцы товаров, положительные образцы продавцов и сложные отрицательные образцы. От традиционной задачи бинарной классификации полностью отказались, а вместо этого были в полной мере внедрены функции потерь InfoNCE и Triplet Loss, что идеально решило проблему «относительного порядка среди нескольких кандидатов», которая действительно важна для модели ранжирования.Легкое и эффективное извлечение: при переходе от тонкой настройки всех параметров к методам LoRA старый подход был заменен независимыми последовательностями и обучаемыми векторами, а снижение размерности было модернизировано до MRL-E (Matryoshka Representation Learning), что повысило эффективность обучения и инференса, одновременно поддерживая гибкие многомасштабные приложения. Результаты онлайн-тестирования: Показатели GAUC по кликам и эффективность конверсии в рейтинге продавцов значительно улучшились. Онлайн-данные продемонстрировали значительный рост эффективных кликов и коэффициента конверсии на странице результатов (QV_CTR), что полностью подтверждает: семантическое представление LLM не только открывает больше возможностей для показа, но и оптимизирует общее качество конверсии за счет точных рекомендаций.3. Этап III: внедрение представлений и кросс-особенностей в последующий этап ранжирования
После завершения систематической реконструкции ранжирования продавцов команда далее применила отработанное решение к последующему ранжированию (т. е. ранжированию конкретных товаров в рамках одного продавца), одновременно совершенствуя управление и дополнение кросс-статистических признаков по всему спектру.
Решение проблем с охватом: из-за фундаментальных различий в распределении запросов между ранжированием продавцов и последующим ранжированием при первоначальном переносе возникли проблемы с низким охватом запросов. Благодаря тонкой настройке и управлению данными на обоих концах команде удалось плавно расширить возможности семантического представления LLM на уровень товаров. Параллельный прогресс: благодаря сочетанию «переноса представлений LLM» с моделированием межмерных взаимосвязей, таких как «персонализация × товар» и «намерение запроса × товар», точность результатов поиска сделала очередной скачок.III. Подведение итогов и перспективы
Эволюция Meituan Search 3.0 показывает, что применение LLM в сфере локальных услуг повседневной жизни — это не мгновенный успех, а требует прохождения четкого пути от точечной валидации характеристик, систематической реконструкции представлений до обобщения и повторного использования в различных сценариях. Преобразовав мощные возможности LLM по семантическому пониманию в плотные непрерывные представления и дискретные биновые признаки, Meituan успешно преодолел барьеры между сложными намерениями и нестандартизированным предложением в сценариях розничной торговли услугами, предоставив пользователям более точный и интеллектуальный опыт поиска местных услуг и развлечений.








 ChatGPT пережил масштабный сбой, миллионы пользователей столкнулись с проблемами при входе в систему
Стабильность работы серверов по-прежнему остается одним из ключевых приоритетов в сфере искусственного интеллекта. Согласно отчетам, ChatGPT — ведущая в мире чат-платформа на базе ИИ — около 20 август
 Moonshot Ventures может провести IPO в Гонконге для финансирования масштабного развития больших моделей
Bloomberg сообщает, что ведущая китайская компания в сфере искусственного интеллекта Moonshot AI рассматривает возможность проведения IPO в Гонконге.Компания Moonshot AI из Пекина, создатель популярно
 Marvis представляет функцию создания индивидуальных моделей, интегрирующую GLM от Kimi и Zhipu
1 сентября Marvis, искусственный интеллект на уровне операционной системы от Tencent, официально запустил функцию «Пользовательская модель». Это обновление позволяет пользователям легко интегрировать

2026: лучшие и самые популярные помощники с ИИ, отобранные специально для сокращения времени переключения между задачами и поддержания вашей продуктивности в течение всего дня. Эти мощные инструменты проходят тщательные тесты в реальных условиях; представлены сравнения бесплатных и платных версий, а также еженедельно обновляемые рейтинги. Найдите свой идеальный инструмент, чтобы повысить эффективность написания текстов, раскрыть творческий потенциал и сохранять концентрацию без отвлекающих факторов. Посетите сайт XIX.AI прямо сейчас, чтобы раскрыть свой потенциал с помощью ИИ.
9 инструментов
xix.ai

Лучшие инструменты AI-редактирования 2026 года с высоким рейтингом для качественного делового письма уже доступны на XIX.AI! В этом тщательно отобранном списке представлены мощные решения, способные значительно повысить эффективность работы с текстами благодаря тестированию в реальных условиях и строгой оценке качества. Здесь также приведено сравнение бесплатных и платных версий, которое поможет вам выбрать оптимальный вариант. Ознакомьтесь уже сейчас и раскройте потенциал ИИ в своей работе!
10 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые инструменты для обработки движения с ИИ, предназначенные для использования в проектах типа Mocap Retargeting в роликах Shorts, рекламе и трейлерах игр! XIX.AI собрал мощный набор инструментов, который регулярно обновляется: здесь представлены еженедельные рейтинги, сравнение бесплатных и платных версий, а также результаты реальных тестов. Всё это поможет вам найти оптимальное решение, способствующее повышению производительности и раскрытию вашего творческого потенциала. Ознакомьтесь с предложениями прямо сейчас, чтобы выбрать идеальный инструмент для безупречной обработки движения.
9 инструментов
xix.ai

2026 г. Последние лучшие топовые генераторы фона для манги на основе ИИ для сериализованных историй! Этот тщательно подобранный список включает мощные инструменты, меняющие правила игры, которые помогают создателям быстро создавать впечатляющий визуальный контент, значительно повышая продуктивность. Каждый вариант прошел реальные тесты для обеспечения высочайшего качества. Ознакомьтесь со сравнением бесплатных и платных версий, а также рейтингами, чтобы найти идеальный вариант. Исследуйте возможности прямо сейчас на XIX.AI, чтобы раскрыть свое преимущество с помощью ИИ в создании манги.
9 инструментов
xix.ai

Рейтинг лучших чат-ботов с ИИ 2026 года представляет самые популярные и мощные инструменты, известные своей способностью вести естественные беседы и сохранять долговременную память. Этот тщательно составленный список включает варианты, которые обязательно стоит попробовать — как бесплатные, так и платные — и основан на результатах реальных тестов и еженедельно обновляемом рейтинге. XIX.AI выделяется в этой элитной подборке как надежный выбор. Ознакомьтесь с ним прямо сейчас, чтобы найти своего идеального чат-бота на базе ИИ и повысить свою продуктивность уже сегодня.
11 инструментов
xix.ai
2026 год: лучшие и самые популярные генераторы анимации на базе ИИ! XIX.AI отбирает мощную коллекцию инструментов, способных изменить правила игры и обязательных к использованию для быстрого превращения творческих идей в высококачественные видеоролики. Каждый вариант прошёл строгие реальные тесты, включает подробное сравнение бесплатных и платных версий, а также еженедельно обновляемый рейтинг, чтобы помочь вам найти идеальное решение для повышения продуктивности в создании анимации. Исследуйте сейчас, чтобы получить преимущество благодаря ИИ!
11 инструментов
xix.ai












