


 首頁
美團搜尋 3.0 運用大型模型,重構本地生活搜尋基礎架構
隨著大型語言模型(LLM)技術的進步,搜尋引擎正經歷第三次典範轉移,從傳統的基於關鍵字的文字比對,邁向以複雜意圖理解與認知決策為核心的 3.0 時代。 近日,美團技術團隊發布了一份深入的技術分析報告,詳述了美團搜尋 3.0 在服務零售排名場景中的三輪迭代,並闡述了在複雜的本地生活情境中,大型語言模型語義表徵的實施路徑與核心價值。
一、突破服務零售:從傳統詞彙匹配到 LLM 語義重構
服務零售在商業模式上與產品零售存在根本差異。與高度標準化的產品零售不同,美團的服務零售及本地生活場景具有品類多元、搜尋需求多樣(交易型、資訊型及潛在客戶開發型),以及供應端高度非標準化的特點。
在日常搜尋中,傳統排名模型高度依賴詞彙匹配。然而,面對海量的長尾類別與複雜的用戶意圖時,傳統特徵工程的泛化能力顯然不足。 舉例來說,當用戶搜尋「寵物水療+洗澡」時,對應的商家或商品名稱可能是「寵物清潔與護理套餐」;而搜尋「春節大掃除」時,則可能是「深度清潔服務套餐」。 在這些典型案例中,查詢與供應表面上幾乎沒有重疊,但其底層語義卻高度相關。
為了彌合這種傳統的語義鴻溝,美團服務零售搜尋排名團隊在過去一年中,系統性地探索了在大語言模型(LLMs)在排名模型中的應用。 透過為搜尋查詢(Query)、商家(POI)及優惠(Deal)生成高品質的語義向量表示,他們利用餘弦相似度將語義匹配訊號注入排名模型,實現了從單點特徵驗證到系統性重建,進而邁向跨場景遷移與再利用的飛躍。
II. 技術演進的三個階段:從可行性驗證到全面系統建構
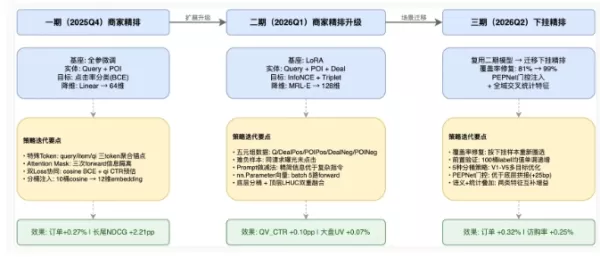
1. 第一階段:將 LLM 語義表徵導入排名(驗證可行性)
在第一階段,團隊的核心目標很簡單:驗證 LLM 表徵能否為排名模型提供實質性的協助。
技術設計:選用一個小參數的開源基礎模型進行全參數微調,並在詞彙表中引入特殊標記作為聚合錨點。 透過精心設計的注意力遮罩,將查詢與商家資訊隔離。特徵注入:模型產生嵌入向量後,計算餘弦相似度並進行離散分桶,隨後將其作為可學習的嵌入向量串接至排名模型的特徵中。線上結果:離線驗證顯示點擊率 NDCG 有顯著提升。 部署後,整體搜尋支付訂單與服務零售訂單均顯著增加,特別是在傳統詞彙匹配效果最弱的長尾情境中,不良案例亦顯著減少。這直接證明了大型語言模型(LLM)語義表徵在排序情境中的巨大潛力。2. 第二階段:商家排名表徵的系統性升級
為解決第一階段暴露的痛點,例如商品端缺乏語義表徵、全參數微調成本高昂,以及優化目標不完整等問題,第二階段著手對整個表徵生成流程進行系統性重構。
五元組與對比學習:建構了包含查詢、商品正樣本、商家正樣本及硬負樣本的五元組訓練資料集。 我們徹底摒棄了傳統的二元分類目標,並全面引入 InfoNCE 損失與三元組損失,完美解決了排名模型真正關心的「多個候選項之間的相對順序」問題。輕量且高效的提取:從全參數微調轉向 LoRA 方法,獨立序列與可學習向量取代了舊有方法,維度縮減技術升級為 MRL-E(Matryoshka 表徵學習),在提升訓練與推論效率的同時,支援靈活的多尺度應用。線上結果: 商家排名的點擊 GAUC 及轉換效率均顯著提升。線上數據顯示,有效點擊量與結果頁面轉換率(QV_CTR)均大幅上升,充分證明大型語言模型(LLM)的語義表徵不僅能帶來更多曝光機會,更能透過精準推薦來優化整體轉換品質。3. 第三階段:將表徵與跨特徵引入下游排名
在完成商家排名的系統性重構後,團隊進一步將這套成熟的解決方案應用於下游排名(即對商家旗下特定商品進行排名),同時全面推進跨統計特徵的治理與補充工作。
解決覆蓋率挑戰:由於商家排名與下游排名在查詢分佈上存在根本差異,初期遷移面臨查詢覆蓋率偏低的挑戰。 透過兩端細粒度的對齊與資料治理,團隊成功將 LLM 的語義表徵能力無縫延伸至產品層級。並行進展:結合「LLM 表徵轉移」與「個人化 × 產品」、「查詢意圖 × 產品」等跨維度建模,搜尋結果的準確度再獲飛躍性提升。III. 總結與展望
美團搜尋 3.0 的演進歷程顯示,在大本地生活領域應用大型語言模型並非一蹴可幾,而是需要從單點特徵驗證、系統化表徵重構,到跨情境泛化與再利用,踏出一條紮實的發展路徑。 透過將大語言模型強大的語義理解能力轉化為高密度連續表徵與離散分箱特徵,美團成功打破了服務零售場景中複雜意圖與非標準化供應之間的壁壘,為用戶提供更精準、更智慧的本地生活搜尋體驗。
相關文章
 ChatGPT 發生大規模服務中斷,數百萬用戶遭遇登入問題
伺服器穩定性仍是人工智慧領域的關鍵焦點。據報導,全球領先的 AI 聊天平台 ChatGPT 於 8 月 20 日左右遭遇了一次突發且大範圍的全球性服務中斷。此次中斷影響了美國和歐洲數百萬用戶,導致無法登入帳戶及進行新註冊,同時聊天介面凍結,且無法存取對話紀錄。用戶反饋凸顯了此次故障對日常互動造成的全面影響。 許多用戶發現側邊欄卡在載入迴圈中,發送訊息時更會遇到「同時請求過多」的錯誤。官方網站的核心
Moonshot Ventures 可能在香港進行首次公開募股,以籌措資金推動大型模型發展
彭博社報導,中國領先的人工智慧公司「Moonshot AI」正考慮在香港進行首次公開募股(IPO)。總部位於北京的 Moonshot AI 是熱門聊天機器人「Kimi」的開發者,旨在藉助市場對人工智慧的濃厚興趣來提升其市場地位。該公司已就潛在上市事宜與中國國際金融(CICC)及高盛(Goldman Sachs)進行初步磋商。儘管上市籌備工作仍在進行中,但知情人士指出,目前尚未確定最終時程,且該交易
Marvis 推出自訂模型功能,整合 Kimi 與 Zhipu GLM
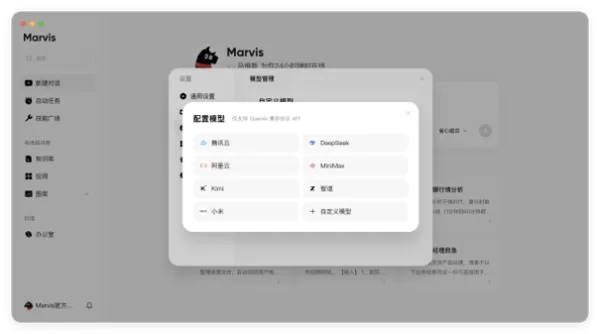
9 月 1 日,騰訊的作業系統級 AI 助理 Marvis 正式推出「自訂模型」功能。此更新讓使用者能夠將符合業界標準介面協定的第三方模型無縫整合至 Marvis 中。 支援的服務供應商包括騰雲、阿里雲、DeepSeek、Minimax、Kimi、智普及小米等主要平台。此外,此功能亦支援本地部署的開源模型,並能實現跨裝置同步,以提供一致的使用體驗。釋放模型靈活性:自由選擇過去一年間,大型語言模型領
相關專題推薦
音樂創作
 AI 人聲生成工具:建立演示人聲與和聲層
2026 年最新、最佳、最受好評的 AI 人聲生成工具,用於建立演示人聲和和聲層,現已在 XIX.AI 上線。本精選合集收錄了多款強大且具顛覆性的解決方案,均已透過嚴格的真實世界測試。我們每週更新免費與付費版本的對比,並提供詳細排名,助您找到提升創造力與生產力的完美工具。立即探索,釋放您的 AI 優勢。
 12 個工具
 xix.ai
生產率
最佳 AI 專注助理:減少任務切換,保持專注
2026 年最新精選、評價最高的 AI 專注輔助工具,專為大幅減少切換工作情境的次數,並讓您全天保持高效而精心挑選。這些強大的工具均經過嚴謹的實際環境測試,提供免費版與付費版的比較,並每週更新排行榜。立即探索最適合您的工具,提升寫作效率、激發創意靈感,並在無干擾的狀態下保持專注。 立即前往 XIX.AI 探索,釋放您的 AI 優勢。
9 個工具
xix.ai
寫作
最佳 AI 編輯工具,助您撰寫清晰明瞭的商務文書
2026 年最新、最受好評的 AI 編輯工具,助您撰寫清晰明瞭的商務文案,盡在 XIX.AI!這份精心精選的清單收錄了強大且具顛覆性的解決方案,這些工具經過實際測試與嚴格評比,能助您大幅提升寫作效率。您還可參考免費版與付費版的比較,以挑選最適合您的工具。 立即探索,釋放您的 AI 優勢!
10 個工具
xix.ai
動畫創作
適用於短影片、廣告及遊戲預告片角色捕捉重定向的最佳 AI 動作清理工具
2026年最新、最優秀、評分最高的AI動作清理工具,專為短影片、廣告及遊戲預告片中的動作捕捉重定向任務設計!XIX.AI精心整理了一組極具顛覆性的工具合集,其中包含每週更新的排名榜單、免費版與付費版的對比資訊以及實際應用測試結果,助您找到能夠提升工作效率、激發創意潛能的理想解決方案。立即探索,為您尋找最適合實現完美動作編輯的工具。
9 個工具
xix.ai
漫畫創作
最佳用於連載故事的 AI 漫畫背景生成器
2026 年最新最佳頂級評分 AI 漫畫背景生成器,專為連載故事打造!此精選列表包含功能強大的變革性工具,幫助創作者快速製作令人驚歎的視覺內容,顯著提升生產力。每個選項均經過實際測試,以確保卓越品質。檢視免費與付費對比及排名,找到最適合您的方案。立即訪問 XIX.AI,解鎖您在漫畫創作中的 AI 優勢。
9 個工具
xix.ai
聊天機器人
最佳 AI 聊天夥伴:具備長期記憶,能進行自然對話
《2026 年最新最佳 AI 聊天伴侶排行榜》精選了廣受好評且功能強大的工具,這些工具以能夠進行自然對話並具備長期記憶能力而聞名。這份精心策劃的清單涵蓋了免費與付費層級中必試的選項,並經由實際測試驗證,且排行榜每週更新。XIX.AI 在這份精英名單中脫穎而出,成為值得信賴的首選。 立即探索,發掘最適合您的 AI 聊天夥伴,並從今天起釋放您的生產力優勢。
11 個工具
xix.ai

 評論 (0)
0/500
隨著大型語言模型(LLM)技術的進步,搜尋引擎正經歷第三次典範轉移,從傳統的基於關鍵字的文字比對,邁向以複雜意圖理解與認知決策為核心的 3.0 時代。 近日,美團技術團隊發布了一份深入的技術分析報告,詳述了美團搜尋 3.0 在服務零售排名場景中的三輪迭代,並闡述了在複雜的本地生活情境中,大型語言模型語義表徵的實施路徑與核心價值。
一、突破服務零售:從傳統詞彙匹配到 LLM 語義重構
服務零售在商業模式上與產品零售存在根本差異。與高度標準化的產品零售不同,美團的服務零售及本地生活場景具有品類多元、搜尋需求多樣(交易型、資訊型及潛在客戶開發型),以及供應端高度非標準化的特點。
在日常搜尋中,傳統排名模型高度依賴詞彙匹配。然而,面對海量的長尾類別與複雜的用戶意圖時,傳統特徵工程的泛化能力顯然不足。 舉例來說,當用戶搜尋「寵物水療+洗澡」時,對應的商家或商品名稱可能是「寵物清潔與護理套餐」;而搜尋「春節大掃除」時,則可能是「深度清潔服務套餐」。 在這些典型案例中,查詢與供應表面上幾乎沒有重疊,但其底層語義卻高度相關。
為了彌合這種傳統的語義鴻溝,美團服務零售搜尋排名團隊在過去一年中,系統性地探索了在大語言模型(LLMs)在排名模型中的應用。 透過為搜尋查詢(Query)、商家(POI)及優惠(Deal)生成高品質的語義向量表示,他們利用餘弦相似度將語義匹配訊號注入排名模型,實現了從單點特徵驗證到系統性重建,進而邁向跨場景遷移與再利用的飛躍。
II. 技術演進的三個階段:從可行性驗證到全面系統建構
1. 第一階段:將 LLM 語義表徵導入排名(驗證可行性)
在第一階段,團隊的核心目標很簡單:驗證 LLM 表徵能否為排名模型提供實質性的協助。
技術設計:選用一個小參數的開源基礎模型進行全參數微調,並在詞彙表中引入特殊標記作為聚合錨點。 透過精心設計的注意力遮罩,將查詢與商家資訊隔離。特徵注入:模型產生嵌入向量後,計算餘弦相似度並進行離散分桶,隨後將其作為可學習的嵌入向量串接至排名模型的特徵中。線上結果:離線驗證顯示點擊率 NDCG 有顯著提升。 部署後,整體搜尋支付訂單與服務零售訂單均顯著增加,特別是在傳統詞彙匹配效果最弱的長尾情境中,不良案例亦顯著減少。這直接證明了大型語言模型(LLM)語義表徵在排序情境中的巨大潛力。2. 第二階段:商家排名表徵的系統性升級
為解決第一階段暴露的痛點,例如商品端缺乏語義表徵、全參數微調成本高昂,以及優化目標不完整等問題,第二階段著手對整個表徵生成流程進行系統性重構。
五元組與對比學習:建構了包含查詢、商品正樣本、商家正樣本及硬負樣本的五元組訓練資料集。 我們徹底摒棄了傳統的二元分類目標,並全面引入 InfoNCE 損失與三元組損失,完美解決了排名模型真正關心的「多個候選項之間的相對順序」問題。輕量且高效的提取:從全參數微調轉向 LoRA 方法,獨立序列與可學習向量取代了舊有方法,維度縮減技術升級為 MRL-E(Matryoshka 表徵學習),在提升訓練與推論效率的同時,支援靈活的多尺度應用。線上結果: 商家排名的點擊 GAUC 及轉換效率均顯著提升。線上數據顯示,有效點擊量與結果頁面轉換率(QV_CTR)均大幅上升,充分證明大型語言模型(LLM)的語義表徵不僅能帶來更多曝光機會,更能透過精準推薦來優化整體轉換品質。3. 第三階段:將表徵與跨特徵引入下游排名
在完成商家排名的系統性重構後,團隊進一步將這套成熟的解決方案應用於下游排名(即對商家旗下特定商品進行排名),同時全面推進跨統計特徵的治理與補充工作。
解決覆蓋率挑戰:由於商家排名與下游排名在查詢分佈上存在根本差異,初期遷移面臨查詢覆蓋率偏低的挑戰。 透過兩端細粒度的對齊與資料治理,團隊成功將 LLM 的語義表徵能力無縫延伸至產品層級。並行進展:結合「LLM 表徵轉移」與「個人化 × 產品」、「查詢意圖 × 產品」等跨維度建模,搜尋結果的準確度再獲飛躍性提升。III. 總結與展望
美團搜尋 3.0 的演進歷程顯示,在大本地生活領域應用大型語言模型並非一蹴可幾,而是需要從單點特徵驗證、系統化表徵重構,到跨情境泛化與再利用,踏出一條紮實的發展路徑。 透過將大語言模型強大的語義理解能力轉化為高密度連續表徵與離散分箱特徵,美團成功打破了服務零售場景中複雜意圖與非標準化供應之間的壁壘,為用戶提供更精準、更智慧的本地生活搜尋體驗。








 ChatGPT 發生大規模服務中斷,數百萬用戶遭遇登入問題
伺服器穩定性仍是人工智慧領域的關鍵焦點。據報導,全球領先的 AI 聊天平台 ChatGPT 於 8 月 20 日左右遭遇了一次突發且大範圍的全球性服務中斷。此次中斷影響了美國和歐洲數百萬用戶,導致無法登入帳戶及進行新註冊,同時聊天介面凍結,且無法存取對話紀錄。用戶反饋凸顯了此次故障對日常互動造成的全面影響。 許多用戶發現側邊欄卡在載入迴圈中,發送訊息時更會遇到「同時請求過多」的錯誤。官方網站的核心
 Moonshot Ventures 可能在香港進行首次公開募股,以籌措資金推動大型模型發展
彭博社報導,中國領先的人工智慧公司「Moonshot AI」正考慮在香港進行首次公開募股(IPO)。總部位於北京的 Moonshot AI 是熱門聊天機器人「Kimi」的開發者,旨在藉助市場對人工智慧的濃厚興趣來提升其市場地位。該公司已就潛在上市事宜與中國國際金融(CICC)及高盛(Goldman Sachs)進行初步磋商。儘管上市籌備工作仍在進行中,但知情人士指出,目前尚未確定最終時程,且該交易
 Marvis 推出自訂模型功能,整合 Kimi 與 Zhipu GLM
9 月 1 日,騰訊的作業系統級 AI 助理 Marvis 正式推出「自訂模型」功能。此更新讓使用者能夠將符合業界標準介面協定的第三方模型無縫整合至 Marvis 中。 支援的服務供應商包括騰雲、阿里雲、DeepSeek、Minimax、Kimi、智普及小米等主要平台。此外,此功能亦支援本地部署的開源模型,並能實現跨裝置同步,以提供一致的使用體驗。釋放模型靈活性:自由選擇過去一年間,大型語言模型領
2026 年最新、最佳、最受好評的 AI 人聲生成工具,用於建立演示人聲和和聲層,現已在 XIX.AI 上線。本精選合集收錄了多款強大且具顛覆性的解決方案,均已透過嚴格的真實世界測試。我們每週更新免費與付費版本的對比,並提供詳細排名,助您找到提升創造力與生產力的完美工具。立即探索,釋放您的 AI 優勢。
12 個工具
xix.ai

2026 年最新精選、評價最高的 AI 專注輔助工具,專為大幅減少切換工作情境的次數,並讓您全天保持高效而精心挑選。這些強大的工具均經過嚴謹的實際環境測試,提供免費版與付費版的比較,並每週更新排行榜。立即探索最適合您的工具,提升寫作效率、激發創意靈感,並在無干擾的狀態下保持專注。 立即前往 XIX.AI 探索,釋放您的 AI 優勢。
9 個工具
xix.ai

2026 年最新、最受好評的 AI 編輯工具,助您撰寫清晰明瞭的商務文案,盡在 XIX.AI!這份精心精選的清單收錄了強大且具顛覆性的解決方案,這些工具經過實際測試與嚴格評比,能助您大幅提升寫作效率。您還可參考免費版與付費版的比較,以挑選最適合您的工具。 立即探索,釋放您的 AI 優勢!
10 個工具
xix.ai

2026年最新、最優秀、評分最高的AI動作清理工具,專為短影片、廣告及遊戲預告片中的動作捕捉重定向任務設計!XIX.AI精心整理了一組極具顛覆性的工具合集,其中包含每週更新的排名榜單、免費版與付費版的對比資訊以及實際應用測試結果,助您找到能夠提升工作效率、激發創意潛能的理想解決方案。立即探索,為您尋找最適合實現完美動作編輯的工具。
9 個工具
xix.ai

2026 年最新最佳頂級評分 AI 漫畫背景生成器,專為連載故事打造!此精選列表包含功能強大的變革性工具,幫助創作者快速製作令人驚歎的視覺內容,顯著提升生產力。每個選項均經過實際測試,以確保卓越品質。檢視免費與付費對比及排名,找到最適合您的方案。立即訪問 XIX.AI,解鎖您在漫畫創作中的 AI 優勢。
9 個工具
xix.ai

《2026 年最新最佳 AI 聊天伴侶排行榜》精選了廣受好評且功能強大的工具,這些工具以能夠進行自然對話並具備長期記憶能力而聞名。這份精心策劃的清單涵蓋了免費與付費層級中必試的選項,並經由實際測試驗證,且排行榜每週更新。XIX.AI 在這份精英名單中脫穎而出,成為值得信賴的首選。 立即探索,發掘最適合您的 AI 聊天夥伴,並從今天起釋放您的生產力優勢。
11 個工具
xix.ai












