


 Lar
O Meitun Search 3.0 utiliza modelos de grande porte para reconstruir a infraestrutura de pesquisa de vida local
À medida que a tecnologia dos grandes modelos de linguagem (LLM) avança, os mecanismos de busca estão passando por uma terceira mudança de paradigma, transitando da tradicional correspondência de texto baseada em palavras-chave para uma era 3.0 focada na compreensão de intenções complexas e na tomada de decisões cognitiva. Recentemente, a equipe técnica da Meituan divulgou uma análise técnica aprofundada, detalhando três iterações do Meituan Search 3.0 em cenários de classificação de serviços de varejo e delineando o caminho de implementação e o valor central da representação semântica do LLM em contextos complexos da vida local.
I. Rompendo barreiras no varejo de serviços: da correspondência lexical tradicional à reconstrução semântica por LLM
O varejo de serviços difere fundamentalmente do varejo de produtos em seu modelo de negócios. Ao contrário do varejo de produtos, altamente padronizado, o varejo de serviços da Meituan e os cenários locais de estilo de vida apresentam categorias diversas, demandas de busca variadas (transacionais, informativas e de geração de leads) e uma oferta altamente não padronizada.
Nas buscas diárias, os modelos tradicionais de classificação dependem fortemente da correspondência lexical. No entanto, diante de uma enorme variedade de categorias de cauda longa e intenções complexas dos usuários, a capacidade de generalização da engenharia de características tradicional é claramente insuficiente. Por exemplo, quando um usuário pesquisa por “spa para animais de estimação + banho”, o nome do comerciante ou do produto correspondente pode ser “Pacote de Limpeza e Cuidados para Animais de Estimação”; ao pesquisar por “limpeza do Festival da Primavera”, pode ser “Pacote de Serviço de Limpeza Profunda”. Nesses casos típicos, há pouca sobreposição entre a consulta e a oferta à primeira vista, mas suas semânticas subjacentes estão altamente relacionadas.
Para preencher essa lacuna semântica tradicional, a equipe de classificação de pesquisa de serviços de varejo da Meituan explorou sistematicamente a aplicação de LLMs em modelos de classificação ao longo do último ano. Ao gerar representações vetoriais semânticas de alta qualidade para consultas de busca (Query), comerciantes (POI) e ofertas (Deal), eles injetaram sinais de correspondência semântica no modelo de classificação usando similaridade cosseno, alcançando um salto da validação de características pontuais para a reconstrução sistemática e, em seguida, para a migração e reutilização entre cenários.
II. Três etapas da evolução técnica: da verificação de viabilidade à construção do sistema em escala real
1. Fase I: Introdução da Representação Semântica do LLM no Ranking (Verificação da Viabilidade)
Na primeira fase, o objetivo principal da equipe era simples: verificar se as representações de LLM poderiam oferecer uma contribuição substancial ao modelo de classificação.
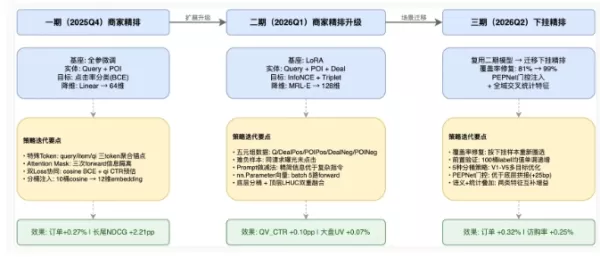
Projeto técnico: Um modelo base de código aberto com poucos parâmetros foi selecionado para o ajuste fino de todos os parâmetros, com tokens especiais introduzidos no vocabulário como âncoras de agregação. Máscaras de atenção foram cuidadosamente projetadas para isolar as consultas das informações dos comerciantes. Injeção de características: Após o modelo gerar embeddings, a similaridade cosseno foi calculada e agrupada discretamente, sendo então concatenada como embeddings aprendíveis nas características do modelo de classificação. Resultados online: A validação offline mostrou uma melhoria significativa no NDCG de cliques. Após a implantação, os pedidos de pagamento por pesquisa e os pedidos de varejo de serviços em geral registraram um aumento significativo, especialmente em cenários de cauda longa, onde a correspondência lexical tradicional era mais fraca, com uma redução notável nos casos indesejáveis. Isso comprovou diretamente o grande potencial da representação semântica do LLM no cenário de classificação.2. Fase II: Atualização sistemática das representações de classificação de comerciantes
Abordando os pontos críticos expostos na Fase I, como a falta de representação semântica no lado do produto, os altos custos do ajuste fino de todos os parâmetros e os objetivos de otimização incompletos, a Fase II envolveu uma reconstrução sistemática de todo o processo de produção de representações.
Aprendizado em pentupletos e contrastivo: foi construído um conjunto de dados de treinamento em pentupletos, incluindo consulta, amostras positivas de produtos, amostras positivas de comerciantes e amostras negativas difíceis. O objetivo tradicional de classificação binária foi completamente abandonado, e as perdas InfoNCE e Triplet foram totalmente introduzidas, resolvendo perfeitamente a questão da “ordem relativa entre múltiplos candidatos” que realmente interessa ao modelo de classificação.Extração Leve e Eficiente: Na transição do ajuste fino de parâmetros completos para os métodos LoRA, sequências independentes e vetores aprendíveis substituíram a abordagem antiga, e a redução de dimensionalidade foi atualizada para MRL-E (Matryoshka Representation Learning), melhorando a eficiência do treinamento e da inferência, ao mesmo tempo em que oferece suporte a aplicações multiescala flexíveis. Resultados Online: O GAUC de cliques e a eficiência de conversão do ranking de comerciantes melhoraram significativamente. Os dados online mostraram um aumento significativo nos cliques efetivos e na taxa de conversão da página de resultados (QV_CTR), demonstrando plenamente que a representação semântica do LLM não apenas traz mais oportunidades de exposição, mas também otimiza a qualidade geral da conversão por meio de recomendações precisas.3. Fase III: Introdução de representações e características cruzadas na classificação a jusante
Após concluir a reconstrução sistemática do ranking de comerciantes, a equipe aplicou ainda mais a solução madura ao ranking a jusante (ou seja, o ranking de produtos específicos de um comerciante), ao mesmo tempo em que avançava na governança e no aprimoramento das características estatísticas cruzadas em toda a plataforma.
Superando os desafios de cobertura: Devido às diferenças fundamentais na distribuição de consultas entre o ranking de lojistas e o ranking de produtos, a migração inicial enfrentou desafios relacionados à baixa cobertura de consultas. Por meio de um alinhamento detalhado e da governança de dados em ambas as extremidades, a equipe conseguiu estender com sucesso a capacidade de representação semântica do LLM de maneira integrada até o nível do produto. Progresso paralelo: combinando a “transferência de representação do LLM” com a modelagem de dimensões cruzadas, como “personalização × produto” e “intenção da consulta × produto”, os resultados de pesquisa alcançaram outro salto em precisão.III. Resumo e Perspectivas
A evolução do Meituan Search 3.0 mostra que a aplicação de LLMs no campo do estilo de vida local não é um sucesso da noite para o dia, mas requer um caminho sólido que vai desde a validação de características pontuais, passando pela reconstrução sistemática da representação, até a generalização e reutilização entre cenários. Ao transformar a poderosa capacidade de compreensão semântica dos LLMs em representações contínuas densas e características de agrupamento discreto, a Meituan conseguiu quebrar as barreiras entre intenções complexas e oferta não padronizada em cenários de varejo de serviços, proporcionando aos usuários uma experiência de busca de estilo de vida local mais precisa e inteligente.
Artigo relacionado
 O ChatGPT sofreu uma grande interrupção no serviço; milhões de usuários enfrentaram problemas para fazer login
A estabilidade dos servidores continua sendo um ponto crítico no setor de inteligência artificial. Relatos indicam que o ChatGPT, a principal plataforma de chat de IA do mundo, sofreu uma interrupção
A Moonshot Ventures pode lançar uma oferta pública inicial (IPO) em Hong Kong para financiar uma grande iniciativa voltada para modelos
A Bloomberg informa que a Moonshot AI, uma das principais empresas chinesas de IA, está avaliando a possibilidade de realizar uma oferta pública inicial (IPO) em Hong Kong.A Moonshot AI, com sede em P
A Marvis lança a função “Modelo Personalizado”, integrando o Kimi e o Zhipu GLM
Em 1º de setembro, o Marvis, assistente de IA da Tencent que opera no nível do sistema operacional, lançou oficialmente seu recurso “Modelo Personalizado”. Essa atualização permite que os usuários int
Recomendações de tópicos especiais relacionados
Composição musical
 Ferramentas de Geração de Voz por IA: Crie Vocais de Demonstração e Camadas de Harmonia
As melhores ferramentas de geração de voz por IA mais recentes e com as melhores avaliações de 2026 para criar vocais de demonstração e camadas de harmonia estão aqui no XIX.AI. Esta coleção selecionada apresenta soluções poderosas e revolucionárias que passaram por rigorosos testes no mundo real. Fornecemos uma comparação semanal atualizada entre versões gratuitas e pagas, juntamente com classificações detalhadas, para ajudá-lo a encontrar a ferramenta perfeita para impulsionar sua criatividade e produtividade. Explore agora para desbloquear sua vantagem com IA.
 12 ferramentas
 xix.ai
Produtividade
Os melhores assistentes de foco com IA: reduza a alternância de tarefas e mantenha o foco
Os melhores assistentes de IA com foco em produtividade de 2026, cuidadosamente selecionados para reduzir a troca de contexto e manter sua produtividade durante todo o dia. Essas ferramentas poderosas passam por testes rigorosos em condições reais, com uma comparação entre versões gratuitas e pagas, além de rankings atualizados semanalmente. Descubra a ferramenta perfeita para aumentar sua eficiência na escrita, estimular ideias criativas e manter o foco sem distrações. Explore agora no XIX.AI para aproveitar ao máximo sua vantagem com IA.
9 ferramentas
xix.ai
escrita
Melhores ferramentas de edição por IA para textos corporativos claros e precisos
Os melhores e mais atualizados ferramentas de edição por IA com alta avaliação, ideais para textos profissionais claros, estão disponíveis aqui no XIX.AI! Esta lista selecionada apresenta soluções poderosas e revolucionárias que ajudam a aumentar significativamente a eficiência na escrita, graças a testes em condições reais e classificações rigorosas. Você encontrará uma comparação entre as opções gratuitas e as pagas para auxiliá-lo a escolher a melhor alternativa. Explore agora e aproveite todas as vantagens oferecidas pela IA!
10 ferramentas
xix.ai
Criação de Animação
As melhores ferramentas de correção de movimento com IA para redirecionamento de captura de movimento em vídeos curtos, anúncios e trailers de jogos
As melhores e mais bem avaliadas ferramentas de limpeza de movimento com IA de 2026 para redirecionamento de captura de movimento (mocap) em vídeos curtos, anúncios e trailers de jogos! A XIX.AI selecionou uma coleção poderosa e revolucionária, com rankings atualizados semanalmente, comparação entre versões gratuitas e pagas e testes práticos para ajudar você a encontrar a solução imperdível que aumenta a produtividade e libera seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para edições de movimento impecáveis.
9 ferramentas
xix.ai
Criação de quadrinhos
Melhores Geradores de Fundo de Mangá com IA para Histórias em Série
2026 Últimas Melhores Geradores de Fundo de Mangá com IA Mais Bem Avaliados para Histórias em Série! Esta lista selecionada apresenta ferramentas poderosas que mudam o jogo, ajudando os criadores a produzir conteúdo visual impressionante rapidamente, aumentando significativamente a produtividade. Cada opção passou por testes no mundo real para garantir a mais alta qualidade. Confira a comparação entre gratuito e pago e as classificações para encontrar a opção perfeita para você. Explore agora na XIX.AI para desbloquear sua vantagem com IA na criação de mangás.
9 ferramentas
xix.ai
chatbot
Os melhores companheiros de bate-papo com IA: converse de forma natural com memória de longo prazo
O “Ranking dos Melhores Companheiros de Conversação com IA de 2026” apresenta ferramentas poderosas e bem avaliadas, conhecidas por sua capacidade de manter conversas naturais e reter memória de longo prazo. Essa lista cuidadosamente selecionada inclui opções imperdíveis, tanto gratuitas quanto pagas, respaldadas por testes reais e rankings atualizados semanalmente. O XIX.AI se destaca como uma opção confiável nessa coleção de elite. Explore agora para descobrir seu companheiro de bate-papo com IA perfeito e potencialize sua produtividade ainda hoje.
11 ferramentas
xix.ai

 Comentários (0)
À medida que a tecnologia dos grandes modelos de linguagem (LLM) avança, os mecanismos de busca estão passando por uma terceira mudança de paradigma, transitando da tradicional correspondência de texto baseada em palavras-chave para uma era 3.0 focada na compreensão de intenções complexas e na tomada de decisões cognitiva. Recentemente, a equipe técnica da Meituan divulgou uma análise técnica aprofundada, detalhando três iterações do Meituan Search 3.0 em cenários de classificação de serviços de varejo e delineando o caminho de implementação e o valor central da representação semântica do LLM em contextos complexos da vida local.
I. Rompendo barreiras no varejo de serviços: da correspondência lexical tradicional à reconstrução semântica por LLM
O varejo de serviços difere fundamentalmente do varejo de produtos em seu modelo de negócios. Ao contrário do varejo de produtos, altamente padronizado, o varejo de serviços da Meituan e os cenários locais de estilo de vida apresentam categorias diversas, demandas de busca variadas (transacionais, informativas e de geração de leads) e uma oferta altamente não padronizada.
Nas buscas diárias, os modelos tradicionais de classificação dependem fortemente da correspondência lexical. No entanto, diante de uma enorme variedade de categorias de cauda longa e intenções complexas dos usuários, a capacidade de generalização da engenharia de características tradicional é claramente insuficiente. Por exemplo, quando um usuário pesquisa por “spa para animais de estimação + banho”, o nome do comerciante ou do produto correspondente pode ser “Pacote de Limpeza e Cuidados para Animais de Estimação”; ao pesquisar por “limpeza do Festival da Primavera”, pode ser “Pacote de Serviço de Limpeza Profunda”. Nesses casos típicos, há pouca sobreposição entre a consulta e a oferta à primeira vista, mas suas semânticas subjacentes estão altamente relacionadas.
Para preencher essa lacuna semântica tradicional, a equipe de classificação de pesquisa de serviços de varejo da Meituan explorou sistematicamente a aplicação de LLMs em modelos de classificação ao longo do último ano. Ao gerar representações vetoriais semânticas de alta qualidade para consultas de busca (Query), comerciantes (POI) e ofertas (Deal), eles injetaram sinais de correspondência semântica no modelo de classificação usando similaridade cosseno, alcançando um salto da validação de características pontuais para a reconstrução sistemática e, em seguida, para a migração e reutilização entre cenários.
II. Três etapas da evolução técnica: da verificação de viabilidade à construção do sistema em escala real
1. Fase I: Introdução da Representação Semântica do LLM no Ranking (Verificação da Viabilidade)
Na primeira fase, o objetivo principal da equipe era simples: verificar se as representações de LLM poderiam oferecer uma contribuição substancial ao modelo de classificação.
Projeto técnico: Um modelo base de código aberto com poucos parâmetros foi selecionado para o ajuste fino de todos os parâmetros, com tokens especiais introduzidos no vocabulário como âncoras de agregação. Máscaras de atenção foram cuidadosamente projetadas para isolar as consultas das informações dos comerciantes. Injeção de características: Após o modelo gerar embeddings, a similaridade cosseno foi calculada e agrupada discretamente, sendo então concatenada como embeddings aprendíveis nas características do modelo de classificação. Resultados online: A validação offline mostrou uma melhoria significativa no NDCG de cliques. Após a implantação, os pedidos de pagamento por pesquisa e os pedidos de varejo de serviços em geral registraram um aumento significativo, especialmente em cenários de cauda longa, onde a correspondência lexical tradicional era mais fraca, com uma redução notável nos casos indesejáveis. Isso comprovou diretamente o grande potencial da representação semântica do LLM no cenário de classificação.2. Fase II: Atualização sistemática das representações de classificação de comerciantes
Abordando os pontos críticos expostos na Fase I, como a falta de representação semântica no lado do produto, os altos custos do ajuste fino de todos os parâmetros e os objetivos de otimização incompletos, a Fase II envolveu uma reconstrução sistemática de todo o processo de produção de representações.
Aprendizado em pentupletos e contrastivo: foi construído um conjunto de dados de treinamento em pentupletos, incluindo consulta, amostras positivas de produtos, amostras positivas de comerciantes e amostras negativas difíceis. O objetivo tradicional de classificação binária foi completamente abandonado, e as perdas InfoNCE e Triplet foram totalmente introduzidas, resolvendo perfeitamente a questão da “ordem relativa entre múltiplos candidatos” que realmente interessa ao modelo de classificação.Extração Leve e Eficiente: Na transição do ajuste fino de parâmetros completos para os métodos LoRA, sequências independentes e vetores aprendíveis substituíram a abordagem antiga, e a redução de dimensionalidade foi atualizada para MRL-E (Matryoshka Representation Learning), melhorando a eficiência do treinamento e da inferência, ao mesmo tempo em que oferece suporte a aplicações multiescala flexíveis. Resultados Online: O GAUC de cliques e a eficiência de conversão do ranking de comerciantes melhoraram significativamente. Os dados online mostraram um aumento significativo nos cliques efetivos e na taxa de conversão da página de resultados (QV_CTR), demonstrando plenamente que a representação semântica do LLM não apenas traz mais oportunidades de exposição, mas também otimiza a qualidade geral da conversão por meio de recomendações precisas.3. Fase III: Introdução de representações e características cruzadas na classificação a jusante
Após concluir a reconstrução sistemática do ranking de comerciantes, a equipe aplicou ainda mais a solução madura ao ranking a jusante (ou seja, o ranking de produtos específicos de um comerciante), ao mesmo tempo em que avançava na governança e no aprimoramento das características estatísticas cruzadas em toda a plataforma.
Superando os desafios de cobertura: Devido às diferenças fundamentais na distribuição de consultas entre o ranking de lojistas e o ranking de produtos, a migração inicial enfrentou desafios relacionados à baixa cobertura de consultas. Por meio de um alinhamento detalhado e da governança de dados em ambas as extremidades, a equipe conseguiu estender com sucesso a capacidade de representação semântica do LLM de maneira integrada até o nível do produto. Progresso paralelo: combinando a “transferência de representação do LLM” com a modelagem de dimensões cruzadas, como “personalização × produto” e “intenção da consulta × produto”, os resultados de pesquisa alcançaram outro salto em precisão.III. Resumo e Perspectivas
A evolução do Meituan Search 3.0 mostra que a aplicação de LLMs no campo do estilo de vida local não é um sucesso da noite para o dia, mas requer um caminho sólido que vai desde a validação de características pontuais, passando pela reconstrução sistemática da representação, até a generalização e reutilização entre cenários. Ao transformar a poderosa capacidade de compreensão semântica dos LLMs em representações contínuas densas e características de agrupamento discreto, a Meituan conseguiu quebrar as barreiras entre intenções complexas e oferta não padronizada em cenários de varejo de serviços, proporcionando aos usuários uma experiência de busca de estilo de vida local mais precisa e inteligente.








 O ChatGPT sofreu uma grande interrupção no serviço; milhões de usuários enfrentaram problemas para fazer login
A estabilidade dos servidores continua sendo um ponto crítico no setor de inteligência artificial. Relatos indicam que o ChatGPT, a principal plataforma de chat de IA do mundo, sofreu uma interrupção
 A Moonshot Ventures pode lançar uma oferta pública inicial (IPO) em Hong Kong para financiar uma grande iniciativa voltada para modelos
A Bloomberg informa que a Moonshot AI, uma das principais empresas chinesas de IA, está avaliando a possibilidade de realizar uma oferta pública inicial (IPO) em Hong Kong.A Moonshot AI, com sede em P
 A Marvis lança a função “Modelo Personalizado”, integrando o Kimi e o Zhipu GLM
Em 1º de setembro, o Marvis, assistente de IA da Tencent que opera no nível do sistema operacional, lançou oficialmente seu recurso “Modelo Personalizado”. Essa atualização permite que os usuários int
As melhores ferramentas de geração de voz por IA mais recentes e com as melhores avaliações de 2026 para criar vocais de demonstração e camadas de harmonia estão aqui no XIX.AI. Esta coleção selecionada apresenta soluções poderosas e revolucionárias que passaram por rigorosos testes no mundo real. Fornecemos uma comparação semanal atualizada entre versões gratuitas e pagas, juntamente com classificações detalhadas, para ajudá-lo a encontrar a ferramenta perfeita para impulsionar sua criatividade e produtividade. Explore agora para desbloquear sua vantagem com IA.
12 ferramentas
xix.ai

Os melhores assistentes de IA com foco em produtividade de 2026, cuidadosamente selecionados para reduzir a troca de contexto e manter sua produtividade durante todo o dia. Essas ferramentas poderosas passam por testes rigorosos em condições reais, com uma comparação entre versões gratuitas e pagas, além de rankings atualizados semanalmente. Descubra a ferramenta perfeita para aumentar sua eficiência na escrita, estimular ideias criativas e manter o foco sem distrações. Explore agora no XIX.AI para aproveitar ao máximo sua vantagem com IA.
9 ferramentas
xix.ai

Os melhores e mais atualizados ferramentas de edição por IA com alta avaliação, ideais para textos profissionais claros, estão disponíveis aqui no XIX.AI! Esta lista selecionada apresenta soluções poderosas e revolucionárias que ajudam a aumentar significativamente a eficiência na escrita, graças a testes em condições reais e classificações rigorosas. Você encontrará uma comparação entre as opções gratuitas e as pagas para auxiliá-lo a escolher a melhor alternativa. Explore agora e aproveite todas as vantagens oferecidas pela IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de limpeza de movimento com IA de 2026 para redirecionamento de captura de movimento (mocap) em vídeos curtos, anúncios e trailers de jogos! A XIX.AI selecionou uma coleção poderosa e revolucionária, com rankings atualizados semanalmente, comparação entre versões gratuitas e pagas e testes práticos para ajudar você a encontrar a solução imperdível que aumenta a produtividade e libera seu potencial criativo. Explore agora para descobrir a ferramenta perfeita para edições de movimento impecáveis.
9 ferramentas
xix.ai

2026 Últimas Melhores Geradores de Fundo de Mangá com IA Mais Bem Avaliados para Histórias em Série! Esta lista selecionada apresenta ferramentas poderosas que mudam o jogo, ajudando os criadores a produzir conteúdo visual impressionante rapidamente, aumentando significativamente a produtividade. Cada opção passou por testes no mundo real para garantir a mais alta qualidade. Confira a comparação entre gratuito e pago e as classificações para encontrar a opção perfeita para você. Explore agora na XIX.AI para desbloquear sua vantagem com IA na criação de mangás.
9 ferramentas
xix.ai

O “Ranking dos Melhores Companheiros de Conversação com IA de 2026” apresenta ferramentas poderosas e bem avaliadas, conhecidas por sua capacidade de manter conversas naturais e reter memória de longo prazo. Essa lista cuidadosamente selecionada inclui opções imperdíveis, tanto gratuitas quanto pagas, respaldadas por testes reais e rankings atualizados semanalmente. O XIX.AI se destaca como uma opção confiável nessa coleção de elite. Explore agora para descobrir seu companheiro de bate-papo com IA perfeito e potencialize sua produtividade ainda hoje.
11 ferramentas
xix.ai












