


 Maison
Meitun Search 3.0 s'appuie sur des modèles à grande échelle pour repenser l'infrastructure de recherche dédiée à la vie locale
À mesure que la technologie des grands modèles linguistiques (LLM) progresse, les moteurs de recherche connaissent un troisième changement de paradigme, passant d’une correspondance textuelle traditionnelle basée sur des mots-clés à une ère 3.0 axée sur la compréhension des intentions complexes et la prise de décision cognitive. Récemment, l’équipe technique de Meituan a publié une analyse technique approfondie, détaillant les trois itérations de Meituan Search 3.0 dans le cadre de scénarios de classement des services de vente au détail, et décrivant la voie de mise en œuvre ainsi que la valeur fondamentale de la représentation sémantique des LLM dans des contextes complexes de la vie locale.
I. Une percée dans le commerce de services : de la correspondance lexicale traditionnelle à la reconstruction sémantique par les LLM
Le commerce de services diffère fondamentalement du commerce de produits par son modèle économique. Contrairement au commerce de produits hautement standardisé, le commerce de services de Meituan et les scénarios liés au mode de vie local se caractérisent par des catégories diverses, des demandes de recherche variées (transactionnelles, informatives et de génération de prospects) et une offre très peu standardisée.
Dans les recherches quotidiennes, les modèles de classement traditionnels s’appuient largement sur la correspondance lexicale. Cependant, face à des catégories de « longue traîne » massives et à des intentions d’utilisateurs complexes, la capacité de généralisation de l’ingénierie des caractéristiques traditionnelle s’avère clairement insuffisante. Par exemple, lorsqu’un utilisateur recherche « spa pour animaux + bain », le nom du commerçant ou du produit correspondant peut être « Forfait nettoyage et soins pour animaux » ; s’il recherche « nettoyage du Nouvel An chinois », il peut s’agir de « Forfait service de nettoyage en profondeur ». Dans ces cas typiques, il y a peu de recoupements entre la requête et l’offre à première vue, mais leurs sémantiques sous-jacentes sont étroitement liées.
Pour combler ce fossé sémantique traditionnel, l’équipe de classement des recherches de services de vente au détail de Meituan a systématiquement exploré, au cours de l’année écoulée, l’application des modèles de langage de grande envergure (LLM) dans les modèles de classement. En générant des représentations vectorielles sémantiques de haute qualité pour les requêtes de recherche (Query), les commerçants (POI) et les offres (Deal), elle a intégré des signaux de correspondance sémantique dans le modèle de classement à l’aide de la similarité cosinus, réalisant ainsi un bond en avant : de la validation ponctuelle des caractéristiques à la reconstruction systématique, puis à la migration et à la réutilisation entre différents scénarios.
II. Les trois étapes de l’évolution technique : de la vérification de la faisabilité à la construction d’un système à grande échelle
1. Phase I : Intégration de la représentation sémantique des LLM dans le classement (vérification de la faisabilité)
Au cours de la première phase, l’objectif principal de l’équipe était simple : vérifier si les représentations des LLM pouvaient apporter une aide substantielle au modèle de classement.
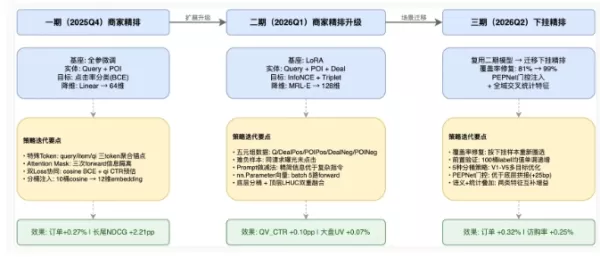
Conception technique : un modèle de base open source à faible nombre de paramètres a été sélectionné pour un réglage fin complet des paramètres, avec l’introduction de tokens spécifiques dans le vocabulaire servant de points d’ancrage pour l’agrégation. Des masques d’attention ont été soigneusement conçus pour isoler les requêtes des informations sur les marchands. Injection de caractéristiques : une fois les embeddings générés par le modèle, la similarité cosinus a été calculée et classée par tranches discrètes, puis concaténée sous forme d’embeddings apprenables dans les caractéristiques du modèle de classement. Résultats en ligne : la validation hors ligne a montré une amélioration significative du NDCG des clics. Après le déploiement, le nombre total de commandes de paiement issues de la recherche et de commandes de services au détail a connu une augmentation significative, en particulier dans les scénarios de « longue traîne » où la correspondance lexicale traditionnelle était la plus faible, avec une réduction notable des cas erronés. Cela a directement démontré le grand potentiel de la représentation sémantique des LLM dans le scénario de classement.2. Phase II : mise à niveau systématique des représentations pour le classement des commerçants
Afin de remédier aux points faibles mis en évidence lors de la phase I, tels que l’absence de représentation sémantique du côté des produits, les coûts élevés du réglage fin de l’ensemble des paramètres et les objectifs d’optimisation incomplets, la phase II a consisté en une refonte systématique de l’ensemble du processus de production des représentations.
Apprentissage par pentuples et contrastif : un ensemble de données d’entraînement par pentuples a été constitué, comprenant la requête, des échantillons positifs de produits, des échantillons positifs de marchands et des échantillons négatifs difficiles. L’objectif traditionnel de classification binaire a été complètement abandonné, et les pertes InfoNCE et Triplet ont été pleinement introduites, résolvant parfaitement la question de « l’ordre relatif entre plusieurs candidats » qui intéresse véritablement le modèle de classement.Extraction légère et efficace : en passant du réglage fin de tous les paramètres aux méthodes LoRA, des séquences indépendantes et des vecteurs apprenables ont remplacé l’ancienne approche, et la réduction de dimensionnalité a été améliorée pour adopter le MRL-E (Matryoshka Representation Learning), ce qui a permis d’améliorer l’efficacité de l’entraînement et de l’inférence tout en prenant en charge des applications multi-échelles flexibles. Résultats en ligne : Le GAUC des clics et l’efficacité de conversion du classement des marchands se sont considérablement améliorés. Les données en ligne ont montré une hausse significative des clics effectifs et du taux de conversion des pages de résultats (QV_CTR), démontrant pleinement que la représentation sémantique des LLM apporte non seulement davantage d’opportunités de visibilité, mais optimise également la qualité globale de la conversion grâce à des recommandations précises.3. Phase III : introduction des représentations et des caractéristiques croisées dans le classement en aval
Après avoir achevé la refonte systématique du classement des commerçants, l’équipe a ensuite appliqué cette solution éprouvée au classement en aval (c’est-à-dire le classement de produits spécifiques proposés par un commerçant), tout en améliorant simultanément la gestion et l’enrichissement des caractéristiques statistiques croisées à tous les niveaux.
Résolution des défis liés à la couverture : en raison des différences fondamentales dans la répartition des requêtes entre le classement des marchands et le classement en aval, la migration initiale s’est heurtée à des difficultés liées à une faible couverture des requêtes. Grâce à un alignement fin et à une gouvernance des données aux deux niveaux, l’équipe a réussi à étendre de manière transparente la capacité de représentation sémantique du LLM au niveau des produits. Progrès parallèles : en combinant le « transfert de représentation LLM » avec la modélisation de dimensions croisées telles que « personnalisation × produit » et « intention de requête × produit », les résultats de recherche ont franchi une nouvelle étape en matière de précision.III. Synthèse et perspectives
L’évolution de Meituan Search 3.0 montre que l’application des LLM dans le domaine des services de proximité ne se fait pas du jour au lendemain, mais nécessite un parcours solide allant de la validation ponctuelle des caractéristiques à la reconstruction systématique des représentations, en passant par la généralisation et la réutilisation entre différents scénarios. En transformant la puissante capacité de compréhension sémantique des LLM en représentations continues denses et en caractéristiques de regroupement discrètes, Meituan a réussi à briser les barrières entre les intentions complexes et l’offre non standardisée dans les scénarios de vente au détail de services, offrant ainsi aux utilisateurs une expérience de recherche locale en matière de mode de vie plus précise et plus intelligente.
Article connexe
 ChatGPT a subi une panne majeure, des millions d'utilisateurs ont rencontré des problèmes de connexion
La stabilité des serveurs reste une priorité absolue dans le secteur de l’intelligence artificielle. Selon certaines informations, ChatGPT, la première plateforme mondiale de chat basée sur l’IA, aura
Moonshot Ventures pourrait lancer une introduction en bourse à Hong Kong pour financer son offensive sur les grands modèles
Selon Bloomberg, Moonshot AI, l'une des principales entreprises chinoises spécialisées dans l'intelligence artificielle, envisage une introduction en bourse à Hong Kong.Basée à Pékin, Moonsh
Marvis dévoile une fonctionnalité de modèles personnalisés, intégrant les modèles GLM de Kimi et Zhipu
Le 1er septembre, Marvis, l’assistant IA de Tencent intégré au système d’exploitation, a officiellement lancé sa fonctionnalité « Modèle personnalisé ». Cette mise à jour permet aux utilisateurs d’int
Recommandations de sujets spéciaux liés
Productivité
 Les meilleurs assistants d'aide à la concentration basés sur l'IA : réduisez les changements de contexte et restez concentré sur vos tâches
Les meilleurs assistants IA de 2026, triés sur le volet pour réduire les changements de contexte et vous permettre de rester productif toute la journée. Ces outils puissants sont soumis à des tests rigoureux en conditions réelles et font l'objet d'une comparaison entre les versions gratuites et payantes, ainsi que d'un classement mis à jour chaque semaine. Découvrez l'outil idéal pour améliorer votre efficacité à l'écrit, stimuler votre créativité et rester concentré sans distraction. Découvrez-les dès maintenant sur XIX.AI pour exploiter tout le potentiel de l’IA.
 9 outils
 xix.ai
en écrivant
Meilleurs outils d’édition par IA pour un écrit professionnel clair
Les meilleures outils d’édition par IA de 2026, hautement notés et conçus pour un écrit professionnel clair, sont disponibles sur XIX.AI ! Cette liste rigoureusement sélectionnée présente des solutions puissantes capables de transformer votre façon de travailler, vous permettant d’améliorer considérablement l’efficacité de votre rédaction grâce à des tests en conditions réelles et à une évaluation approfondie. Vous y trouverez également une comparaison entre les versions gratuites et payantes afin de choisir celle qui correspond le mieux à vos besoins. Découvrez-les dès maintenant et tirez parti de l’avantage offert par l’IA !
10 outils
xix.ai
Création d'animations
Meilleurs outils d’édition de mouvements par IA pour le retargeting de mocap dans les vidéos Shorts, les publicités et les bandes-annonces de jeux
Les meilleures outils d’édition de mouvement par IA les plus récents et hautement notés en 2026 pour le retargeting via mocap dans les vidéos Shorts, les publicités et les trailers de jeux ! XIX.AI a sélectionné une collection révolutionnaire, mise à jour chaque semaine, comprenant des comparaisons entre versions gratuites et payantes ainsi que des tests pratiques, afin de vous aider à trouver la solution idéale qui améliorera votre productivité et libérera tout votre potentiel créatif. Découvrez dès maintenant l’outil parfait pour des montages de mouvement sans défaut.
9 outils
xix.ai
Création de bande dessinée
Meilleurs générateurs d'arrière-plans de manga par IA pour les histoires sérialisées
2026 Derniers Meilleurs Générateurs de Fonds de Manga par IA les mieux notés pour les Histoires Sérialisées ! Cette liste soigneusement sélectionnée présente des outils puissants qui changent la donne, aidant les créateurs à concevoir rapidement du contenu visuel époustouflant, augmentant considérablement leur productivité. Chaque option a été testée dans des conditions réelles pour garantir une qualité optimale. Consultez la comparaison entre les versions gratuites et payantes ainsi que les classements pour trouver celle qui vous convient parfaitement. Explorez dès maintenant sur XIX.AI pour débloquer votre avantage IA dans la création de manga.
9 outils
xix.ai
chatbot
Les meilleurs assistants de chat basés sur l'IA : engagez des conversations naturelles grâce à leur mémoire à long terme
Le classement 2026 des meilleurs assistants conversationnels IA présente des outils performants et très bien notés, réputés pour leur capacité à mener des conversations naturelles et à conserver une mémoire à long terme. Cette sélection comprend des options incontournables, tant gratuites que payantes, validées par des tests en conditions réelles et un classement mis à jour chaque semaine. XIX.AI s'impose comme un choix de confiance au sein de cette sélection d'élite. Découvrez dès maintenant l’assistant de chat IA qui vous convient le mieux et boostez votre productivité dès aujourd’hui.
11 outils
xix.ai
Création d'animations
Meilleurs générateurs d’animation par IA : transformez vos idées en clips animés rapidement
2026 Dernières Meilleures Générateurs d'Animation IA les mieux notés ! XIX.AI sélectionne une collection puissante et révolutionnaire d'outils incontournables pour transformer rapidement vos idées créatives en clips animés de haute qualité. Chaque option a été soumise à des tests rigoureux en conditions réelles, avec des comparaisons détaillées entre les versions gratuite et payante, ainsi que des classements mis à jour chaque semaine pour vous aider à trouver la solution idéale afin d'optimiser votre productivité en animation. Explorez dès maintenant pour débloquer votre avantage par l'IA !
11 outils
xix.ai

 commentaires (0)
À mesure que la technologie des grands modèles linguistiques (LLM) progresse, les moteurs de recherche connaissent un troisième changement de paradigme, passant d’une correspondance textuelle traditionnelle basée sur des mots-clés à une ère 3.0 axée sur la compréhension des intentions complexes et la prise de décision cognitive. Récemment, l’équipe technique de Meituan a publié une analyse technique approfondie, détaillant les trois itérations de Meituan Search 3.0 dans le cadre de scénarios de classement des services de vente au détail, et décrivant la voie de mise en œuvre ainsi que la valeur fondamentale de la représentation sémantique des LLM dans des contextes complexes de la vie locale.
I. Une percée dans le commerce de services : de la correspondance lexicale traditionnelle à la reconstruction sémantique par les LLM
Le commerce de services diffère fondamentalement du commerce de produits par son modèle économique. Contrairement au commerce de produits hautement standardisé, le commerce de services de Meituan et les scénarios liés au mode de vie local se caractérisent par des catégories diverses, des demandes de recherche variées (transactionnelles, informatives et de génération de prospects) et une offre très peu standardisée.
Dans les recherches quotidiennes, les modèles de classement traditionnels s’appuient largement sur la correspondance lexicale. Cependant, face à des catégories de « longue traîne » massives et à des intentions d’utilisateurs complexes, la capacité de généralisation de l’ingénierie des caractéristiques traditionnelle s’avère clairement insuffisante. Par exemple, lorsqu’un utilisateur recherche « spa pour animaux + bain », le nom du commerçant ou du produit correspondant peut être « Forfait nettoyage et soins pour animaux » ; s’il recherche « nettoyage du Nouvel An chinois », il peut s’agir de « Forfait service de nettoyage en profondeur ». Dans ces cas typiques, il y a peu de recoupements entre la requête et l’offre à première vue, mais leurs sémantiques sous-jacentes sont étroitement liées.
Pour combler ce fossé sémantique traditionnel, l’équipe de classement des recherches de services de vente au détail de Meituan a systématiquement exploré, au cours de l’année écoulée, l’application des modèles de langage de grande envergure (LLM) dans les modèles de classement. En générant des représentations vectorielles sémantiques de haute qualité pour les requêtes de recherche (Query), les commerçants (POI) et les offres (Deal), elle a intégré des signaux de correspondance sémantique dans le modèle de classement à l’aide de la similarité cosinus, réalisant ainsi un bond en avant : de la validation ponctuelle des caractéristiques à la reconstruction systématique, puis à la migration et à la réutilisation entre différents scénarios.
II. Les trois étapes de l’évolution technique : de la vérification de la faisabilité à la construction d’un système à grande échelle
1. Phase I : Intégration de la représentation sémantique des LLM dans le classement (vérification de la faisabilité)
Au cours de la première phase, l’objectif principal de l’équipe était simple : vérifier si les représentations des LLM pouvaient apporter une aide substantielle au modèle de classement.
Conception technique : un modèle de base open source à faible nombre de paramètres a été sélectionné pour un réglage fin complet des paramètres, avec l’introduction de tokens spécifiques dans le vocabulaire servant de points d’ancrage pour l’agrégation. Des masques d’attention ont été soigneusement conçus pour isoler les requêtes des informations sur les marchands. Injection de caractéristiques : une fois les embeddings générés par le modèle, la similarité cosinus a été calculée et classée par tranches discrètes, puis concaténée sous forme d’embeddings apprenables dans les caractéristiques du modèle de classement. Résultats en ligne : la validation hors ligne a montré une amélioration significative du NDCG des clics. Après le déploiement, le nombre total de commandes de paiement issues de la recherche et de commandes de services au détail a connu une augmentation significative, en particulier dans les scénarios de « longue traîne » où la correspondance lexicale traditionnelle était la plus faible, avec une réduction notable des cas erronés. Cela a directement démontré le grand potentiel de la représentation sémantique des LLM dans le scénario de classement.2. Phase II : mise à niveau systématique des représentations pour le classement des commerçants
Afin de remédier aux points faibles mis en évidence lors de la phase I, tels que l’absence de représentation sémantique du côté des produits, les coûts élevés du réglage fin de l’ensemble des paramètres et les objectifs d’optimisation incomplets, la phase II a consisté en une refonte systématique de l’ensemble du processus de production des représentations.
Apprentissage par pentuples et contrastif : un ensemble de données d’entraînement par pentuples a été constitué, comprenant la requête, des échantillons positifs de produits, des échantillons positifs de marchands et des échantillons négatifs difficiles. L’objectif traditionnel de classification binaire a été complètement abandonné, et les pertes InfoNCE et Triplet ont été pleinement introduites, résolvant parfaitement la question de « l’ordre relatif entre plusieurs candidats » qui intéresse véritablement le modèle de classement.Extraction légère et efficace : en passant du réglage fin de tous les paramètres aux méthodes LoRA, des séquences indépendantes et des vecteurs apprenables ont remplacé l’ancienne approche, et la réduction de dimensionnalité a été améliorée pour adopter le MRL-E (Matryoshka Representation Learning), ce qui a permis d’améliorer l’efficacité de l’entraînement et de l’inférence tout en prenant en charge des applications multi-échelles flexibles. Résultats en ligne : Le GAUC des clics et l’efficacité de conversion du classement des marchands se sont considérablement améliorés. Les données en ligne ont montré une hausse significative des clics effectifs et du taux de conversion des pages de résultats (QV_CTR), démontrant pleinement que la représentation sémantique des LLM apporte non seulement davantage d’opportunités de visibilité, mais optimise également la qualité globale de la conversion grâce à des recommandations précises.3. Phase III : introduction des représentations et des caractéristiques croisées dans le classement en aval
Après avoir achevé la refonte systématique du classement des commerçants, l’équipe a ensuite appliqué cette solution éprouvée au classement en aval (c’est-à-dire le classement de produits spécifiques proposés par un commerçant), tout en améliorant simultanément la gestion et l’enrichissement des caractéristiques statistiques croisées à tous les niveaux.
Résolution des défis liés à la couverture : en raison des différences fondamentales dans la répartition des requêtes entre le classement des marchands et le classement en aval, la migration initiale s’est heurtée à des difficultés liées à une faible couverture des requêtes. Grâce à un alignement fin et à une gouvernance des données aux deux niveaux, l’équipe a réussi à étendre de manière transparente la capacité de représentation sémantique du LLM au niveau des produits. Progrès parallèles : en combinant le « transfert de représentation LLM » avec la modélisation de dimensions croisées telles que « personnalisation × produit » et « intention de requête × produit », les résultats de recherche ont franchi une nouvelle étape en matière de précision.III. Synthèse et perspectives
L’évolution de Meituan Search 3.0 montre que l’application des LLM dans le domaine des services de proximité ne se fait pas du jour au lendemain, mais nécessite un parcours solide allant de la validation ponctuelle des caractéristiques à la reconstruction systématique des représentations, en passant par la généralisation et la réutilisation entre différents scénarios. En transformant la puissante capacité de compréhension sémantique des LLM en représentations continues denses et en caractéristiques de regroupement discrètes, Meituan a réussi à briser les barrières entre les intentions complexes et l’offre non standardisée dans les scénarios de vente au détail de services, offrant ainsi aux utilisateurs une expérience de recherche locale en matière de mode de vie plus précise et plus intelligente.








 ChatGPT a subi une panne majeure, des millions d'utilisateurs ont rencontré des problèmes de connexion
La stabilité des serveurs reste une priorité absolue dans le secteur de l’intelligence artificielle. Selon certaines informations, ChatGPT, la première plateforme mondiale de chat basée sur l’IA, aura
 Moonshot Ventures pourrait lancer une introduction en bourse à Hong Kong pour financer son offensive sur les grands modèles
Selon Bloomberg, Moonshot AI, l'une des principales entreprises chinoises spécialisées dans l'intelligence artificielle, envisage une introduction en bourse à Hong Kong.Basée à Pékin, Moonsh
 Marvis dévoile une fonctionnalité de modèles personnalisés, intégrant les modèles GLM de Kimi et Zhipu
Le 1er septembre, Marvis, l’assistant IA de Tencent intégré au système d’exploitation, a officiellement lancé sa fonctionnalité « Modèle personnalisé ». Cette mise à jour permet aux utilisateurs d’int

Les meilleurs assistants IA de 2026, triés sur le volet pour réduire les changements de contexte et vous permettre de rester productif toute la journée. Ces outils puissants sont soumis à des tests rigoureux en conditions réelles et font l'objet d'une comparaison entre les versions gratuites et payantes, ainsi que d'un classement mis à jour chaque semaine. Découvrez l'outil idéal pour améliorer votre efficacité à l'écrit, stimuler votre créativité et rester concentré sans distraction. Découvrez-les dès maintenant sur XIX.AI pour exploiter tout le potentiel de l’IA.
9 outils
xix.ai

Les meilleures outils d’édition par IA de 2026, hautement notés et conçus pour un écrit professionnel clair, sont disponibles sur XIX.AI ! Cette liste rigoureusement sélectionnée présente des solutions puissantes capables de transformer votre façon de travailler, vous permettant d’améliorer considérablement l’efficacité de votre rédaction grâce à des tests en conditions réelles et à une évaluation approfondie. Vous y trouverez également une comparaison entre les versions gratuites et payantes afin de choisir celle qui correspond le mieux à vos besoins. Découvrez-les dès maintenant et tirez parti de l’avantage offert par l’IA !
10 outils
xix.ai

Les meilleures outils d’édition de mouvement par IA les plus récents et hautement notés en 2026 pour le retargeting via mocap dans les vidéos Shorts, les publicités et les trailers de jeux ! XIX.AI a sélectionné une collection révolutionnaire, mise à jour chaque semaine, comprenant des comparaisons entre versions gratuites et payantes ainsi que des tests pratiques, afin de vous aider à trouver la solution idéale qui améliorera votre productivité et libérera tout votre potentiel créatif. Découvrez dès maintenant l’outil parfait pour des montages de mouvement sans défaut.
9 outils
xix.ai

2026 Derniers Meilleurs Générateurs de Fonds de Manga par IA les mieux notés pour les Histoires Sérialisées ! Cette liste soigneusement sélectionnée présente des outils puissants qui changent la donne, aidant les créateurs à concevoir rapidement du contenu visuel époustouflant, augmentant considérablement leur productivité. Chaque option a été testée dans des conditions réelles pour garantir une qualité optimale. Consultez la comparaison entre les versions gratuites et payantes ainsi que les classements pour trouver celle qui vous convient parfaitement. Explorez dès maintenant sur XIX.AI pour débloquer votre avantage IA dans la création de manga.
9 outils
xix.ai

Le classement 2026 des meilleurs assistants conversationnels IA présente des outils performants et très bien notés, réputés pour leur capacité à mener des conversations naturelles et à conserver une mémoire à long terme. Cette sélection comprend des options incontournables, tant gratuites que payantes, validées par des tests en conditions réelles et un classement mis à jour chaque semaine. XIX.AI s'impose comme un choix de confiance au sein de cette sélection d'élite. Découvrez dès maintenant l’assistant de chat IA qui vous convient le mieux et boostez votre productivité dès aujourd’hui.
11 outils
xix.ai
2026 Dernières Meilleures Générateurs d'Animation IA les mieux notés ! XIX.AI sélectionne une collection puissante et révolutionnaire d'outils incontournables pour transformer rapidement vos idées créatives en clips animés de haute qualité. Chaque option a été soumise à des tests rigoureux en conditions réelles, avec des comparaisons détaillées entre les versions gratuite et payante, ainsi que des classements mis à jour chaque semaine pour vous aider à trouver la solution idéale afin d'optimiser votre productivité en animation. Explorez dès maintenant pour débloquer votre avantage par l'IA !
11 outils
xix.ai












