


 Hogar
Meitun Search 3.0 aprovecha los modelos a gran escala para reconstruir la infraestructura de búsqueda de servicios locales
A medida que avanza la tecnología de los modelos de lenguaje a gran escala (LLM), los motores de búsqueda están experimentando un tercer cambio de paradigma, pasando de la tradicional búsqueda de coincidencias de texto basada en palabras clave a una era 3.0 centrada en la comprensión de intenciones complejas y la toma de decisiones cognitiva. Recientemente, el equipo técnico de Meituan ha publicado un análisis técnico en profundidad en el que se detallan tres iteraciones de Meituan Search 3.0 en escenarios de clasificación de servicios minoristas, y se esboza la vía de implementación y el valor fundamental de la representación semántica de los LLM en contextos complejos de la vida local.
I. Un salto cualitativo en el comercio minorista de servicios: de la coincidencia léxica tradicional a la reconstrucción semántica de los LLM
El comercio minorista de servicios difiere fundamentalmente del comercio minorista de productos en su modelo de negocio. A diferencia del comercio minorista de productos, altamente estandarizado, el comercio minorista de servicios de Meituan y los escenarios de estilo de vida local se caracterizan por categorías diversas, demandas de búsqueda variadas (transaccionales, informativas y de generación de clientes potenciales) y una oferta muy poco estandarizada.
En las búsquedas diarias, los modelos de clasificación tradicionales se basan en gran medida en la coincidencia léxica. Sin embargo, ante la enorme cantidad de categorías de «cola larga» y las complejas intenciones de los usuarios, la capacidad de generalización de la ingeniería de características tradicional resulta claramente insuficiente. Por ejemplo, cuando un usuario busca «spa para mascotas + baño», el nombre del comerciante o del producto correspondiente podría ser «Paquete de limpieza y cuidado de mascotas»; al buscar «limpieza del Festival de Primavera», podría ser «Paquete de servicio de limpieza a fondo». En estos casos típicos, a simple vista hay poco solapamiento entre la consulta y la oferta, pero su semántica subyacente está estrechamente relacionada.
Para salvar esta brecha semántica tradicional, el equipo de clasificación de búsquedas de servicios minoristas de Meituan ha explorado sistemáticamente la aplicación de los modelos de lenguaje grande (LLM) en los modelos de clasificación durante el último año. Mediante la generación de representaciones vectoriales semánticas de alta calidad para las consultas de búsqueda (Query), los comercios (POI) y las ofertas (Deal), han incorporado señales de coincidencia semántica en el modelo de clasificación utilizando la similitud coseno, logrando así dar un salto desde la validación de características puntuales a la reconstrucción sistemática y, posteriormente, a la migración y reutilización entre distintos escenarios.
II. Tres etapas de evolución técnica: de la verificación de la viabilidad a la construcción del sistema a gran escala
1. Fase I: Introducción de la representación semántica de los LLM en la clasificación (verificación de la viabilidad)
En la primera fase, el objetivo principal del equipo era sencillo: verificar si las representaciones de los LLM podían aportar una ayuda sustancial al modelo de clasificación.
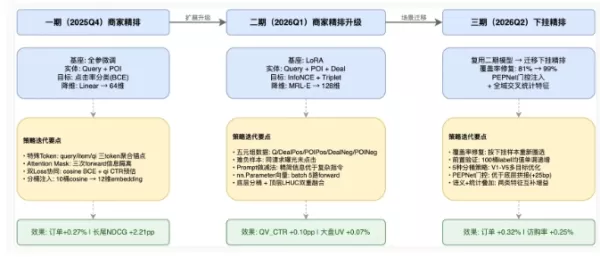
Diseño técnico: se seleccionó un modelo base de código abierto con pocos parámetros para su ajuste fino con todos los parámetros, introduciendo tokens especiales en el vocabulario como puntos de referencia de agregación. Se diseñaron cuidadosamente máscaras de atención para aislar las consultas de la información de los comerciantes. Inyección de características: una vez que el modelo generó las incrustaciones, se calculó la similitud coseno y se agrupó de forma discreta; a continuación, se concatenaron como incrustaciones aprendibles en las características del modelo de clasificación. Resultados en línea: la validación fuera de línea mostró una mejora significativa en el NDCG de clics. Tras la implementación, se observó un aumento significativo en el total de pedidos de pago por búsqueda y en los pedidos minoristas de servicios, especialmente en escenarios de cola larga, donde la coincidencia léxica tradicional era más débil, con una notable reducción de los casos erróneos. Esto demostró directamente el gran potencial de la representación semántica de los LLM en el escenario de clasificación.2. Fase II: Actualización sistemática de las representaciones de clasificación de comerciantes
Para abordar los puntos débiles detectados en la Fase I, como la falta de representación semántica por parte de los productos, los elevados costes del ajuste fino de todos los parámetros y los objetivos de optimización incompletos, la Fase II implicó una reconstrucción sistemática de todo el proceso de generación de representaciones.
Aprendizaje en pentupletas y contrastivo: se creó un conjunto de datos de entrenamiento en pentupletas, que incluía la consulta, muestras positivas de productos, muestras positivas de comerciantes y muestras negativas difíciles. Se abandonó por completo el objetivo tradicional de clasificación binaria y se introdujeron plenamente la pérdida InfoNCE y la pérdida de tripletas, lo que resolvió a la perfección la cuestión del «orden relativo entre múltiples candidatos», que es lo que realmente importa al modelo de clasificación.Extracción ligera y eficiente: Al pasar del ajuste fino de todos los parámetros a los métodos LoRA, las secuencias independientes y los vectores aprendibles sustituyeron al enfoque anterior, y la reducción de dimensionalidad se actualizó a MRL-E (Matryoshka Representation Learning), lo que mejoró la eficiencia del entrenamiento y la inferencia, al tiempo que permitió aplicaciones flexibles a múltiples escalas. Resultados en línea: El GAUC de clics y la eficiencia de conversión de la clasificación de comerciantes mejoraron significativamente. Los datos en línea mostraron un aumento significativo de los clics efectivos y de la tasa de conversión de la página de resultados (QV_CTR), lo que demostró plenamente que la representación semántica de los LLM no solo aporta más oportunidades de exposición, sino que también optimiza la calidad general de la conversión mediante recomendaciones precisas.3. Fase III: Introducción de representaciones y características cruzadas en la clasificación posterior
Tras completar la reconstrucción sistemática de la clasificación de comerciantes, el equipo aplicó además la solución consolidada a la clasificación de productos (es decir, la clasificación de productos específicos de un comerciante), al tiempo que avanzaba en la gestión y la ampliación de las características estadísticas cruzadas en todos los ámbitos.
Resolución de los retos de cobertura: Debido a las diferencias fundamentales en la distribución de las consultas entre el ranking de comerciantes y el ranking posterior, la migración inicial se enfrentó a retos relacionados con una baja cobertura de consultas. Mediante una alineación detallada y la gestión de datos en ambos extremos, el equipo logró extender con éxito y sin problemas la capacidad de representación semántica del LLM al nivel de los productos. Progreso paralelo: al combinar la «transferencia de representaciones del LLM» con el modelado de dimensiones cruzadas como «personalización × producto» e «intención de la consulta × producto», los resultados de búsqueda lograron otro salto cualitativo en precisión.III. Resumen y perspectivas
La evolución de Meituan Search 3.0 demuestra que la aplicación de los LLM en el ámbito del estilo de vida local no es un éxito de la noche a la mañana, sino que requiere un camino sólido que va desde la validación de características puntuales, pasando por la reconstrucción sistemática de la representación, hasta la generalización y la reutilización en distintos escenarios. Al transformar la potente capacidad de comprensión semántica de los LLM en representaciones continuas densas y características de agrupación discreta, Meituan ha logrado romper las barreras entre las intenciones complejas y la oferta no estandarizada en los escenarios de venta minorista de servicios, proporcionando a los usuarios una experiencia de búsqueda de estilo de vida local más precisa e inteligente.
Artículo relacionado
 ChatGPT sufre una interrupción masiva del servicio; millones de usuarios han tenido problemas para iniciar sesión
La estabilidad de los servidores sigue siendo un aspecto fundamental en el sector de la inteligencia artificial. Según los informes, ChatGPT, la plataforma de chat con IA líder a nivel mundial, sufrió
Moonshot Ventures podría salir a bolsa en Hong Kong para financiar su apuesta por los modelos a gran escala
Bloomberg informa de que Moonshot AI, una de las principales empresas chinas de inteligencia artificial, está estudiando la posibilidad de salir a bolsa en Hong Kong.Moonshot AI, con sede en Pekín y c
Marvis presenta la función «Modelo personalizado», que integra Kimi y Zhipu GLM
El 1 de septiembre, Marvis, el asistente de IA a nivel de sistema operativo de Tencent, lanzó oficialmente su función «Modelo personalizado». Esta actualización permite a los usuarios integrar a la pe
Recomendaciones de temas especiales relacionados
Productividad
 Los mejores asistentes de concentración basados en IA: reduce los cambios de contexto y mantén la concentración
Los mejores asistentes de IA de 2026, seleccionados para reducir al mínimo los cambios de contexto y mantenerte productivo durante todo el día. Estas potentes herramientas se someten a rigurosas pruebas en condiciones reales y se presentan con una comparación entre las versiones gratuitas y de pago, además de clasificaciones que se actualizan semanalmente. Descubre la herramienta perfecta para potenciar tu eficiencia a la hora de escribir, dar rienda suelta a tus ideas creativas y mantener la concentración sin distracciones. Explora ahora en XIX.AI para sacar partido a tu ventaja con la IA.
 9 herramientas
 xix.ai
escribiendo
Mejores herramientas de edición con IA para un texto empresarial claro y preciso
¡Los mejores y más recientes herramientas de edición por IA con las calificaciones más altas para lograr un texto empresarial claro ya están disponibles en XIX.AI! Esta lista cuidadosamente seleccionada incluye soluciones potentes y revolucionarias que, gracias a pruebas en entornos reales y una evaluación rigurosa, le ayudarán a mejorar significativamente la eficiencia en su escritura. Encontrará una comparación entre las opciones gratuitas y de pago para que pueda elegir la más adecuada para sus necesidades. ¡Explore ahora y aproveche toda la ventaja que le brinda la inteligencia artificial!
10 herramientas
xix.ai
Creación de animación
Mejores herramientas de limpieza de movimiento por IA para el retargeting de mocap en videos cortos, anuncios y tráilers de juegos
¡Las mejores herramientas de 2026 para la limpieza de movimiento por IA, altamente calificadas y actualizadas, ideales para el retargeting de mocap en videos cortos, anuncios y tráilers de juegos! XIX.AI ha preparado una colección revolucionaria que incluye clasificaciones actualizadas semanalmente, comparaciones entre versiones gratuitas y de pago, así como pruebas en entornos reales, con el objetivo de ayudarte a encontrar la solución ideal que aumente tu productividad y potencie tu creatividad. Explórala ahora mismo para descubrir la herramienta perfecta para ediciones de movimiento impecables.
9 herramientas
xix.ai
Creación de cómics
Mejores generadores de fondos de manga con IA para historias serializadas
2026 Últimas mejores generadores de fondos para manga con inteligencia artificial mejor valorados para historias serializadas. Esta lista seleccionada incluye herramientas poderosas que cambian las reglas del juego y ayudan a los creadores a elaborar contenido visual impresionante rápidamente, aumentando significativamente la productividad. Cada opción ha sido sometida a pruebas en el mundo real para garantizar la máxima calidad. Consulta la comparación entre versiones gratuitas y de pago, así como los rankings, para encontrar la que mejor se adapte a tus necesidades. Explora ahora en XIX.AI para desbloquear tu ventaja con la inteligencia artificial en la creación de manga.
9 herramientas
xix.ai
chatbot
Los mejores asistentes de chat con IA: mantén conversaciones naturales con memoria a largo plazo
La clasificación de los mejores compañeros de chat con IA de 2026 presenta herramientas potentes y mejor valoradas, conocidas por su capacidad para mantener conversaciones naturales y conservar la memoria a largo plazo. Esta lista seleccionada incluye opciones que no te puedes perder, tanto gratuitas como de pago, respaldadas por pruebas en el mundo real y clasificaciones que se actualizan semanalmente. XIX.AI destaca como una opción de confianza dentro de esta selección de élite. Explórala ahora para descubrir tu compañero de chat con IA perfecto y potenciar tu productividad desde hoy mismo.
11 herramientas
xix.ai
Creación de animación
Mejores generadores de animación con IA: convierte tus ideas en clips de movimiento rápidamente
2026 Últimas Mejores Generadores de Animación con IA Mejor Valorados. XIX.AI selecciona una poderosa colección transformadora de herramientas imprescindibles para convertir ideas creativas en clips de movimiento de alta calidad de forma rápida. Cada opción ha pasado por rigurosas pruebas en el mundo real, con comparaciones detalladas entre versiones gratuitas y de pago, así como clasificaciones actualizadas semanalmente para ayudarte a encontrar la opción perfecta que impulse tu productividad en animación. Explora ahora para desbloquear tu ventaja con IA.
11 herramientas
xix.ai

 comentario (0)
0/500
A medida que avanza la tecnología de los modelos de lenguaje a gran escala (LLM), los motores de búsqueda están experimentando un tercer cambio de paradigma, pasando de la tradicional búsqueda de coincidencias de texto basada en palabras clave a una era 3.0 centrada en la comprensión de intenciones complejas y la toma de decisiones cognitiva. Recientemente, el equipo técnico de Meituan ha publicado un análisis técnico en profundidad en el que se detallan tres iteraciones de Meituan Search 3.0 en escenarios de clasificación de servicios minoristas, y se esboza la vía de implementación y el valor fundamental de la representación semántica de los LLM en contextos complejos de la vida local.
I. Un salto cualitativo en el comercio minorista de servicios: de la coincidencia léxica tradicional a la reconstrucción semántica de los LLM
El comercio minorista de servicios difiere fundamentalmente del comercio minorista de productos en su modelo de negocio. A diferencia del comercio minorista de productos, altamente estandarizado, el comercio minorista de servicios de Meituan y los escenarios de estilo de vida local se caracterizan por categorías diversas, demandas de búsqueda variadas (transaccionales, informativas y de generación de clientes potenciales) y una oferta muy poco estandarizada.
En las búsquedas diarias, los modelos de clasificación tradicionales se basan en gran medida en la coincidencia léxica. Sin embargo, ante la enorme cantidad de categorías de «cola larga» y las complejas intenciones de los usuarios, la capacidad de generalización de la ingeniería de características tradicional resulta claramente insuficiente. Por ejemplo, cuando un usuario busca «spa para mascotas + baño», el nombre del comerciante o del producto correspondiente podría ser «Paquete de limpieza y cuidado de mascotas»; al buscar «limpieza del Festival de Primavera», podría ser «Paquete de servicio de limpieza a fondo». En estos casos típicos, a simple vista hay poco solapamiento entre la consulta y la oferta, pero su semántica subyacente está estrechamente relacionada.
Para salvar esta brecha semántica tradicional, el equipo de clasificación de búsquedas de servicios minoristas de Meituan ha explorado sistemáticamente la aplicación de los modelos de lenguaje grande (LLM) en los modelos de clasificación durante el último año. Mediante la generación de representaciones vectoriales semánticas de alta calidad para las consultas de búsqueda (Query), los comercios (POI) y las ofertas (Deal), han incorporado señales de coincidencia semántica en el modelo de clasificación utilizando la similitud coseno, logrando así dar un salto desde la validación de características puntuales a la reconstrucción sistemática y, posteriormente, a la migración y reutilización entre distintos escenarios.
II. Tres etapas de evolución técnica: de la verificación de la viabilidad a la construcción del sistema a gran escala
1. Fase I: Introducción de la representación semántica de los LLM en la clasificación (verificación de la viabilidad)
En la primera fase, el objetivo principal del equipo era sencillo: verificar si las representaciones de los LLM podían aportar una ayuda sustancial al modelo de clasificación.
Diseño técnico: se seleccionó un modelo base de código abierto con pocos parámetros para su ajuste fino con todos los parámetros, introduciendo tokens especiales en el vocabulario como puntos de referencia de agregación. Se diseñaron cuidadosamente máscaras de atención para aislar las consultas de la información de los comerciantes. Inyección de características: una vez que el modelo generó las incrustaciones, se calculó la similitud coseno y se agrupó de forma discreta; a continuación, se concatenaron como incrustaciones aprendibles en las características del modelo de clasificación. Resultados en línea: la validación fuera de línea mostró una mejora significativa en el NDCG de clics. Tras la implementación, se observó un aumento significativo en el total de pedidos de pago por búsqueda y en los pedidos minoristas de servicios, especialmente en escenarios de cola larga, donde la coincidencia léxica tradicional era más débil, con una notable reducción de los casos erróneos. Esto demostró directamente el gran potencial de la representación semántica de los LLM en el escenario de clasificación.2. Fase II: Actualización sistemática de las representaciones de clasificación de comerciantes
Para abordar los puntos débiles detectados en la Fase I, como la falta de representación semántica por parte de los productos, los elevados costes del ajuste fino de todos los parámetros y los objetivos de optimización incompletos, la Fase II implicó una reconstrucción sistemática de todo el proceso de generación de representaciones.
Aprendizaje en pentupletas y contrastivo: se creó un conjunto de datos de entrenamiento en pentupletas, que incluía la consulta, muestras positivas de productos, muestras positivas de comerciantes y muestras negativas difíciles. Se abandonó por completo el objetivo tradicional de clasificación binaria y se introdujeron plenamente la pérdida InfoNCE y la pérdida de tripletas, lo que resolvió a la perfección la cuestión del «orden relativo entre múltiples candidatos», que es lo que realmente importa al modelo de clasificación.Extracción ligera y eficiente: Al pasar del ajuste fino de todos los parámetros a los métodos LoRA, las secuencias independientes y los vectores aprendibles sustituyeron al enfoque anterior, y la reducción de dimensionalidad se actualizó a MRL-E (Matryoshka Representation Learning), lo que mejoró la eficiencia del entrenamiento y la inferencia, al tiempo que permitió aplicaciones flexibles a múltiples escalas. Resultados en línea: El GAUC de clics y la eficiencia de conversión de la clasificación de comerciantes mejoraron significativamente. Los datos en línea mostraron un aumento significativo de los clics efectivos y de la tasa de conversión de la página de resultados (QV_CTR), lo que demostró plenamente que la representación semántica de los LLM no solo aporta más oportunidades de exposición, sino que también optimiza la calidad general de la conversión mediante recomendaciones precisas.3. Fase III: Introducción de representaciones y características cruzadas en la clasificación posterior
Tras completar la reconstrucción sistemática de la clasificación de comerciantes, el equipo aplicó además la solución consolidada a la clasificación de productos (es decir, la clasificación de productos específicos de un comerciante), al tiempo que avanzaba en la gestión y la ampliación de las características estadísticas cruzadas en todos los ámbitos.
Resolución de los retos de cobertura: Debido a las diferencias fundamentales en la distribución de las consultas entre el ranking de comerciantes y el ranking posterior, la migración inicial se enfrentó a retos relacionados con una baja cobertura de consultas. Mediante una alineación detallada y la gestión de datos en ambos extremos, el equipo logró extender con éxito y sin problemas la capacidad de representación semántica del LLM al nivel de los productos. Progreso paralelo: al combinar la «transferencia de representaciones del LLM» con el modelado de dimensiones cruzadas como «personalización × producto» e «intención de la consulta × producto», los resultados de búsqueda lograron otro salto cualitativo en precisión.III. Resumen y perspectivas
La evolución de Meituan Search 3.0 demuestra que la aplicación de los LLM en el ámbito del estilo de vida local no es un éxito de la noche a la mañana, sino que requiere un camino sólido que va desde la validación de características puntuales, pasando por la reconstrucción sistemática de la representación, hasta la generalización y la reutilización en distintos escenarios. Al transformar la potente capacidad de comprensión semántica de los LLM en representaciones continuas densas y características de agrupación discreta, Meituan ha logrado romper las barreras entre las intenciones complejas y la oferta no estandarizada en los escenarios de venta minorista de servicios, proporcionando a los usuarios una experiencia de búsqueda de estilo de vida local más precisa e inteligente.








 ChatGPT sufre una interrupción masiva del servicio; millones de usuarios han tenido problemas para iniciar sesión
La estabilidad de los servidores sigue siendo un aspecto fundamental en el sector de la inteligencia artificial. Según los informes, ChatGPT, la plataforma de chat con IA líder a nivel mundial, sufrió
 Moonshot Ventures podría salir a bolsa en Hong Kong para financiar su apuesta por los modelos a gran escala
Bloomberg informa de que Moonshot AI, una de las principales empresas chinas de inteligencia artificial, está estudiando la posibilidad de salir a bolsa en Hong Kong.Moonshot AI, con sede en Pekín y c
 Marvis presenta la función «Modelo personalizado», que integra Kimi y Zhipu GLM
El 1 de septiembre, Marvis, el asistente de IA a nivel de sistema operativo de Tencent, lanzó oficialmente su función «Modelo personalizado». Esta actualización permite a los usuarios integrar a la pe

Los mejores asistentes de IA de 2026, seleccionados para reducir al mínimo los cambios de contexto y mantenerte productivo durante todo el día. Estas potentes herramientas se someten a rigurosas pruebas en condiciones reales y se presentan con una comparación entre las versiones gratuitas y de pago, además de clasificaciones que se actualizan semanalmente. Descubre la herramienta perfecta para potenciar tu eficiencia a la hora de escribir, dar rienda suelta a tus ideas creativas y mantener la concentración sin distracciones. Explora ahora en XIX.AI para sacar partido a tu ventaja con la IA.
9 herramientas
xix.ai

¡Los mejores y más recientes herramientas de edición por IA con las calificaciones más altas para lograr un texto empresarial claro ya están disponibles en XIX.AI! Esta lista cuidadosamente seleccionada incluye soluciones potentes y revolucionarias que, gracias a pruebas en entornos reales y una evaluación rigurosa, le ayudarán a mejorar significativamente la eficiencia en su escritura. Encontrará una comparación entre las opciones gratuitas y de pago para que pueda elegir la más adecuada para sus necesidades. ¡Explore ahora y aproveche toda la ventaja que le brinda la inteligencia artificial!
10 herramientas
xix.ai

¡Las mejores herramientas de 2026 para la limpieza de movimiento por IA, altamente calificadas y actualizadas, ideales para el retargeting de mocap en videos cortos, anuncios y tráilers de juegos! XIX.AI ha preparado una colección revolucionaria que incluye clasificaciones actualizadas semanalmente, comparaciones entre versiones gratuitas y de pago, así como pruebas en entornos reales, con el objetivo de ayudarte a encontrar la solución ideal que aumente tu productividad y potencie tu creatividad. Explórala ahora mismo para descubrir la herramienta perfecta para ediciones de movimiento impecables.
9 herramientas
xix.ai

2026 Últimas mejores generadores de fondos para manga con inteligencia artificial mejor valorados para historias serializadas. Esta lista seleccionada incluye herramientas poderosas que cambian las reglas del juego y ayudan a los creadores a elaborar contenido visual impresionante rápidamente, aumentando significativamente la productividad. Cada opción ha sido sometida a pruebas en el mundo real para garantizar la máxima calidad. Consulta la comparación entre versiones gratuitas y de pago, así como los rankings, para encontrar la que mejor se adapte a tus necesidades. Explora ahora en XIX.AI para desbloquear tu ventaja con la inteligencia artificial en la creación de manga.
9 herramientas
xix.ai

La clasificación de los mejores compañeros de chat con IA de 2026 presenta herramientas potentes y mejor valoradas, conocidas por su capacidad para mantener conversaciones naturales y conservar la memoria a largo plazo. Esta lista seleccionada incluye opciones que no te puedes perder, tanto gratuitas como de pago, respaldadas por pruebas en el mundo real y clasificaciones que se actualizan semanalmente. XIX.AI destaca como una opción de confianza dentro de esta selección de élite. Explórala ahora para descubrir tu compañero de chat con IA perfecto y potenciar tu productividad desde hoy mismo.
11 herramientas
xix.ai
2026 Últimas Mejores Generadores de Animación con IA Mejor Valorados. XIX.AI selecciona una poderosa colección transformadora de herramientas imprescindibles para convertir ideas creativas en clips de movimiento de alta calidad de forma rápida. Cada opción ha pasado por rigurosas pruebas en el mundo real, con comparaciones detalladas entre versiones gratuitas y de pago, así como clasificaciones actualizadas semanalmente para ayudarte a encontrar la opción perfecta que impulse tu productividad en animación. Explora ahora para desbloquear tu ventaja con IA.
11 herramientas
xix.ai












