


 Дом
HydraDB привлекла 6,5 млн долларов на разработку революционной технологии хранения данных с использованием ИИ
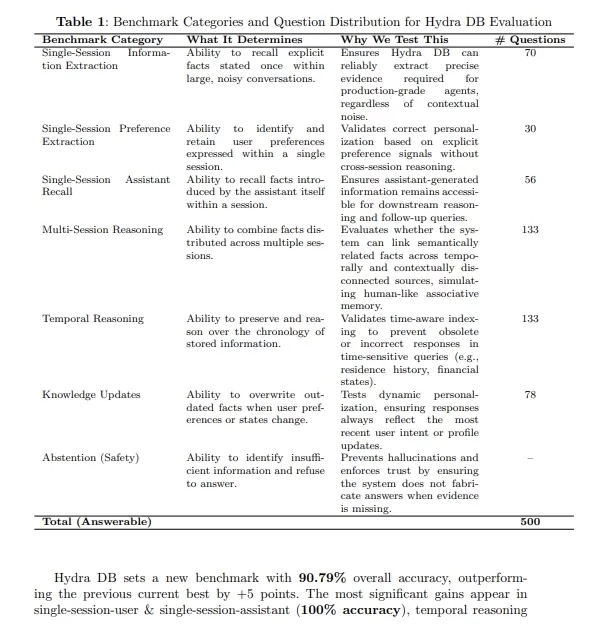
В последнее время в сфере технологий памяти для искусственного интеллекта произошли значительные события, связанные с привлечением финансирования. Компания HydraDB успешно привлекла инвестиции в размере 6,5 миллионов долларов. Проект открыто ставит перед собой цель превзойти традиционные векторные базы данных, предлагая комплексное усовершенствование возможностей долгосрочной памяти ИИ. По сравнению с существующими основными решениями, HydraDB использует инновационную архитектуру, призванную кардинально решить ключевую проблему отрасли: «сходство не равнозначно релевантности».
Критический недостаток векторных баз данных: сходство ≠ релевантность
Преобладающий подход к памяти ИИ предполагает разделение содержания разговора и его хранение в векторных базах данных, а для поиска используется поиск по сходству. Хотя этот метод кажется эффективным, он часто не справляется с задачами в практическом применении.
Реальные примеры демонстрируют эту проблему: при запросе на поиск конкретного контракта ИИ может вернуть идеально отформатированный документ, но принадлежащий совершенно другому клиенту. Хотя поиск по схожести находит «похожий» контент, он упускает ключевую контекстную релевантность, что приводит к значительным неточностям в результатах ИИ.
Революционный подход HydraDB: граф отношений + управление версиями в стиле Git
HydraDB отходит от фрагментированного хранения, вместо этого создавая интеллектуальный граф отношений, который более тесно согласовывает память ИИ с человеческой логикой. Его основная инновация основана на трех ключевых прорывах:
Никаких фрагментов, только связи
Система избегает хранения информации в виде изолированных фрагментов, вместо этого фиксируя отношения между сущностями. Она может точно установить связь между тем, что «вы работаете в компании A» и «вы живете в Нью-Йорке», как часть профиля одного и того же человека, а не рассматривать их как отдельные, не связанные между собой факты.
Обновления только с добавлением, вдохновленные Git
Когда информация о пользователе меняется, HydraDB не просто перезаписывает старые данные. Она использует модель «только добавление», аналогичную системе контроля версий Git. Если пользователь переезжает, его старый адрес сохраняется в истории, а система сохраняет контекст изменения, предотвращая необратимую потерю исторической информации.
Контекстные записи в памяти
Каждая запись в памяти хранится с богатым, интеллектуальным контекстом. Например, если пользователь заявляет: «Мне не нравится этот фреймворк», система интеллектуально контекстуализирует это как «пользователю не нравится React». Это обеспечивает точное понимание в последующих разговорах с ИИ без необходимости ручного уточнения.
Начало революции в области памяти ИИ
Отраслевые наблюдатели отмечают, что инновации HydraDB напрямую решают структурные ограничения векторных баз данных. Они готовы обеспечить трансформационный скачок для ИИ-помощников, личных баз знаний и корпоративных систем RAG. AIbase будет продолжать следить за разработками продуктов и технологическим прогрессом HydraDB — следите за дальнейшими революционными обновлениями.
Ссылка на статью: https://research.hydradb.com/cortex.pdf
Связанная статья
 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех
Рекомендации по связанным специальным темам
письмо
 Инструменты для создания плана статей с использованием ИИ при написании длинных текстов
2026: лучшие и самые популярные инструменты для создания планов статей с помощью ИИ для написания длинных текстов! В эту тщательно подобранную подборку вошли мощные, революционные инструменты, которые генерируют точные и структурированные планы, прошедшие проверку на практике, что позволяет значительно повысить эффективность написания текстов. XIX.AI входит в эту элитную подборку. Получите сравнение бесплатных и платных версий, чтобы выбрать идеальный инструмент. Изучите их прямо сейчас и раскройте свой потенциал с помощью ИИ!
 9 инструментов
 xix.ai
чат-бот
Лучшие приложения для ролевых чатов с ИИ для практики языка, подготовки к собеседованиям и ежедневной разговорной практики
2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты разделения стемов с использованием ИИ для создания ремиксов, подготовки образцов звука и формирования финальных версий караоке.
2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai
Анализ данных
ИИ-копилоты для SQL, предназначенные для создания панелей управления доходами, анализа воронки продаж и отслеживания показателей продуктов.
2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai
Музыкальная композиция
Лучшие инструменты для написания мелодий с помощью ИИ для черновиков песен
2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai
чат-бот
Лучшие инструменты для тренировки разговоров с помощью ИИ для подготовки к собеседованиям
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

 Комментарии (0)
В последнее время в сфере технологий памяти для искусственного интеллекта произошли значительные события, связанные с привлечением финансирования. Компания HydraDB успешно привлекла инвестиции в размере 6,5 миллионов долларов. Проект открыто ставит перед собой цель превзойти традиционные векторные базы данных, предлагая комплексное усовершенствование возможностей долгосрочной памяти ИИ. По сравнению с существующими основными решениями, HydraDB использует инновационную архитектуру, призванную кардинально решить ключевую проблему отрасли: «сходство не равнозначно релевантности».
Критический недостаток векторных баз данных: сходство ≠ релевантность
Преобладающий подход к памяти ИИ предполагает разделение содержания разговора и его хранение в векторных базах данных, а для поиска используется поиск по сходству. Хотя этот метод кажется эффективным, он часто не справляется с задачами в практическом применении.
Реальные примеры демонстрируют эту проблему: при запросе на поиск конкретного контракта ИИ может вернуть идеально отформатированный документ, но принадлежащий совершенно другому клиенту. Хотя поиск по схожести находит «похожий» контент, он упускает ключевую контекстную релевантность, что приводит к значительным неточностям в результатах ИИ.
Революционный подход HydraDB: граф отношений + управление версиями в стиле Git
HydraDB отходит от фрагментированного хранения, вместо этого создавая интеллектуальный граф отношений, который более тесно согласовывает память ИИ с человеческой логикой. Его основная инновация основана на трех ключевых прорывах:
Никаких фрагментов, только связи
Система избегает хранения информации в виде изолированных фрагментов, вместо этого фиксируя отношения между сущностями. Она может точно установить связь между тем, что «вы работаете в компании A» и «вы живете в Нью-Йорке», как часть профиля одного и того же человека, а не рассматривать их как отдельные, не связанные между собой факты.
Обновления только с добавлением, вдохновленные Git
Когда информация о пользователе меняется, HydraDB не просто перезаписывает старые данные. Она использует модель «только добавление», аналогичную системе контроля версий Git. Если пользователь переезжает, его старый адрес сохраняется в истории, а система сохраняет контекст изменения, предотвращая необратимую потерю исторической информации.
Контекстные записи в памяти
Каждая запись в памяти хранится с богатым, интеллектуальным контекстом. Например, если пользователь заявляет: «Мне не нравится этот фреймворк», система интеллектуально контекстуализирует это как «пользователю не нравится React». Это обеспечивает точное понимание в последующих разговорах с ИИ без необходимости ручного уточнения.
Начало революции в области памяти ИИ
Отраслевые наблюдатели отмечают, что инновации HydraDB напрямую решают структурные ограничения векторных баз данных. Они готовы обеспечить трансформационный скачок для ИИ-помощников, личных баз знаний и корпоративных систем RAG. AIbase будет продолжать следить за разработками продуктов и технологическим прогрессом HydraDB — следите за дальнейшими революционными обновлениями.
Ссылка на статью: https://research.hydradb.com/cortex.pdf








 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
 OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех

2026: лучшие и самые популярные инструменты для создания планов статей с помощью ИИ для написания длинных текстов! В эту тщательно подобранную подборку вошли мощные, революционные инструменты, которые генерируют точные и структурированные планы, прошедшие проверку на практике, что позволяет значительно повысить эффективность написания текстов. XIX.AI входит в эту элитную подборку. Получите сравнение бесплатных и платных версий, чтобы выбрать идеальный инструмент. Изучите их прямо сейчас и раскройте свой потенциал с помощью ИИ!
9 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
10 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai

2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai

2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai












