


 Hogar
HydraDB recauda 6,5 millones de dólares para un avance revolucionario en el almacenamiento de memoria para IA
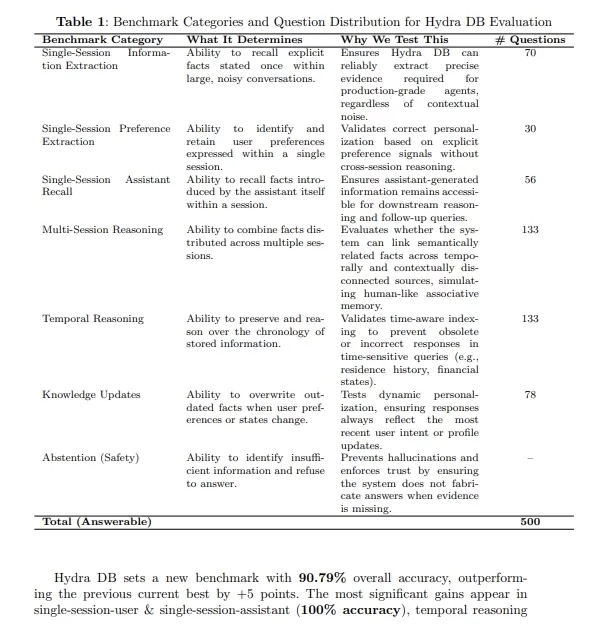
Recientemente, el sector de la tecnología de memoria para IA ha sido protagonista de importantes noticias en materia de financiación. HydraDB ha conseguido con éxito una inversión de 6,5 millones de dólares. El proyecto tiene como objetivo declarado superar a las bases de datos vectoriales tradicionales, ofreciendo una mejora integral de las capacidades de memoria a largo plazo de la IA. En comparación con las soluciones más habituales en la actualidad, HydraDB emplea una arquitectura novedosa diseñada para abordar de forma fundamental el principal reto del sector: «la similitud no equivale a relevancia».
El defecto crítico de las bases de datos vectoriales: similitud ≠ relevancia
El enfoque predominante de la memoria de IA consiste en dividir el contenido de las conversaciones y almacenarlo en bases de datos vectoriales, basándose en la búsqueda por similitud para la recuperación. Aunque este método parece eficiente, a menudo se queda corto en las aplicaciones prácticas.
Los casos del mundo real demuestran el problema: cuando se le pide que recupere un contrato específico, una IA podría devolver un documento perfectamente formateado, pero que pertenece a un cliente completamente diferente. Aunque la búsqueda por similitud encuentra contenido «similar», pasa por alto la relevancia contextual fundamental, lo que da lugar a importantes imprecisiones en los resultados de la IA.
El enfoque revolucionario de HydraDB: gráfico de relaciones + control de versiones al estilo Git
HydraDB se aleja del almacenamiento fragmentado y, en su lugar, construye un gráfico de relaciones inteligente que alinea la memoria de la IA más estrechamente con la lógica humana. Su innovación principal se basa en tres avances clave:
Sin fragmentos, solo relaciones
El sistema evita almacenar la información en fragmentos aislados y, en su lugar, captura las relaciones entre entidades. Es capaz de establecer con precisión que «trabajas en la empresa A» y «vives en Nueva York» forman parte del perfil de la misma persona, en lugar de tratarlas como hechos separados y sin relación entre sí.
Actualizaciones de solo adición, inspiradas en Git
Cuando la información del usuario cambia, HydraDB no se limita a sobrescribir los datos antiguos. Adopta un modelo de solo adición, similar al control de versiones de Git. Si un usuario se muda, su antigua dirección se conserva en el historial, y el sistema retiene el contexto del cambio, evitando la pérdida permanente de información histórica.
Entradas de memoria sensibles al contexto
Cada recuerdo se almacena con un contexto rico e inteligente. Por ejemplo, si un usuario afirma: «No me gusta ese framework», el sistema contextualiza esto de forma inteligente como «al usuario no le gusta React». Esto garantiza una comprensión precisa en las conversaciones posteriores con la IA sin necesidad de aclaraciones manuales.
El amanecer de una revolución en la memoria de la IA
Los observadores del sector señalan que la innovación de HydraDB aborda directamente las limitaciones estructurales de las bases de datos vectoriales. Está llamada a suponer un salto transformador para los asistentes de IA, las bases de conocimiento personales y los sistemas RAG empresariales. AIbase seguirá de cerca los desarrollos de producto y los avances tecnológicos de HydraDB; permanezcan atentos a nuevas actualizaciones revolucionarias.
Enlace al artículo: https://research.hydradb.com/cortex.pdf
Artículo relacionado
 El exinvestigador de OpenAI, Barrett Zoph, regresa a Google para colaborar en el desarrollo de Gemini
Barret Zoph, que anteriormente abandonó de forma repentina la empresa para incorporarse a OpenAI debido a un desacuerdo con la directora general de Thinking Machines Lab, Miriam Mularati, ha vuelto a
Cómo Recursive Intelligence recaudó 335 millones de dólares con una valoración de 4.000 millones de dólares en cuatro meses
Las cofundadoras de la startup Ricursive Intelligence parecían destinadas a ser cofundadoras.Anna Goldie, directora ejecutiva, y Azalia Mirhoseini, directora técnica, son tan conocidas en la comunidad
La carrera por la IA no va a esperar, y tampoco lo hará este descuento del 25 % de TechCrunch Disrupt
Todos los fundadores que están desarrollando proyectos de IA en estos momentos se plantean la misma pregunta: ¿Estamos avanzando lo suficientemente rápido y de forma lo suficientemente eficaz? TechCru
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (0)
0/500
Recientemente, el sector de la tecnología de memoria para IA ha sido protagonista de importantes noticias en materia de financiación. HydraDB ha conseguido con éxito una inversión de 6,5 millones de dólares. El proyecto tiene como objetivo declarado superar a las bases de datos vectoriales tradicionales, ofreciendo una mejora integral de las capacidades de memoria a largo plazo de la IA. En comparación con las soluciones más habituales en la actualidad, HydraDB emplea una arquitectura novedosa diseñada para abordar de forma fundamental el principal reto del sector: «la similitud no equivale a relevancia».
El defecto crítico de las bases de datos vectoriales: similitud ≠ relevancia
El enfoque predominante de la memoria de IA consiste en dividir el contenido de las conversaciones y almacenarlo en bases de datos vectoriales, basándose en la búsqueda por similitud para la recuperación. Aunque este método parece eficiente, a menudo se queda corto en las aplicaciones prácticas.
Los casos del mundo real demuestran el problema: cuando se le pide que recupere un contrato específico, una IA podría devolver un documento perfectamente formateado, pero que pertenece a un cliente completamente diferente. Aunque la búsqueda por similitud encuentra contenido «similar», pasa por alto la relevancia contextual fundamental, lo que da lugar a importantes imprecisiones en los resultados de la IA.
El enfoque revolucionario de HydraDB: gráfico de relaciones + control de versiones al estilo Git
HydraDB se aleja del almacenamiento fragmentado y, en su lugar, construye un gráfico de relaciones inteligente que alinea la memoria de la IA más estrechamente con la lógica humana. Su innovación principal se basa en tres avances clave:
Sin fragmentos, solo relaciones
El sistema evita almacenar la información en fragmentos aislados y, en su lugar, captura las relaciones entre entidades. Es capaz de establecer con precisión que «trabajas en la empresa A» y «vives en Nueva York» forman parte del perfil de la misma persona, en lugar de tratarlas como hechos separados y sin relación entre sí.
Actualizaciones de solo adición, inspiradas en Git
Cuando la información del usuario cambia, HydraDB no se limita a sobrescribir los datos antiguos. Adopta un modelo de solo adición, similar al control de versiones de Git. Si un usuario se muda, su antigua dirección se conserva en el historial, y el sistema retiene el contexto del cambio, evitando la pérdida permanente de información histórica.
Entradas de memoria sensibles al contexto
Cada recuerdo se almacena con un contexto rico e inteligente. Por ejemplo, si un usuario afirma: «No me gusta ese framework», el sistema contextualiza esto de forma inteligente como «al usuario no le gusta React». Esto garantiza una comprensión precisa en las conversaciones posteriores con la IA sin necesidad de aclaraciones manuales.
El amanecer de una revolución en la memoria de la IA
Los observadores del sector señalan que la innovación de HydraDB aborda directamente las limitaciones estructurales de las bases de datos vectoriales. Está llamada a suponer un salto transformador para los asistentes de IA, las bases de conocimiento personales y los sistemas RAG empresariales. AIbase seguirá de cerca los desarrollos de producto y los avances tecnológicos de HydraDB; permanezcan atentos a nuevas actualizaciones revolucionarias.
Enlace al artículo: https://research.hydradb.com/cortex.pdf








 El exinvestigador de OpenAI, Barrett Zoph, regresa a Google para colaborar en el desarrollo de Gemini
Barret Zoph, que anteriormente abandonó de forma repentina la empresa para incorporarse a OpenAI debido a un desacuerdo con la directora general de Thinking Machines Lab, Miriam Mularati, ha vuelto a
 Cómo Recursive Intelligence recaudó 335 millones de dólares con una valoración de 4.000 millones de dólares en cuatro meses
Las cofundadoras de la startup Ricursive Intelligence parecían destinadas a ser cofundadoras.Anna Goldie, directora ejecutiva, y Azalia Mirhoseini, directora técnica, son tan conocidas en la comunidad
 La carrera por la IA no va a esperar, y tampoco lo hará este descuento del 25 % de TechCrunch Disrupt
Todos los fundadores que están desarrollando proyectos de IA en estos momentos se plantean la misma pregunta: ¿Estamos avanzando lo suficientemente rápido y de forma lo suficientemente eficaz? TechCru

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai












