


 Maison
HydraDB lève 6,5 millions de dollars pour une avancée majeure dans le domaine du stockage de mémoire pour l'IA
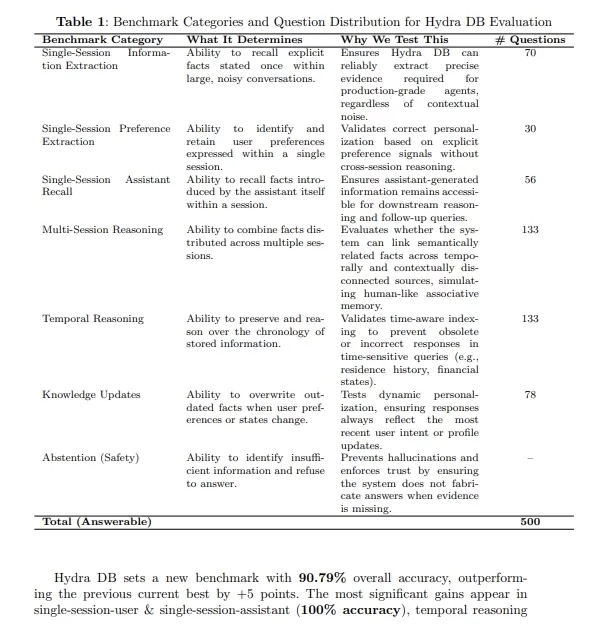
Récemment, le secteur des technologies de mémoire pour l'IA a fait l'objet d'une annonce importante en matière de financement. HydraDB a réussi à lever 6,5 millions de dollars. Le projet affiche ouvertement l'objectif de surpasser les bases de données vectorielles traditionnelles, en proposant une amélioration complète des capacités de mémoire à long terme de l'IA. Par rapport aux solutions courantes actuelles, HydraDB utilise une architecture novatrice conçue pour s'attaquer de manière fondamentale au défi central du secteur : « la similarité n'est pas synonyme de pertinence ».
La faille critique des bases de données vectorielles : similitude ≠ pertinence
L'approche dominante en matière de mémoire IA consiste à segmenter le contenu des conversations et à le stocker dans des bases de données vectorielles, en s'appuyant sur la recherche par similarité pour la récupération. Bien que cette méthode semble efficace, elle s'avère souvent insuffisante dans les applications pratiques.
Des cas concrets illustrent le problème : lorsqu'on lui demande de récupérer un contrat spécifique, une IA peut renvoyer un document parfaitement formaté, mais qui appartient à un client totalement différent. Bien que la recherche par similarité trouve un contenu « similaire », elle passe à côté de la pertinence contextuelle essentielle, ce qui entraîne des inexactitudes significatives dans les résultats de l'IA.
L'approche révolutionnaire d'HydraDB : graphe de relations + gestion des versions de type Git
HydraDB s'éloigne du stockage fragmenté pour construire à la place un graphe de relations intelligent qui aligne plus étroitement la mémoire de l'IA sur la logique humaine. Son innovation principale repose sur trois avancées clés :
Pas de fragments, seulement des relations
Le système évite de stocker les informations sous forme de fragments isolés, mais capture plutôt les relations entre les entités. Il peut établir avec précision le lien entre « vous travaillez dans l’entreprise A » et « vous vivez à New York » comme faisant partie du profil d’une même personne, plutôt que de les traiter comme des faits distincts et sans rapport.
Mises à jour en mode « ajout seul », inspirées de Git
Lorsque les informations d'un utilisateur changent, HydraDB ne se contente pas de remplacer les anciennes données. Il adopte un modèle d'ajout uniquement, similaire au contrôle de version de Git. Si un utilisateur déménage, son ancienne adresse est conservée dans l'historique, et le système garde le contexte du changement, empêchant ainsi la perte définitive des informations historiques.
Entrées de mémoire sensibles au contexte
Chaque souvenir est stocké avec un contexte riche et intelligent. Par exemple, si un utilisateur déclare : « Je n'aime pas ce framework », le système contextualise intelligemment cette déclaration en « l'utilisateur n'aime pas React ». Cela garantit une compréhension précise lors des conversations IA suivantes sans nécessiter de clarification manuelle.
L'aube d'une révolution de la mémoire IA
Les observateurs du secteur notent que l'innovation d'HydraDB s'attaque directement aux limites structurelles des bases de données vectorielles. Elle est sur le point d'apporter un bond en avant transformateur pour les assistants IA, les bases de connaissances personnelles et les systèmes RAG d'entreprise. AIbase continuera à suivre les développements de produits et les progrès technologiques d'HydraDB — restez à l'écoute pour d'autres mises à jour révolutionnaires.
Lien vers l'article : https://research.hydradb.com/cortex.pdf
Article connexe
 Anthropic étend ses outils de codage IA Claude au Japon dans le cadre de sa stratégie de croissance à l’étranger
Anthropic, une entreprise américaine d’intelligence artificielle de premier plan, intensifie sa portée mondiale. Mercredi, l’entreprise a organisé une grande réunion de développeurs, « Code with Claude », à Tokyo, rassemblant près de 500 ingénieurs l
Le géant indien du logiciel réduit ses embauches et promet des licenciements nuls à mesure que les agents IA se développent
Alors que l’intelligence artificielle redéfinit les modèles d’affaires traditionnellement intensifs en main-d’œuvre, Tata Consultancy Services (TCS), l’un des principaux prestataires indiens de sous-traitance logicielle, a dévoilé sa réponse stratégi
La Chine verrouille les modèles d'IA pendant le Gaokao pour bloquer l'aide instantanée aux devoirs
Avec l’approche rapide du Gaokao 2026, les rumeurs concernant la suspension des outils d’intelligence artificielle pendant la période d’examen ont déclenché un intense débat en ligne. En réponse aux préoccupations du public, les principales plateform
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils de transfert de style basés sur l'IA pour des expériences créatives
Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
 9 outils
 xix.ai
Création de bande dessinée
Les meilleurs outils d'IA pour créer des bulles de dialogue destinés à la narration visuelle
Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai
Assistante de réunion
Les meilleurs outils de synthèse de réunions basés sur l'IA : suivez clairement les décisions et les actions à mener
2026 : les meilleurs outils d'IA pour la synthèse de réunions, les mieux notés, pour un suivi clair des décisions et des relances sans effort. Cette sélection présente des solutions puissantes et révolutionnaires qui boostent considérablement la productivité en automatisant la prise de notes lors des réunions, en identifiant les actions clés et en rationalisant la coordination des équipes sur l'ensemble des projets. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai
Analyse des données
Meilleurs outils de nettoyage de données IA : corrigez rapidement les valeurs manquantes et les doublons
2026 : Les meilleures outils de nettoyage de données IA les plus récents et hautement notés pour corriger rapidement les valeurs manquantes et les doublons. Cette liste rigoureusement sélectionnée met en avant des solutions puissantes capables d’améliorer considérablement la productivité. Chaque outil a été soumis à des tests approfondis dans des conditions réelles afin de garantir sa fiabilité. Obtenez une comparaison gratuite et payante pour découvrir l’outil qu’il vous faut le mieux, adapté à vos besoins. Explorez dès maintenant XIX.AI pour tirer parti au maximum des capacités de l’IA.
11 outils
xix.ai
Conception et art
Meilleurs outils d’idéation créative par IA pour les artistes : surmonter les blocages visuels
2026 Derniers Meilleurs Outils d’Idéation Créative par IA les Mieux Notés pour les Artistes sont sélectionnés par XIX.AI pour aider les créateurs à surmonner les blocages visuels et stimuler instantanément leur créativité. Ces outils puissants et révolutionnaires offrent des tests concrets, une comparaison détaillée entre les versions gratuites et payantes, ainsi que des classements mis à jour chaque semaine. Découvrez l’outil parfait pour accélérer la création de contenu et débloquer votre avantage IA dès aujourd’hui. Explorez maintenant !
14 outils
xix.ai
Composition musicale
Créateurs de musique par IA pour les pistes d'accompagnement TikTok, les fichiers audio Reels et la musique promotionnelle des créateurs
Les meilleurs générateurs de rythmes IA de 2026 pour les musiques de fond TikTok, les Reels et les morceaux promotionnels des créateurs ! XIX.AI a sélectionné une liste des outils les mieux notés, véritables révolutionnaires qui ont fait leurs preuves dans la pratique pour offrir une musique irréprochable, quel que soit votre besoin en matière de contenu. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, des classements mis à jour chaque semaine, ainsi que des options incontournables pour vous aider à stimuler votre créativité et votre productivité. Explorez-la dès maintenant pour découvrir l'outil qui vous convient le mieux !
11 outils
xix.ai

 commentaires (0)
Récemment, le secteur des technologies de mémoire pour l'IA a fait l'objet d'une annonce importante en matière de financement. HydraDB a réussi à lever 6,5 millions de dollars. Le projet affiche ouvertement l'objectif de surpasser les bases de données vectorielles traditionnelles, en proposant une amélioration complète des capacités de mémoire à long terme de l'IA. Par rapport aux solutions courantes actuelles, HydraDB utilise une architecture novatrice conçue pour s'attaquer de manière fondamentale au défi central du secteur : « la similarité n'est pas synonyme de pertinence ».
La faille critique des bases de données vectorielles : similitude ≠ pertinence
L'approche dominante en matière de mémoire IA consiste à segmenter le contenu des conversations et à le stocker dans des bases de données vectorielles, en s'appuyant sur la recherche par similarité pour la récupération. Bien que cette méthode semble efficace, elle s'avère souvent insuffisante dans les applications pratiques.
Des cas concrets illustrent le problème : lorsqu'on lui demande de récupérer un contrat spécifique, une IA peut renvoyer un document parfaitement formaté, mais qui appartient à un client totalement différent. Bien que la recherche par similarité trouve un contenu « similaire », elle passe à côté de la pertinence contextuelle essentielle, ce qui entraîne des inexactitudes significatives dans les résultats de l'IA.
L'approche révolutionnaire d'HydraDB : graphe de relations + gestion des versions de type Git
HydraDB s'éloigne du stockage fragmenté pour construire à la place un graphe de relations intelligent qui aligne plus étroitement la mémoire de l'IA sur la logique humaine. Son innovation principale repose sur trois avancées clés :
Pas de fragments, seulement des relations
Le système évite de stocker les informations sous forme de fragments isolés, mais capture plutôt les relations entre les entités. Il peut établir avec précision le lien entre « vous travaillez dans l’entreprise A » et « vous vivez à New York » comme faisant partie du profil d’une même personne, plutôt que de les traiter comme des faits distincts et sans rapport.
Mises à jour en mode « ajout seul », inspirées de Git
Lorsque les informations d'un utilisateur changent, HydraDB ne se contente pas de remplacer les anciennes données. Il adopte un modèle d'ajout uniquement, similaire au contrôle de version de Git. Si un utilisateur déménage, son ancienne adresse est conservée dans l'historique, et le système garde le contexte du changement, empêchant ainsi la perte définitive des informations historiques.
Entrées de mémoire sensibles au contexte
Chaque souvenir est stocké avec un contexte riche et intelligent. Par exemple, si un utilisateur déclare : « Je n'aime pas ce framework », le système contextualise intelligemment cette déclaration en « l'utilisateur n'aime pas React ». Cela garantit une compréhension précise lors des conversations IA suivantes sans nécessiter de clarification manuelle.
L'aube d'une révolution de la mémoire IA
Les observateurs du secteur notent que l'innovation d'HydraDB s'attaque directement aux limites structurelles des bases de données vectorielles. Elle est sur le point d'apporter un bond en avant transformateur pour les assistants IA, les bases de connaissances personnelles et les systèmes RAG d'entreprise. AIbase continuera à suivre les développements de produits et les progrès technologiques d'HydraDB — restez à l'écoute pour d'autres mises à jour révolutionnaires.
Lien vers l'article : https://research.hydradb.com/cortex.pdf








 Anthropic étend ses outils de codage IA Claude au Japon dans le cadre de sa stratégie de croissance à l’étranger
Anthropic, une entreprise américaine d’intelligence artificielle de premier plan, intensifie sa portée mondiale. Mercredi, l’entreprise a organisé une grande réunion de développeurs, « Code with Claude », à Tokyo, rassemblant près de 500 ingénieurs l
 Le géant indien du logiciel réduit ses embauches et promet des licenciements nuls à mesure que les agents IA se développent
Alors que l’intelligence artificielle redéfinit les modèles d’affaires traditionnellement intensifs en main-d’œuvre, Tata Consultancy Services (TCS), l’un des principaux prestataires indiens de sous-traitance logicielle, a dévoilé sa réponse stratégi
 La Chine verrouille les modèles d'IA pendant le Gaokao pour bloquer l'aide instantanée aux devoirs
Avec l’approche rapide du Gaokao 2026, les rumeurs concernant la suspension des outils d’intelligence artificielle pendant la période d’examen ont déclenché un intense débat en ligne. En réponse aux préoccupations du public, les principales plateform

Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai

Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai

2026 : les meilleurs outils d'IA pour la synthèse de réunions, les mieux notés, pour un suivi clair des décisions et des relances sans effort. Cette sélection présente des solutions puissantes et révolutionnaires qui boostent considérablement la productivité en automatisant la prise de notes lors des réunions, en identifiant les actions clés et en rationalisant la coordination des équipes sur l'ensemble des projets. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai

2026 : Les meilleures outils de nettoyage de données IA les plus récents et hautement notés pour corriger rapidement les valeurs manquantes et les doublons. Cette liste rigoureusement sélectionnée met en avant des solutions puissantes capables d’améliorer considérablement la productivité. Chaque outil a été soumis à des tests approfondis dans des conditions réelles afin de garantir sa fiabilité. Obtenez une comparaison gratuite et payante pour découvrir l’outil qu’il vous faut le mieux, adapté à vos besoins. Explorez dès maintenant XIX.AI pour tirer parti au maximum des capacités de l’IA.
11 outils
xix.ai

2026 Derniers Meilleurs Outils d’Idéation Créative par IA les Mieux Notés pour les Artistes sont sélectionnés par XIX.AI pour aider les créateurs à surmonner les blocages visuels et stimuler instantanément leur créativité. Ces outils puissants et révolutionnaires offrent des tests concrets, une comparaison détaillée entre les versions gratuites et payantes, ainsi que des classements mis à jour chaque semaine. Découvrez l’outil parfait pour accélérer la création de contenu et débloquer votre avantage IA dès aujourd’hui. Explorez maintenant !
14 outils
xix.ai

Les meilleurs générateurs de rythmes IA de 2026 pour les musiques de fond TikTok, les Reels et les morceaux promotionnels des créateurs ! XIX.AI a sélectionné une liste des outils les mieux notés, véritables révolutionnaires qui ont fait leurs preuves dans la pratique pour offrir une musique irréprochable, quel que soit votre besoin en matière de contenu. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, des classements mis à jour chaque semaine, ainsi que des options incontournables pour vous aider à stimuler votre créativité et votre productivité. Explorez-la dès maintenant pour découvrir l'outil qui vous convient le mieux !
11 outils
xix.ai












