


 Дом
CVPR 2026 сигнализирует о смене парадигмы в области визуального интеллекта на фоне исчезновения эффекта предельных выгод
За последнее десятилетие компьютерное зрение прошло путь от классификации на ImageNet до диффузионных моделей, направленных на то, чтобы машины могли «видеть мир». Однако по мере того, как способности восприятия приближаются к человеческому уровню, эффективность чистого повышения точности снижается. На конференции CVPR 2026 направление исследований в области визуального интеллекта изменилось: зрение больше не является конечной целью, а служит мостом для рассуждений, принятия решений и взаимодействия.
Выход за пределы «слепого рассуждения»: адаптивные и имплицитные подходы
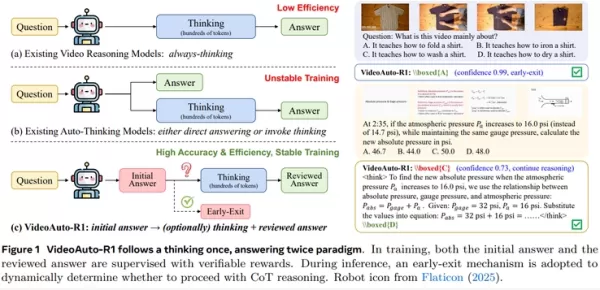
Мультимодальные модели долгое время полагались на «цепочку мыслей» (CoT) для логического рассуждения. Однако недавние исследования показывают, что такое постоянное рассуждение зачастую неэффективно. Фреймворк VideoAuto-R1 вводит «вывод по запросу»: он напрямую отвечает на простые перцептивные запросы и запускает процесс вывода только в случае сложной логики. Этот метод позволяет сохранить максимальную производительность, сократив при этом среднюю длину вывода в 3,3 раза.
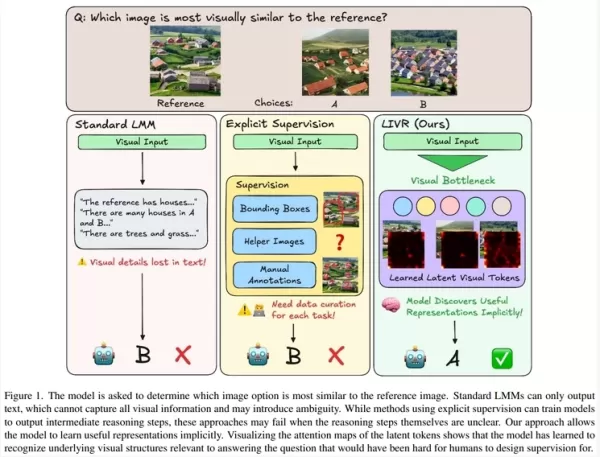
Средство рассуждений также эволюционирует. Ранее модели полагались на язык для описания пространственных отношений, что не работало в случае головоломок или геометрических структур. Новая тенденция заключается в неявных визуальных рассуждениях в «латентном пространстве», обходя линейное преобразование текста, чтобы лучше улавливать сложные визуальные структуры.
Переосмысление оценки: развенчание иллюзии тестов с множественным выбором
Текущие оценки моделей «визуальный язык» в значительной степени опираются на вопросы с несколькими вариантами ответов (MCQA), что может приводить к завышению оценки их возможностей. Исследования показывают, что модели часто «обманывают», используя метод исключения или предвзятость к определенным вариантам ответов, завышая результаты примерно на 20 баллов. Чтобы исправить это, отрасль переходит к «проверяемым открытым вопросам и ответам», что заставляет модели по-настоящему понимать визуальный контент, а не использовать подсказки, содержащиеся в вариантах ответов.
Между тем сценарии оценки смещаются от статических изображений с одним агентом к многоагентным средам. Тестовые наборы, такие как VS-Bench, требуют от моделей не только понимания окружающей среды, но и демонстрации стратегического мышления и принятия решений в сложных взаимодействиях, таких как сотрудничество и конкуренция. Это знаменует переход визуального интеллекта от пассивного «понимающего» к активному «принимающему решения».
Модернизация инфраструктуры: модели с открытым исходным кодом и реальные данные
Сообщество открытого исходного кода повышает прозрачность. Такие модели, как Molmo2, публикуют не только веса, но и полные наборы данных, а также процессы обучения. Эти модели расширяют возможности от отдельных изображений до видео, добавляя функции точной локализации и совершая скачок от «понимания» к «указанию местоположений».
Этот прогресс подкрепляется комплексной инфраструктурой данных. Для редактирования изображений на основе текста крупномасштабные наборы данных из реального мира, такие как Pico-Banana-400K, устраняют пробел, вызванный чрезмерной зависимостью от синтетических данных. Поддерживая многоэтапное редактирование и согласование предпочтений, этот набор данных обеспечивает прочную основу для обучения моделей редактирования с улучшенным здравым смыслом и логикой.
Подводя итог, можно сказать, что визуальный интеллект эволюционирует от простого восприятия к интегрированному интеллекту, сочетающему восприятие, познание и действие. Этот сдвиг представляет собой не просто незначительное повышение производительности; это систематическая реконструкция механизмов рассуждений, парадигм оценки и цепочек поставки данных.
Связанная статья
 Meta удаляет функцию редактирования фотографий с помощью ИИ после негативной реакции пользователей
Meta, гигант социальных сетей, вновь оказалась в центре публичной дискуссии о хрупком балансе между искусственным интеллектом и конфиденциальностью пользователей. Согласно TechCrunch, подразделение Meta Superintelligence Labs представило новый генера
Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Рекомендации по связанным специальным темам
Создание видео
 Генераторы привлекательных заглавий для коротких видеороликов с использованием ИИ: для Reels, Shorts и кампаний по запуску продуктов
2026: лучшие современные генераторы захватывающих заставок для короткометражных видео на базе ИИ для Reels, Shorts и кампаний по запуску продуктов! XIX.AI подбирает самые высокооцененные и мощные инструменты, способные кардинально изменить ситуацию, которые в ходе реальных тестов демонстрируют результаты, которые обязательно стоит попробовать. Эта страница, обновляемая еженедельно, предлагает сравнительные рейтинги бесплатных и платных инструментов, чтобы помочь вам найти идеальное решение для повышения креативности и продуктивности при создании контента. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть свой потенциал с помощью ИИ!
 11 инструментов
 xix.ai
письмо
Инструменты для создания плана статей с использованием ИИ при написании длинных текстов
2026: лучшие и самые популярные инструменты для создания планов статей с помощью ИИ для написания длинных текстов! В эту тщательно подобранную подборку вошли мощные, революционные инструменты, которые генерируют точные и структурированные планы, прошедшие проверку на практике, что позволяет значительно повысить эффективность написания текстов. XIX.AI входит в эту элитную подборку. Получите сравнение бесплатных и платных версий, чтобы выбрать идеальный инструмент. Изучите их прямо сейчас и раскройте свой потенциал с помощью ИИ!
9 инструментов
xix.ai
чат-бот
Лучшие приложения для ролевых чатов с ИИ для практики языка, подготовки к собеседованиям и ежедневной разговорной практики
2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты разделения стемов с использованием ИИ для создания ремиксов, подготовки образцов звука и формирования финальных версий караоке.
2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai
Анализ данных
ИИ-копилоты для SQL, предназначенные для создания панелей управления доходами, анализа воронки продаж и отслеживания показателей продуктов.
2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai
Музыкальная композиция
Лучшие инструменты для написания мелодий с помощью ИИ для черновиков песен
2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

 Комментарии (0)
За последнее десятилетие компьютерное зрение прошло путь от классификации на ImageNet до диффузионных моделей, направленных на то, чтобы машины могли «видеть мир». Однако по мере того, как способности восприятия приближаются к человеческому уровню, эффективность чистого повышения точности снижается. На конференции CVPR 2026 направление исследований в области визуального интеллекта изменилось: зрение больше не является конечной целью, а служит мостом для рассуждений, принятия решений и взаимодействия.
Выход за пределы «слепого рассуждения»: адаптивные и имплицитные подходы
Мультимодальные модели долгое время полагались на «цепочку мыслей» (CoT) для логического рассуждения. Однако недавние исследования показывают, что такое постоянное рассуждение зачастую неэффективно. Фреймворк VideoAuto-R1 вводит «вывод по запросу»: он напрямую отвечает на простые перцептивные запросы и запускает процесс вывода только в случае сложной логики. Этот метод позволяет сохранить максимальную производительность, сократив при этом среднюю длину вывода в 3,3 раза.
Средство рассуждений также эволюционирует. Ранее модели полагались на язык для описания пространственных отношений, что не работало в случае головоломок или геометрических структур. Новая тенденция заключается в неявных визуальных рассуждениях в «латентном пространстве», обходя линейное преобразование текста, чтобы лучше улавливать сложные визуальные структуры.
Переосмысление оценки: развенчание иллюзии тестов с множественным выбором
Текущие оценки моделей «визуальный язык» в значительной степени опираются на вопросы с несколькими вариантами ответов (MCQA), что может приводить к завышению оценки их возможностей. Исследования показывают, что модели часто «обманывают», используя метод исключения или предвзятость к определенным вариантам ответов, завышая результаты примерно на 20 баллов. Чтобы исправить это, отрасль переходит к «проверяемым открытым вопросам и ответам», что заставляет модели по-настоящему понимать визуальный контент, а не использовать подсказки, содержащиеся в вариантах ответов.
Между тем сценарии оценки смещаются от статических изображений с одним агентом к многоагентным средам. Тестовые наборы, такие как VS-Bench, требуют от моделей не только понимания окружающей среды, но и демонстрации стратегического мышления и принятия решений в сложных взаимодействиях, таких как сотрудничество и конкуренция. Это знаменует переход визуального интеллекта от пассивного «понимающего» к активному «принимающему решения».
Модернизация инфраструктуры: модели с открытым исходным кодом и реальные данные
Сообщество открытого исходного кода повышает прозрачность. Такие модели, как Molmo2, публикуют не только веса, но и полные наборы данных, а также процессы обучения. Эти модели расширяют возможности от отдельных изображений до видео, добавляя функции точной локализации и совершая скачок от «понимания» к «указанию местоположений».
Этот прогресс подкрепляется комплексной инфраструктурой данных. Для редактирования изображений на основе текста крупномасштабные наборы данных из реального мира, такие как Pico-Banana-400K, устраняют пробел, вызванный чрезмерной зависимостью от синтетических данных. Поддерживая многоэтапное редактирование и согласование предпочтений, этот набор данных обеспечивает прочную основу для обучения моделей редактирования с улучшенным здравым смыслом и логикой.
Подводя итог, можно сказать, что визуальный интеллект эволюционирует от простого восприятия к интегрированному интеллекту, сочетающему восприятие, познание и действие. Этот сдвиг представляет собой не просто незначительное повышение производительности; это систематическая реконструкция механизмов рассуждений, парадигм оценки и цепочек поставки данных.








 Meta удаляет функцию редактирования фотографий с помощью ИИ после негативной реакции пользователей
Meta, гигант социальных сетей, вновь оказалась в центре публичной дискуссии о хрупком балансе между искусственным интеллектом и конфиденциальностью пользователей. Согласно TechCrunch, подразделение Meta Superintelligence Labs представило новый генера
 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
 OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства

2026: лучшие современные генераторы захватывающих заставок для короткометражных видео на базе ИИ для Reels, Shorts и кампаний по запуску продуктов! XIX.AI подбирает самые высокооцененные и мощные инструменты, способные кардинально изменить ситуацию, которые в ходе реальных тестов демонстрируют результаты, которые обязательно стоит попробовать. Эта страница, обновляемая еженедельно, предлагает сравнительные рейтинги бесплатных и платных инструментов, чтобы помочь вам найти идеальное решение для повышения креативности и продуктивности при создании контента. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть свой потенциал с помощью ИИ!
11 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для создания планов статей с помощью ИИ для написания длинных текстов! В эту тщательно подобранную подборку вошли мощные, революционные инструменты, которые генерируют точные и структурированные планы, прошедшие проверку на практике, что позволяет значительно повысить эффективность написания текстов. XIX.AI входит в эту элитную подборку. Получите сравнение бесплатных и платных версий, чтобы выбрать идеальный инструмент. Изучите их прямо сейчас и раскройте свой потенциал с помощью ИИ!
9 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
10 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai

2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai

2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai












