


 Hogar
CVPR 2026 marca un cambio de paradigma en la inteligencia visual a medida que las mejoras marginales pierden importancia
A lo largo de la última década, la visión artificial ha evolucionado desde la clasificación de ImageNet hasta los modelos de difusión, con el objetivo de permitir que las máquinas «vean el mundo». Sin embargo, a medida que las capacidades perceptivas se acercan a los niveles humanos, los beneficios derivados de las mejoras puras en la precisión se están desvaneciendo. En CVPR 2026, la investigación en inteligencia visual ha dado un giro: la visión ya no es el objetivo final, sino un puente hacia el razonamiento, la toma de decisiones y la interacción.
Más allá del «razonamiento ciego»: enfoques adaptativos e implícitos
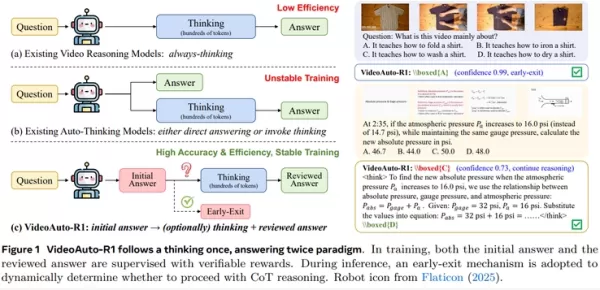
Los modelos multimodales se han basado durante mucho tiempo en la «cadena de pensamiento» (CoT) para el razonamiento lógico. Sin embargo, hallazgos recientes sugieren que este razonamiento constante suele ser ineficaz. El marco VideoAuto-R1 introduce el «razonamiento bajo demanda»: responde directamente a consultas perceptivas sencillas y activa el razonamiento solo para la lógica compleja. Este método mantiene un rendimiento óptimo al tiempo que reduce la longitud media de la salida en un factor de 3,3.
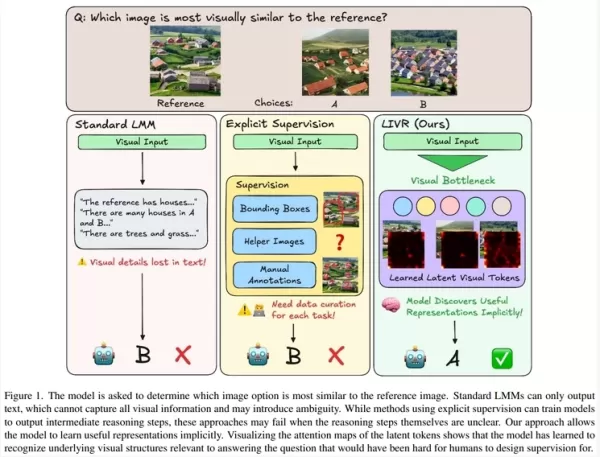
El medio de razonamiento también está evolucionando. Anteriormente, los modelos dependían del lenguaje para describir relaciones espaciales, lo que fallaba con rompecabezas o estructuras geométricas. La nueva tendencia implica el razonamiento visual implícito dentro del «espacio latente», eludiendo la conversión lineal de texto para captar mejor las estructuras visuales complejas.
Reconsiderar la evaluación: romper la ilusión de las preguntas de opción múltiple
Las evaluaciones actuales de los modelos de lenguaje visual se basan en gran medida en preguntas de opción múltiple (MCQA), lo que podría llevar a sobreestimar sus capacidades. Las investigaciones indican que los modelos suelen «hacer trampa» mediante la eliminación o el sesgo de las opciones, lo que infla las puntuaciones en unos 20 puntos. Para solucionar esto, el sector está adoptando las «preguntas y respuestas abiertas verificables», que obligan a los modelos a comprender realmente el contenido visual en lugar de aprovechar las pistas de las opciones.
Mientras tanto, los escenarios de evaluación están pasando de imágenes estáticas con un único agente a entornos con múltiples agentes. Los bancos de pruebas como VS-Bench exigen que los modelos no solo comprendan el entorno, sino que también demuestren razonamiento estratégico y toma de decisiones en interacciones complejas, como la colaboración y la competencia. Esto marca la transición de la inteligencia visual de un «comprendedor» pasivo a un «tomador de decisiones» activo.
Mejoras en la infraestructura: modelos de código abierto y datos del mundo real
La comunidad de código abierto está aumentando la transparencia. Modelos como Molmo2 publican no solo los pesos, sino también los datos completos y los procesos de entrenamiento. Estos modelos amplían las capacidades, pasando de imágenes individuales a vídeos, añadiendo características de localización precisas y logrando un salto de la «comprensión» a la «indicación de ubicaciones».
Este progreso está respaldado por una infraestructura de datos exhaustiva. Para la edición de imágenes basada en texto, los conjuntos de datos del mundo real a gran escala, como Pico-Banana-400K, subsanan la brecha causada por la dependencia excesiva de los datos sintéticos. Al permitir la edición en múltiples pasos y la alineación de preferencias, este conjunto de datos proporciona una base sólida para entrenar modelos de edición con un mayor sentido común y lógica.
En resumen, la inteligencia visual está evolucionando desde la percepción aislada hacia una inteligencia integrada que combina percepción, cognición y acción. Este cambio representa algo más que pequeñas mejoras en el rendimiento; se trata de una reconstrucción sistemática de los mecanismos de razonamiento, los paradigmas de evaluación y las cadenas de suministro de datos.
Artículo relacionado
 CEO de DeepMind, Hassabis: Duermo seis horas al día y generalmente me siento con energía alrededor de la 1 a. m.
Fortune ha presentado recientemente una entrevista con Demis Hassabis, director ejecutivo de Google DeepMind, en la que revela su enfoque poco convencional para el descanso y la productividad. Hassabis ha revelado que duerme muy poco, estructurando s
OpenAI y Anthropic compiten por la cuota de mercado a pesar de la caída de los ingresos
A pesar de los recientes informes que sugieren que OpenAI no ha alcanzado sus objetivos de ingresos —lo que ha generado presión sobre las acciones tecnológicas este martes—, los inversores privados en
Cumplimiento de la normativa sobre vehículos autónomos en California: una nueva era de multas, geovallas y 1 millón de millas
Guident opera un servicio de transporte de AuveTech en el sur de Florida, gestionando una ruta de cuatro millas en West Palm Beach y otra de una milla en Boca Ratón mediante su tecnología de monitoriz
Recomendaciones de temas especiales relacionados
Creación de vídeos
 Generadores de ganchos para vídeos cortos basados en IA, para Reels, Shorts y campañas de lanzamiento de productos
¡Los mejores generadores de ganchos para vídeos cortos con IA de 2026 para Reels, Shorts y campañas de lanzamiento de productos! XIX.AI selecciona las herramientas más valoradas, potentes y revolucionarias que ofrecen resultados que no te puedes perder, contrastados mediante pruebas en el mundo real. Esta página, que se actualiza semanalmente, ofrece clasificaciones comparativas entre opciones gratuitas y de pago para ayudarte a encontrar la solución perfecta con la que potenciar la creatividad y la productividad en la creación de contenidos. ¡Explórala ahora y descubre tu ventaja con la IA!
 11 herramientas
 xix.ai
escribiendo
Herramientas de IA para la estructura de artículos en la redacción de textos extensos
¡Las mejores herramientas de 2026 para crear esquemas de artículos con IA, mejor valoradas para la redacción de textos largos! Esta selección incluye potentes herramientas revolucionarias que ofrecen esquemas precisos y estructurados, probados en la práctica, para aumentar significativamente la eficiencia en la redacción. XIX.AI forma parte de esta selección de élite. Consigue una comparación entre las versiones gratuitas y de pago que te ayudará a elegir la herramienta perfecta. ¡Explora ahora y aprovecha tu ventaja con la IA!
9 herramientas
xix.ai
chatbot
Las mejores aplicaciones de chat de roleplay con IA para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria
¡Las mejores aplicaciones de chat de roleplay con IA de 2026, mejor valoradas, para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria! XIX.AI selecciona una poderosa colección revolucionaria que ofrece comparaciones entre versiones gratuitas y de pago, pruebas del mundo real y clasificaciones actualizadas semanalmente. Estas herramientas imprescindibles te ayudan a mejorar tus habilidades de escritura, superar los desafíos de fluidez y aumentar la eficiencia comunicativa en todas las situaciones cotidianas. ¡Explora ahora para descubrir tu herramienta perfecta para el crecimiento lingüístico!
10 herramientas
xix.ai
composicion musical
Herramientas de separación de pistas con IA para la producción de remezclas, la preparación de samples y las pistas maestras de karaoke
Las mejores herramientas de separación de pistas con IA de 2026, seleccionadas para la producción de remixes, la preparación de samples y la creación de temas de karaoke. Estas potentes herramientas revolucionarias se han sometido a pruebas en condiciones reales para ofrecer un aislamiento de audio preciso, lo que aumenta significativamente la productividad. XIX.AI ofrece una guía comparativa entre versiones gratuitas y de pago, actualizada semanalmente, para ayudarte a encontrar la solución imprescindible que mejor se adapte a tus necesidades. Explórala ahora para sacar el máximo partido a la IA.
8 herramientas
xix.ai
Análisis de datos
Copilotos de AI para SQL destinados a paneles de ingresos, análisis de embudos y métricas de productos
¡Los mejores copilotos de SQL basados en IA de 2026, clasificados entre los más destacados! XIX.AI reúne una poderosa colección que evoluciona constantemente, con pruebas en el mundo real actualizadas semanalmente. Estas herramientas indispensables le permiten generar paneles de control de ingresos precisos, analizar los canales de venta y seguir de cerca las métricas de los productos de manera rápida, lo que aumenta significativamente su productividad. ¡Explórelas ahora para encontrar la herramienta perfecta para tomar decisiones basadas en datos! 238 caracteres
9 herramientas
xix.ai
composicion musical
Mejores herramientas de IA para escribir melodías en borradores de canciones
2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai

 comentario (0)
0/500
A lo largo de la última década, la visión artificial ha evolucionado desde la clasificación de ImageNet hasta los modelos de difusión, con el objetivo de permitir que las máquinas «vean el mundo». Sin embargo, a medida que las capacidades perceptivas se acercan a los niveles humanos, los beneficios derivados de las mejoras puras en la precisión se están desvaneciendo. En CVPR 2026, la investigación en inteligencia visual ha dado un giro: la visión ya no es el objetivo final, sino un puente hacia el razonamiento, la toma de decisiones y la interacción.
Más allá del «razonamiento ciego»: enfoques adaptativos e implícitos
Los modelos multimodales se han basado durante mucho tiempo en la «cadena de pensamiento» (CoT) para el razonamiento lógico. Sin embargo, hallazgos recientes sugieren que este razonamiento constante suele ser ineficaz. El marco VideoAuto-R1 introduce el «razonamiento bajo demanda»: responde directamente a consultas perceptivas sencillas y activa el razonamiento solo para la lógica compleja. Este método mantiene un rendimiento óptimo al tiempo que reduce la longitud media de la salida en un factor de 3,3.
El medio de razonamiento también está evolucionando. Anteriormente, los modelos dependían del lenguaje para describir relaciones espaciales, lo que fallaba con rompecabezas o estructuras geométricas. La nueva tendencia implica el razonamiento visual implícito dentro del «espacio latente», eludiendo la conversión lineal de texto para captar mejor las estructuras visuales complejas.
Reconsiderar la evaluación: romper la ilusión de las preguntas de opción múltiple
Las evaluaciones actuales de los modelos de lenguaje visual se basan en gran medida en preguntas de opción múltiple (MCQA), lo que podría llevar a sobreestimar sus capacidades. Las investigaciones indican que los modelos suelen «hacer trampa» mediante la eliminación o el sesgo de las opciones, lo que infla las puntuaciones en unos 20 puntos. Para solucionar esto, el sector está adoptando las «preguntas y respuestas abiertas verificables», que obligan a los modelos a comprender realmente el contenido visual en lugar de aprovechar las pistas de las opciones.
Mientras tanto, los escenarios de evaluación están pasando de imágenes estáticas con un único agente a entornos con múltiples agentes. Los bancos de pruebas como VS-Bench exigen que los modelos no solo comprendan el entorno, sino que también demuestren razonamiento estratégico y toma de decisiones en interacciones complejas, como la colaboración y la competencia. Esto marca la transición de la inteligencia visual de un «comprendedor» pasivo a un «tomador de decisiones» activo.
Mejoras en la infraestructura: modelos de código abierto y datos del mundo real
La comunidad de código abierto está aumentando la transparencia. Modelos como Molmo2 publican no solo los pesos, sino también los datos completos y los procesos de entrenamiento. Estos modelos amplían las capacidades, pasando de imágenes individuales a vídeos, añadiendo características de localización precisas y logrando un salto de la «comprensión» a la «indicación de ubicaciones».
Este progreso está respaldado por una infraestructura de datos exhaustiva. Para la edición de imágenes basada en texto, los conjuntos de datos del mundo real a gran escala, como Pico-Banana-400K, subsanan la brecha causada por la dependencia excesiva de los datos sintéticos. Al permitir la edición en múltiples pasos y la alineación de preferencias, este conjunto de datos proporciona una base sólida para entrenar modelos de edición con un mayor sentido común y lógica.
En resumen, la inteligencia visual está evolucionando desde la percepción aislada hacia una inteligencia integrada que combina percepción, cognición y acción. Este cambio representa algo más que pequeñas mejoras en el rendimiento; se trata de una reconstrucción sistemática de los mecanismos de razonamiento, los paradigmas de evaluación y las cadenas de suministro de datos.








 CEO de DeepMind, Hassabis: Duermo seis horas al día y generalmente me siento con energía alrededor de la 1 a. m.
Fortune ha presentado recientemente una entrevista con Demis Hassabis, director ejecutivo de Google DeepMind, en la que revela su enfoque poco convencional para el descanso y la productividad. Hassabis ha revelado que duerme muy poco, estructurando s
 OpenAI y Anthropic compiten por la cuota de mercado a pesar de la caída de los ingresos
A pesar de los recientes informes que sugieren que OpenAI no ha alcanzado sus objetivos de ingresos —lo que ha generado presión sobre las acciones tecnológicas este martes—, los inversores privados en
Cumplimiento de la normativa sobre vehículos autónomos en California: una nueva era de multas, geovallas y 1 millón de millas
Guident opera un servicio de transporte de AuveTech en el sur de Florida, gestionando una ruta de cuatro millas en West Palm Beach y otra de una milla en Boca Ratón mediante su tecnología de monitoriz

¡Los mejores generadores de ganchos para vídeos cortos con IA de 2026 para Reels, Shorts y campañas de lanzamiento de productos! XIX.AI selecciona las herramientas más valoradas, potentes y revolucionarias que ofrecen resultados que no te puedes perder, contrastados mediante pruebas en el mundo real. Esta página, que se actualiza semanalmente, ofrece clasificaciones comparativas entre opciones gratuitas y de pago para ayudarte a encontrar la solución perfecta con la que potenciar la creatividad y la productividad en la creación de contenidos. ¡Explórala ahora y descubre tu ventaja con la IA!
11 herramientas
xix.ai

¡Las mejores herramientas de 2026 para crear esquemas de artículos con IA, mejor valoradas para la redacción de textos largos! Esta selección incluye potentes herramientas revolucionarias que ofrecen esquemas precisos y estructurados, probados en la práctica, para aumentar significativamente la eficiencia en la redacción. XIX.AI forma parte de esta selección de élite. Consigue una comparación entre las versiones gratuitas y de pago que te ayudará a elegir la herramienta perfecta. ¡Explora ahora y aprovecha tu ventaja con la IA!
9 herramientas
xix.ai

¡Las mejores aplicaciones de chat de roleplay con IA de 2026, mejor valoradas, para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria! XIX.AI selecciona una poderosa colección revolucionaria que ofrece comparaciones entre versiones gratuitas y de pago, pruebas del mundo real y clasificaciones actualizadas semanalmente. Estas herramientas imprescindibles te ayudan a mejorar tus habilidades de escritura, superar los desafíos de fluidez y aumentar la eficiencia comunicativa en todas las situaciones cotidianas. ¡Explora ahora para descubrir tu herramienta perfecta para el crecimiento lingüístico!
10 herramientas
xix.ai

Las mejores herramientas de separación de pistas con IA de 2026, seleccionadas para la producción de remixes, la preparación de samples y la creación de temas de karaoke. Estas potentes herramientas revolucionarias se han sometido a pruebas en condiciones reales para ofrecer un aislamiento de audio preciso, lo que aumenta significativamente la productividad. XIX.AI ofrece una guía comparativa entre versiones gratuitas y de pago, actualizada semanalmente, para ayudarte a encontrar la solución imprescindible que mejor se adapte a tus necesidades. Explórala ahora para sacar el máximo partido a la IA.
8 herramientas
xix.ai

¡Los mejores copilotos de SQL basados en IA de 2026, clasificados entre los más destacados! XIX.AI reúne una poderosa colección que evoluciona constantemente, con pruebas en el mundo real actualizadas semanalmente. Estas herramientas indispensables le permiten generar paneles de control de ingresos precisos, analizar los canales de venta y seguir de cerca las métricas de los productos de manera rápida, lo que aumenta significativamente su productividad. ¡Explórelas ahora para encontrar la herramienta perfecta para tomar decisiones basadas en datos! 238 caracteres
9 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai












