


 首頁
隨著邊際效益逐漸消退,CVPR 2026 預示視覺智慧領域將迎來範式轉移
過去十年間,電腦視覺已從 ImageNet 分類演進至擴散模型,旨在讓機器能夠「看見世界」。然而,隨著感知能力逐漸接近人類水準,單純提升精準度的效益正逐漸減弱。 在 CVPR 2026 會議上,視覺智能研究已出現轉變:視覺不再是最終目標,而是通往推理、決策與互動的橋樑。
超越「盲目推理」:適應性與隱性方法
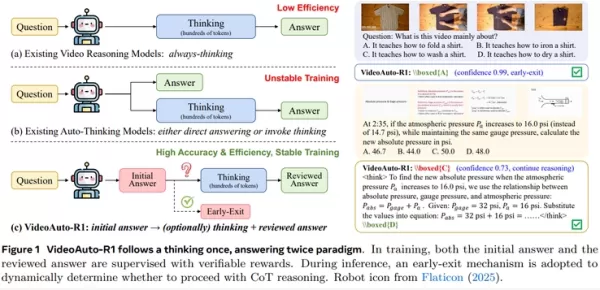
多模態模型長期以來一直依賴「思維鏈」(CoT)進行邏輯推理。然而,最新研究發現,這種持續不斷的推理往往效率低下。 VideoAuto-R1 框架引入了「按需推理」:它能直接回答簡單的感知查詢,僅在面對複雜邏輯時才觸發推理。此方法在維持巔峰性能的同時,將平均輸出長度縮減了 3.3 倍。
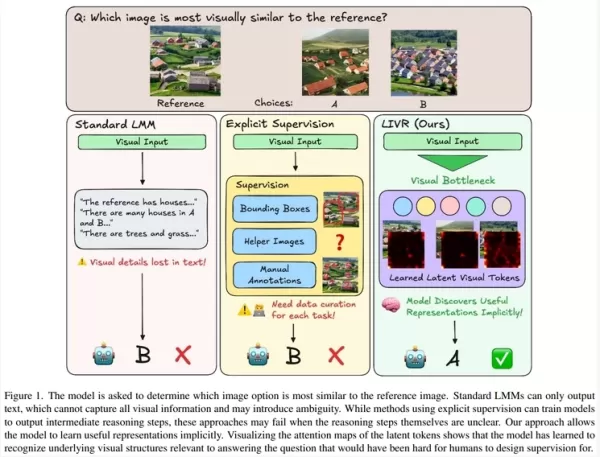
推理的媒介也在不斷演進。過去,模型依賴語言來描述空間關係,但在處理拼圖或幾何結構時往往失效。新趨勢是透過「潛在空間」進行隱式視覺推理,繞過線性文字轉換,以更精準地捕捉複雜的視覺結構。
重新思考評估:打破多選題的錯覺
當前的視覺語言模型評估過度依賴多選題(MCQA),這可能導致能力被高估。 研究指出,模型常透過排除法或選項偏好來「作弊」,使分數被高估約 20 分。為解決此問題,業界正採用「可驗證的開放式問答(verifiable open QA)」,迫使模型真正理解視覺內容,而非利用選項線索。
與此同時,評估情境正從單代理的靜態圖像轉向多代理環境。 諸如 VS-Bench 等基準測試要求模型不僅要理解環境,還須在複雜互動(例如合作與競爭)中展現策略性推理與決策能力。這標誌著視覺智慧正從被動的「理解者」轉型為主動的「決策者」。
基礎架構升級:開源模型與真實世界數據
開源社群正提升透明度。像 Molmo2 這樣的模型不僅釋出權重,還公開完整的資料與訓練流程。這些模型將能力從單張圖片擴展至影片,加入精確的定位功能,並實現從「理解」到「指出位置」的飛躍。
這項進展背後有完善的數據基礎設施作為支撐。在文字驅動的圖像編輯領域,像 Pico-Banana-400K 這樣的大規模真實世界數據集,彌補了過度依賴合成數據所造成的缺口。該數據集支援多輪編輯與偏好對齊,為訓練具備增強常識與邏輯的編輯模型奠定了堅實基礎。
總而言之,視覺智慧正從單一感知,演進為結合感知、認知與行動的整合型智慧。這項轉變不僅代表性能的微幅提升,更是對推理機制、評估範式及數據供應鏈的系統性重構。
相關文章
 Meta 在使用者強烈反對後取消了 AI 照片編輯功能
Meta,這家社交媒體巨頭,再次捲入關於人工智慧與使用者隱私之間微妙平衡的公開辯論。據 TechCrunch 報道,Meta 的 Superintelligence Labs 本週早些時候推出了一款新的 AI 影象生成器 Muse Image。然而,一個備受好評的關鍵功能——允許使用者透過“@”符號標記來修改和生成來自公開 Instagram 賬戶的影象——由於缺乏適當的通知機制,立即引發了使用者以及 CAA 等機構的強烈反對。面對強烈的批評,Meta 迅速撤銷了該決定,並於週五透過部落格文章宣佈將
DeepMind執行長哈西里斯:我每天睡六個小時,通常在凌晨1點左右感到精力充沛。
Fortune 最近刊登了對谷歌 DeepMind 執行長 Demis Hassabis 的採訪,揭示了他對休息和生產力的非傳統方法。Hassabis 透露,他睡眠時間非常少,將清醒時間劃分為兩個不同的工作階段。關於他的睡眠習慣,Hassabis 表示:“我目標睡六小時,但我的習慣非同尋常。我可以在白天有效運作。”他強調,睡眠少於六小時會對大腦健康產生負面影響。Hassabis 於 2010 年聯合創立了 DeepMind(後被谷歌收購),並因其在蛋白質結構預測方面的開創性工作榮獲 20
儘管營收未達預期,OpenAI 與 Anthropic 仍爭奪市場份額
儘管近期有報導指出 OpenAI 未達營收目標,導致本週二科技股承壓,但私人人工智慧實驗室的投資者仍展現出韌性。資深投資者已確認,儘管媒體報導負面,他們仍不會削減投資。分析師認為當前的 AI 競逐仍處於初期階段,因此排除「贏家通吃」的結果。儘管高昂的運算成本對營收造成壓力,但各實驗室可透過調高訂閱費來提升獲利能力。產業格局正經歷微妙的變化與 OpenAI 不同,競爭對手 Anthropic 獲得了
相關專題推薦
視頻創作
 適用於 Reels、Shorts 及產品上市活動的 AI 短影片吸睛開場生成器
2026 年最新最佳 AI 短影片開場白生成器,適用於 Reels、Shorts 及產品上市活動!XIX.AI 嚴選備受好評、功能強大且能顛覆遊戲規則的工具,這些工具皆經過實際測試,能帶來絕對值得一試的成果。本頁面每週更新,提供免費與付費版本的比較排行榜,助您找到提升內容創意與生產力的完美解決方案。 立即探索,釋放您的 AI 競爭優勢!
 11 個工具
 xix.ai
寫作
適用於長篇寫作的 AI 文章大綱工具
2026 年最新、最受好評的長文寫作 AI 大綱工具!這份精選清單收錄了強大且具顛覆性的工具,能透過實際測試生成精準、結構化的大綱,大幅提升寫作效率。XIX.AI 正是這份菁英名單中的一員。 獲取免費版與付費版的比較指南,助您挑選最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai
聊天機器人
用於語言練習、面試準備和日常流利度的最佳 AI 角色扮演聊天應用
2026 年最新最佳頂級評分 AI 角色扮演聊天應用,用於語言練習、面試準備和日常流利度!XIX.AI 精心策劃了一個強大的變革性合集,提供免費與付費對比、真實世界測試以及每週更新的排名。這些必試工具可幫助您提升寫作技能,克服流利度挑戰,並提高所有日常場景下的溝通效率。立即探索,發現您語言成長的完美工具!
10 個工具
xix.ai
音樂創作
用於混音製作、取樣準備及卡拉OK母帶處理的 AI 聲部分離工具
2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
8 個工具
xix.ai
數據分析
用於收入看板、轉化漏斗分析及產品指標分析的 AI SQL 助手
2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai
音樂創作
最佳用於歌曲草稿的 AI 旋律創作工具
2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai

 評論 (0)
0/500
過去十年間,電腦視覺已從 ImageNet 分類演進至擴散模型,旨在讓機器能夠「看見世界」。然而,隨著感知能力逐漸接近人類水準,單純提升精準度的效益正逐漸減弱。 在 CVPR 2026 會議上,視覺智能研究已出現轉變:視覺不再是最終目標,而是通往推理、決策與互動的橋樑。
超越「盲目推理」:適應性與隱性方法
多模態模型長期以來一直依賴「思維鏈」(CoT)進行邏輯推理。然而,最新研究發現,這種持續不斷的推理往往效率低下。 VideoAuto-R1 框架引入了「按需推理」:它能直接回答簡單的感知查詢,僅在面對複雜邏輯時才觸發推理。此方法在維持巔峰性能的同時,將平均輸出長度縮減了 3.3 倍。
推理的媒介也在不斷演進。過去,模型依賴語言來描述空間關係,但在處理拼圖或幾何結構時往往失效。新趨勢是透過「潛在空間」進行隱式視覺推理,繞過線性文字轉換,以更精準地捕捉複雜的視覺結構。
重新思考評估:打破多選題的錯覺
當前的視覺語言模型評估過度依賴多選題(MCQA),這可能導致能力被高估。 研究指出,模型常透過排除法或選項偏好來「作弊」,使分數被高估約 20 分。為解決此問題,業界正採用「可驗證的開放式問答(verifiable open QA)」,迫使模型真正理解視覺內容,而非利用選項線索。
與此同時,評估情境正從單代理的靜態圖像轉向多代理環境。 諸如 VS-Bench 等基準測試要求模型不僅要理解環境,還須在複雜互動(例如合作與競爭)中展現策略性推理與決策能力。這標誌著視覺智慧正從被動的「理解者」轉型為主動的「決策者」。
基礎架構升級:開源模型與真實世界數據
開源社群正提升透明度。像 Molmo2 這樣的模型不僅釋出權重,還公開完整的資料與訓練流程。這些模型將能力從單張圖片擴展至影片,加入精確的定位功能,並實現從「理解」到「指出位置」的飛躍。
這項進展背後有完善的數據基礎設施作為支撐。在文字驅動的圖像編輯領域,像 Pico-Banana-400K 這樣的大規模真實世界數據集,彌補了過度依賴合成數據所造成的缺口。該數據集支援多輪編輯與偏好對齊,為訓練具備增強常識與邏輯的編輯模型奠定了堅實基礎。
總而言之,視覺智慧正從單一感知,演進為結合感知、認知與行動的整合型智慧。這項轉變不僅代表性能的微幅提升,更是對推理機制、評估範式及數據供應鏈的系統性重構。








 Meta 在使用者強烈反對後取消了 AI 照片編輯功能
Meta,這家社交媒體巨頭,再次捲入關於人工智慧與使用者隱私之間微妙平衡的公開辯論。據 TechCrunch 報道,Meta 的 Superintelligence Labs 本週早些時候推出了一款新的 AI 影象生成器 Muse Image。然而,一個備受好評的關鍵功能——允許使用者透過“@”符號標記來修改和生成來自公開 Instagram 賬戶的影象——由於缺乏適當的通知機制,立即引發了使用者以及 CAA 等機構的強烈反對。面對強烈的批評,Meta 迅速撤銷了該決定,並於週五透過部落格文章宣佈將
 DeepMind執行長哈西里斯:我每天睡六個小時,通常在凌晨1點左右感到精力充沛。
Fortune 最近刊登了對谷歌 DeepMind 執行長 Demis Hassabis 的採訪,揭示了他對休息和生產力的非傳統方法。Hassabis 透露,他睡眠時間非常少,將清醒時間劃分為兩個不同的工作階段。關於他的睡眠習慣,Hassabis 表示:“我目標睡六小時,但我的習慣非同尋常。我可以在白天有效運作。”他強調,睡眠少於六小時會對大腦健康產生負面影響。Hassabis 於 2010 年聯合創立了 DeepMind(後被谷歌收購),並因其在蛋白質結構預測方面的開創性工作榮獲 20
 儘管營收未達預期,OpenAI 與 Anthropic 仍爭奪市場份額
儘管近期有報導指出 OpenAI 未達營收目標,導致本週二科技股承壓,但私人人工智慧實驗室的投資者仍展現出韌性。資深投資者已確認,儘管媒體報導負面,他們仍不會削減投資。分析師認為當前的 AI 競逐仍處於初期階段,因此排除「贏家通吃」的結果。儘管高昂的運算成本對營收造成壓力,但各實驗室可透過調高訂閱費來提升獲利能力。產業格局正經歷微妙的變化與 OpenAI 不同,競爭對手 Anthropic 獲得了

2026 年最新最佳 AI 短影片開場白生成器,適用於 Reels、Shorts 及產品上市活動!XIX.AI 嚴選備受好評、功能強大且能顛覆遊戲規則的工具,這些工具皆經過實際測試,能帶來絕對值得一試的成果。本頁面每週更新,提供免費與付費版本的比較排行榜,助您找到提升內容創意與生產力的完美解決方案。 立即探索,釋放您的 AI 競爭優勢!
11 個工具
xix.ai

2026 年最新、最受好評的長文寫作 AI 大綱工具!這份精選清單收錄了強大且具顛覆性的工具,能透過實際測試生成精準、結構化的大綱,大幅提升寫作效率。XIX.AI 正是這份菁英名單中的一員。 獲取免費版與付費版的比較指南,助您挑選最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai

2026 年最新最佳頂級評分 AI 角色扮演聊天應用,用於語言練習、面試準備和日常流利度!XIX.AI 精心策劃了一個強大的變革性合集,提供免費與付費對比、真實世界測試以及每週更新的排名。這些必試工具可幫助您提升寫作技能,克服流利度挑戰,並提高所有日常場景下的溝通效率。立即探索,發現您語言成長的完美工具!
10 個工具
xix.ai

2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
8 個工具
xix.ai

2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai

2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai












