


 Heim
Die CVPR 2026 signalisiert einen Paradigmenwechsel in der visuellen Intelligenz, da marginale Fortschritte an Bedeutung verlieren
Im Laufe des letzten Jahrzehnts hat sich die Computer Vision von der ImageNet-Klassifizierung hin zu Diffusionsmodellen weiterentwickelt, mit dem Ziel, Maschinen in die Lage zu versetzen, „die Welt zu sehen“. Doch je mehr sich die Wahrnehmungsfähigkeiten dem menschlichen Niveau annähern, desto geringer wird der Nutzen reiner Genauigkeitsgewinne. Auf der CVPR 2026 hat sich der Schwerpunkt der Forschung im Bereich der visuellen Intelligenz verschoben: Das Sehen ist nicht mehr das Endziel, sondern eine Brücke für Schlussfolgerungen, Entscheidungsfindung und Interaktion.
Über das „blinde Schlussfolgern“ hinaus: adaptive und implizite Ansätze
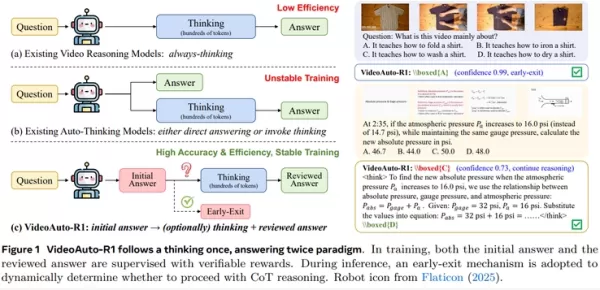
Multimodale Modelle stützen sich seit langem auf die „Denkkette“ (Chain of Thought, CoT) für logisches Schlussfolgern. Jüngste Erkenntnisse deuten jedoch darauf hin, dass dieses ständige Schlussfolgern oft ineffizient ist. Das VideoAuto-R1-Framework führt das „On-Demand-Schlussfolgern“ ein: Es beantwortet einfache Wahrnehmungsanfragen direkt und löst Schlussfolgerungen nur bei komplexer Logik aus. Diese Methode gewährleistet Spitzenleistung bei gleichzeitiger Reduzierung der durchschnittlichen Ausgabelänge um das 3,3-Fache.
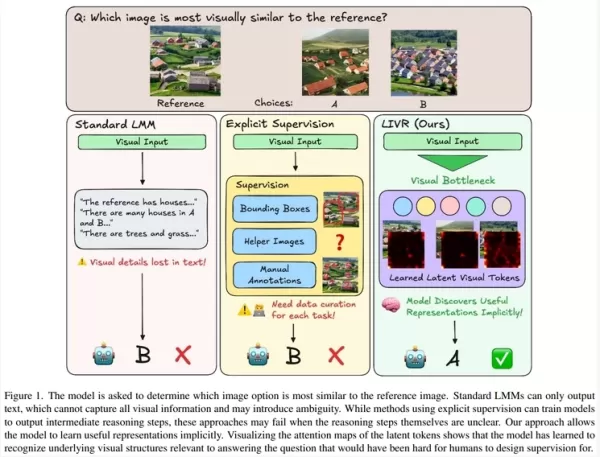
Auch das Medium des Schlussfolgerns entwickelt sich weiter. Bislang waren Modelle auf Sprache angewiesen, um räumliche Beziehungen zu beschreiben, was bei Rätseln oder geometrischen Strukturen versagte. Der neue Trend geht hin zu implizitem visuellem Schlussfolgern im „latenten Raum“, wobei die lineare Textumwandlung umgangen wird, um komplexe visuelle Strukturen besser zu erfassen.
Bewertung neu überdenken: Die Illusion der Multiple-Choice-Fragen durchbrechen
Aktuelle Bewertungen von visuell-sprachlichen Modellen stützen sich stark auf Multiple-Choice-Fragen (MCQA), wodurch die Fähigkeiten möglicherweise überschätzt werden. Untersuchungen zeigen, dass Modelle häufig durch Ausschlussverfahren oder eine Voreingenommenheit gegenüber bestimmten Antwortmöglichkeiten „schummeln“ und die Ergebnisse dadurch um etwa 20 Punkte überhöhen. Um dies zu beheben, führt die Branche „überprüfbare offene Fragen und Antworten“ ein, wodurch Modelle gezwungen werden, visuelle Inhalte wirklich zu verstehen, anstatt Hinweise in den Antwortmöglichkeiten auszunutzen.
Gleichzeitig verlagern sich die Bewertungsszenarien von statischen Bildern mit einem einzigen Agenten hin zu Umgebungen mit mehreren Agenten. Benchmarks wie VS-Bench verlangen von den Modellen, dass sie nicht nur die Umgebung erfassen, sondern auch strategisches Denken und Entscheidungsfindung in komplexen Interaktionen wie Zusammenarbeit und Wettbewerb unter Beweis stellen. Dies markiert den Übergang der visuellen Intelligenz von einem passiven „Versteher“ zu einem aktiven „Entscheider“.
Infrastruktur-Upgrades: Open-Source-Modelle und Daten aus der realen Welt
Die Open-Source-Community sorgt für mehr Transparenz. Modelle wie Molmo2 veröffentlichen nicht nur Gewichte, sondern auch vollständige Daten und Trainingsprozesse. Diese Modelle erweitern die Fähigkeiten von Einzelbildern auf Videos, fügen präzise Lokalisierungsfunktionen hinzu und schaffen den Sprung vom „Verstehen“ zum „Aufzeigen von Orten“.
Dieser Fortschritt wird durch eine umfassende Dateninfrastruktur gestützt. Für die textgesteuerte Bildbearbeitung schließen groß angelegte Datensätze aus der realen Welt wie Pico-Banana-400K die Lücke, die durch eine übermäßige Abhängigkeit von synthetischen Daten entstanden ist. Dieser Datensatz unterstützt mehrstufige Bearbeitungsvorgänge und die Abstimmung von Präferenzen und bietet damit eine solide Grundlage für das Training von Bearbeitungsmodellen mit verbessertem gesunden Menschenverstand und Logik.
Zusammenfassend lässt sich sagen, dass sich die visuelle Intelligenz von der reinen Wahrnehmung hin zu einer integrierten Intelligenz entwickelt, die Wahrnehmung, Kognition und Handlung vereint. Dieser Wandel bedeutet mehr als nur geringfügige Leistungssteigerungen; es handelt sich um eine systematische Neugestaltung von Schlussfolgerungsmechanismen, Bewertungsparadigmen und Datenlieferketten.
Verwandter Artikel
 Meta entfernt KI-Fotobearbeitungsfunktion nach Nutzerprotesten
Meta, der Social-Media-Riese, ist erneut in eine öffentliche Debatte über die heikle Balance zwischen künstlicher Intelligenz und dem Schutz der Privatsphäre der Nutzer verwickelt. Laut TechCrunch hat Meta’s Superintelligence Labs diese Woche einen n
DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter
Empfehlungen zu verwandten Spezialthemen
Videoerstellung
 KI-Generatoren für ansprechende Kurzvideos für Reels, Shorts und Produkteinführungskampagnen
Die besten KI-Generatoren für kurze Video-Hooks des Jahres 2026 für Reels, Shorts und Produkteinführungskampagnen! XIX.AI stellt erstklassige, leistungsstarke und bahnbrechende Tools zusammen, die in Praxistests überzeugende Ergebnisse liefern, die Sie unbedingt ausprobieren sollten. Diese wöchentlich aktualisierte Seite bietet Vergleichsrankings zwischen kostenlosen und kostenpflichtigen Angeboten, damit Sie die perfekte Lösung finden, um Ihre Kreativität und Produktivität bei der Erstellung von Inhalten zu steigern. Entdecken Sie jetzt die Seite und sichern Sie sich Ihren KI-Vorteil!
 11 Tools
 xix.ai
Schreiben
KI-Tools zur Gliederung von Artikeln für das Verfassen langer Texte
2026: Die neuesten, besten und am besten bewerteten KI-Tools zur Erstellung von Gliederungen für lange Texte! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die präzise, strukturierte Gliederungen liefern – getestet unter realen Bedingungen –, um die Effizienz beim Schreiben deutlich zu steigern. XIX.AI gehört zu dieser Eliteauswahl. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen bei der Auswahl des perfekten Tools hilft. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
9 Tools
xix.ai
Chatbot
Die besten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprechflüssigkeit
2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
10 Tools
xix.ai
Musikkomposition
KI-Tools zur Stim-Trennung für die Remix-Produktion, die Vorbereitung von Samples und Karaoke-Master
Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai
Datenanalyse
KI-basierte SQL-Copiloten für Umsatz-Dashboards, Kanalanalysen sowie Produktmetriken
2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai
Musikkomposition
Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

 Kommentare (0)
Im Laufe des letzten Jahrzehnts hat sich die Computer Vision von der ImageNet-Klassifizierung hin zu Diffusionsmodellen weiterentwickelt, mit dem Ziel, Maschinen in die Lage zu versetzen, „die Welt zu sehen“. Doch je mehr sich die Wahrnehmungsfähigkeiten dem menschlichen Niveau annähern, desto geringer wird der Nutzen reiner Genauigkeitsgewinne. Auf der CVPR 2026 hat sich der Schwerpunkt der Forschung im Bereich der visuellen Intelligenz verschoben: Das Sehen ist nicht mehr das Endziel, sondern eine Brücke für Schlussfolgerungen, Entscheidungsfindung und Interaktion.
Über das „blinde Schlussfolgern“ hinaus: adaptive und implizite Ansätze
Multimodale Modelle stützen sich seit langem auf die „Denkkette“ (Chain of Thought, CoT) für logisches Schlussfolgern. Jüngste Erkenntnisse deuten jedoch darauf hin, dass dieses ständige Schlussfolgern oft ineffizient ist. Das VideoAuto-R1-Framework führt das „On-Demand-Schlussfolgern“ ein: Es beantwortet einfache Wahrnehmungsanfragen direkt und löst Schlussfolgerungen nur bei komplexer Logik aus. Diese Methode gewährleistet Spitzenleistung bei gleichzeitiger Reduzierung der durchschnittlichen Ausgabelänge um das 3,3-Fache.
Auch das Medium des Schlussfolgerns entwickelt sich weiter. Bislang waren Modelle auf Sprache angewiesen, um räumliche Beziehungen zu beschreiben, was bei Rätseln oder geometrischen Strukturen versagte. Der neue Trend geht hin zu implizitem visuellem Schlussfolgern im „latenten Raum“, wobei die lineare Textumwandlung umgangen wird, um komplexe visuelle Strukturen besser zu erfassen.
Bewertung neu überdenken: Die Illusion der Multiple-Choice-Fragen durchbrechen
Aktuelle Bewertungen von visuell-sprachlichen Modellen stützen sich stark auf Multiple-Choice-Fragen (MCQA), wodurch die Fähigkeiten möglicherweise überschätzt werden. Untersuchungen zeigen, dass Modelle häufig durch Ausschlussverfahren oder eine Voreingenommenheit gegenüber bestimmten Antwortmöglichkeiten „schummeln“ und die Ergebnisse dadurch um etwa 20 Punkte überhöhen. Um dies zu beheben, führt die Branche „überprüfbare offene Fragen und Antworten“ ein, wodurch Modelle gezwungen werden, visuelle Inhalte wirklich zu verstehen, anstatt Hinweise in den Antwortmöglichkeiten auszunutzen.
Gleichzeitig verlagern sich die Bewertungsszenarien von statischen Bildern mit einem einzigen Agenten hin zu Umgebungen mit mehreren Agenten. Benchmarks wie VS-Bench verlangen von den Modellen, dass sie nicht nur die Umgebung erfassen, sondern auch strategisches Denken und Entscheidungsfindung in komplexen Interaktionen wie Zusammenarbeit und Wettbewerb unter Beweis stellen. Dies markiert den Übergang der visuellen Intelligenz von einem passiven „Versteher“ zu einem aktiven „Entscheider“.
Infrastruktur-Upgrades: Open-Source-Modelle und Daten aus der realen Welt
Die Open-Source-Community sorgt für mehr Transparenz. Modelle wie Molmo2 veröffentlichen nicht nur Gewichte, sondern auch vollständige Daten und Trainingsprozesse. Diese Modelle erweitern die Fähigkeiten von Einzelbildern auf Videos, fügen präzise Lokalisierungsfunktionen hinzu und schaffen den Sprung vom „Verstehen“ zum „Aufzeigen von Orten“.
Dieser Fortschritt wird durch eine umfassende Dateninfrastruktur gestützt. Für die textgesteuerte Bildbearbeitung schließen groß angelegte Datensätze aus der realen Welt wie Pico-Banana-400K die Lücke, die durch eine übermäßige Abhängigkeit von synthetischen Daten entstanden ist. Dieser Datensatz unterstützt mehrstufige Bearbeitungsvorgänge und die Abstimmung von Präferenzen und bietet damit eine solide Grundlage für das Training von Bearbeitungsmodellen mit verbessertem gesunden Menschenverstand und Logik.
Zusammenfassend lässt sich sagen, dass sich die visuelle Intelligenz von der reinen Wahrnehmung hin zu einer integrierten Intelligenz entwickelt, die Wahrnehmung, Kognition und Handlung vereint. Dieser Wandel bedeutet mehr als nur geringfügige Leistungssteigerungen; es handelt sich um eine systematische Neugestaltung von Schlussfolgerungsmechanismen, Bewertungsparadigmen und Datenlieferketten.








 Meta entfernt KI-Fotobearbeitungsfunktion nach Nutzerprotesten
Meta, der Social-Media-Riese, ist erneut in eine öffentliche Debatte über die heikle Balance zwischen künstlicher Intelligenz und dem Schutz der Privatsphäre der Nutzer verwickelt. Laut TechCrunch hat Meta’s Superintelligence Labs diese Woche einen n
 DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
 OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter

Die besten KI-Generatoren für kurze Video-Hooks des Jahres 2026 für Reels, Shorts und Produkteinführungskampagnen! XIX.AI stellt erstklassige, leistungsstarke und bahnbrechende Tools zusammen, die in Praxistests überzeugende Ergebnisse liefern, die Sie unbedingt ausprobieren sollten. Diese wöchentlich aktualisierte Seite bietet Vergleichsrankings zwischen kostenlosen und kostenpflichtigen Angeboten, damit Sie die perfekte Lösung finden, um Ihre Kreativität und Produktivität bei der Erstellung von Inhalten zu steigern. Entdecken Sie jetzt die Seite und sichern Sie sich Ihren KI-Vorteil!
11 Tools
xix.ai

2026: Die neuesten, besten und am besten bewerteten KI-Tools zur Erstellung von Gliederungen für lange Texte! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die präzise, strukturierte Gliederungen liefern – getestet unter realen Bedingungen –, um die Effizienz beim Schreiben deutlich zu steigern. XIX.AI gehört zu dieser Eliteauswahl. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen bei der Auswahl des perfekten Tools hilft. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
9 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai












