


 Дом
Лаборатория Tongyi компании Alibaba открыла исходный код Fun-CineForge, решив проблему дубляжа с участием нескольких дикторов
Традиционный дубляж с использованием искусственного интеллекта зачастую не справляется с задачами в таких ответственных проектах, как кино и анимация, где первостепенное значение имеет передача тонких эмоциональных пиков и идеальная синхронизация с движением губ. Чтобы решить эту ключевую проблему отрасли, Tongyi Lab официально представила и открыла исходный код революционной мультимодальной модели дубляжа киноуровня для различных сценариев — Fun-CineForge .
Преодоление аудиовизуального разрыва: четырехкомпонентная структура для безупречной синхронизации
Вместо того чтобы полагаться на базовую технологию преобразования текста в речь, Fun-CineForge разработана для овладения четырьмя критически важными аспектами профессионального дубляжа:
Синхронизация губ: обеспечивает исключительную точность совпадения синтезированной речи с движениями рта персонажа на экране.
Эмоциональная экспрессия: наполняет голос аутентичными человеческими эмоциями путем анализа мимики и контекстуальных инструкций.
Единообразие голоса: поддерживает стабильную, узнаваемую голосовую индивидуальность конкретных персонажей в сложных диалоговых сценах с участием нескольких говорящих.
Синхронизация по времени: позволяет вставлять диалоги с точностью до миллисекунд, даже если говорящий находится за кадром или частично скрыт.
Основная инновация: новаторская «временная модальность» и набор данных высокой точности
Технический прорыв Fun-CineForge обусловлен уникальной философией совместного проектирования «данные + модель»:
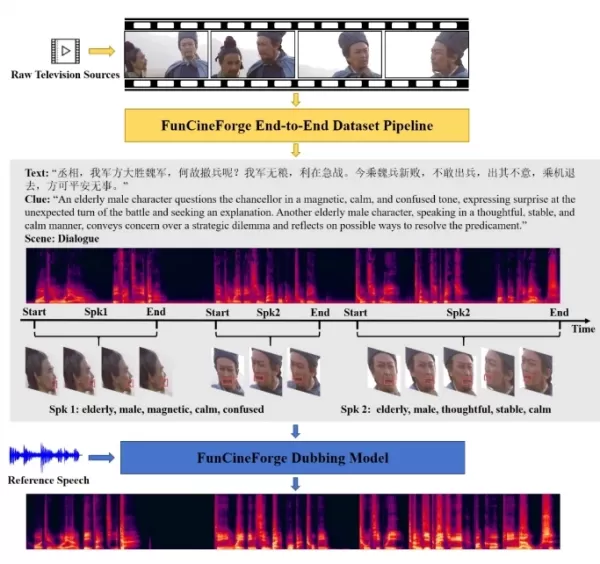
Набор данных высокого качества CineDub: Tongyi Lab также открыла исходный код автоматизированного конвейера построения набора данных CineDub. Используя механизм исправления ошибок по цепочке мыслей, он снижает уровень ошибок транскрипции для китайского и английского текстов примерно до 1%–2% и сокращает ошибки диаризации говорящих до 1,2%.
Архитектура слияния четырех модальностей: Модель впервые интегрирует «временную модальность», совместно моделируя визуальные входы (форма губ и мимика), текст (диалог и эмоциональный контекст) и аудио (голосовой эталон). Такое слияние позволяет обеспечить точную синхронизацию в сложных сценах, включая те, где лица не видны.
Доказанное превосходство: новаторский дубляж аутентичных диалогов с участием нескольких персонажей
Результаты тестирования показывают, что Fun-CineForge значительно превосходит базовые модели, такие как DeepDubber-V1, по ключевым показателям: коэффициенту ошибок слов (WER/CER), синхронизации губ (LSE-C/D) и сходству голосов. Знаковым достижением является уникальная способность точно обрабатывать дуэты и многосторонние диалоги, демонстрируя замечательную устойчивость в видеороликах длительностью до 30 секунд.
GitHub: https://github.com/FunAudioLLM/FunCineForge
HuggingFace: https://huggingface.co/FunAudioLLM/Fun-CineForge
ModelScope: https://www.modelscope.cn/models/FunAudioLLM/Fun-CineForge/
Связанная статья
 iFLYTEK представляет общую большую модель Spark X2.5
1 сентября iFlytek откроет открытый доступ к двум большим языковым моделям, ориентированным на работу на периферийных устройствах: Xinghuo X2.5-4B и Xinghuo X2.5-1.7B, согласно последнему официальному заявлению. Обе модели изначально поддерживают кон
Meta удаляет функцию редактирования фотографий с помощью ИИ после негативной реакции пользователей
Meta, гигант социальных сетей, вновь оказалась в центре публичной дискуссии о хрупком балансе между искусственным интеллектом и конфиденциальностью пользователей. Согласно TechCrunch, подразделение Meta Superintelligence Labs представило новый генера
Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
Рекомендации по связанным специальным темам
Создание анимации
 Инструменты искусственного интеллекта для анимации сцен в контенте социальных сетей
Здесь компания XIX.AI собрала лучшие и самые популярные инструменты 2026 года для создания анимации сцен с помощью ИИ, предназначенные для контента в социальных сетях. Эти мощные инструменты, способные кардинально изменить ситуацию в отрасли, прошли реальные тесты и сопровождаются подробным сравнением бесплатных и платных версий, что помогает авторам значительно повысить продуктивность. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть свой потенциал в области ИИ.
 9 инструментов
 xix.ai
Создание видео
Генераторы привлекательных заглавий для коротких видеороликов с использованием ИИ: для Reels, Shorts и кампаний по запуску продуктов
2026: лучшие современные генераторы захватывающих заставок для короткометражных видео на базе ИИ для Reels, Shorts и кампаний по запуску продуктов! XIX.AI подбирает самые высокооцененные и мощные инструменты, способные кардинально изменить ситуацию, которые в ходе реальных тестов демонстрируют результаты, которые обязательно стоит попробовать. Эта страница, обновляемая еженедельно, предлагает сравнительные рейтинги бесплатных и платных инструментов, чтобы помочь вам найти идеальное решение для повышения креативности и продуктивности при создании контента. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть свой потенциал с помощью ИИ!
11 инструментов
xix.ai
письмо
Инструменты для создания плана статей с использованием ИИ при написании длинных текстов
2026: лучшие и самые популярные инструменты для создания планов статей с помощью ИИ для написания длинных текстов! В эту тщательно подобранную подборку вошли мощные, революционные инструменты, которые генерируют точные и структурированные планы, прошедшие проверку на практике, что позволяет значительно повысить эффективность написания текстов. XIX.AI входит в эту элитную подборку. Получите сравнение бесплатных и платных версий, чтобы выбрать идеальный инструмент. Изучите их прямо сейчас и раскройте свой потенциал с помощью ИИ!
9 инструментов
xix.ai
чат-бот
Лучшие приложения для ролевых чатов с ИИ для практики языка, подготовки к собеседованиям и ежедневной разговорной практики
2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты разделения стемов с использованием ИИ для создания ремиксов, подготовки образцов звука и формирования финальных версий караоке.
2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai
Анализ данных
ИИ-копилоты для SQL, предназначенные для создания панелей управления доходами, анализа воронки продаж и отслеживания показателей продуктов.
2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai

 Комментарии (0)
Традиционный дубляж с использованием искусственного интеллекта зачастую не справляется с задачами в таких ответственных проектах, как кино и анимация, где первостепенное значение имеет передача тонких эмоциональных пиков и идеальная синхронизация с движением губ. Чтобы решить эту ключевую проблему отрасли, Tongyi Lab официально представила и открыла исходный код революционной мультимодальной модели дубляжа киноуровня для различных сценариев —
Преодоление аудиовизуального разрыва: четырехкомпонентная структура для безупречной синхронизации
Вместо того чтобы полагаться на базовую технологию преобразования текста в речь, Fun-CineForge разработана для овладения четырьмя критически важными аспектами профессионального дубляжа:
Синхронизация губ: обеспечивает исключительную точность совпадения синтезированной речи с движениями рта персонажа на экране.
Эмоциональная экспрессия: наполняет голос аутентичными человеческими эмоциями путем анализа мимики и контекстуальных инструкций.
Единообразие голоса: поддерживает стабильную, узнаваемую голосовую индивидуальность конкретных персонажей в сложных диалоговых сценах с участием нескольких говорящих.
Синхронизация по времени: позволяет вставлять диалоги с точностью до миллисекунд, даже если говорящий находится за кадром или частично скрыт.
Основная инновация: новаторская «временная модальность» и набор данных высокой точности
Технический прорыв Fun-CineForge обусловлен уникальной философией совместного проектирования «данные + модель»:
Набор данных высокого качества CineDub: Tongyi Lab также открыла исходный код автоматизированного конвейера построения набора данных CineDub. Используя механизм исправления ошибок по цепочке мыслей, он снижает уровень ошибок транскрипции для китайского и английского текстов примерно до 1%–2% и сокращает ошибки диаризации говорящих до 1,2%.
Архитектура слияния четырех модальностей: Модель впервые интегрирует «временную модальность», совместно моделируя визуальные входы (форма губ и мимика), текст (диалог и эмоциональный контекст) и аудио (голосовой эталон). Такое слияние позволяет обеспечить точную синхронизацию в сложных сценах, включая те, где лица не видны.
Доказанное превосходство: новаторский дубляж аутентичных диалогов с участием нескольких персонажей
Результаты тестирования показывают, что Fun-CineForge значительно превосходит базовые модели, такие как DeepDubber-V1, по ключевым показателям: коэффициенту ошибок слов (WER/CER), синхронизации губ (LSE-C/D) и сходству голосов. Знаковым достижением является уникальная способность точно обрабатывать дуэты и многосторонние диалоги, демонстрируя замечательную устойчивость в видеороликах длительностью до 30 секунд.
GitHub: https://github.com/FunAudioLLM/FunCineForge
HuggingFace: https://huggingface.co/FunAudioLLM/Fun-CineForge
ModelScope: https://www.modelscope.cn/models/FunAudioLLM/Fun-CineForge/








 iFLYTEK представляет общую большую модель Spark X2.5
1 сентября iFlytek откроет открытый доступ к двум большим языковым моделям, ориентированным на работу на периферийных устройствах: Xinghuo X2.5-4B и Xinghuo X2.5-1.7B, согласно последнему официальному заявлению. Обе модели изначально поддерживают кон
 Meta удаляет функцию редактирования фотографий с помощью ИИ после негативной реакции пользователей
Meta, гигант социальных сетей, вновь оказалась в центре публичной дискуссии о хрупком балансе между искусственным интеллектом и конфиденциальностью пользователей. Согласно TechCrunch, подразделение Meta Superintelligence Labs представило новый генера
 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи

Здесь компания XIX.AI собрала лучшие и самые популярные инструменты 2026 года для создания анимации сцен с помощью ИИ, предназначенные для контента в социальных сетях. Эти мощные инструменты, способные кардинально изменить ситуацию в отрасли, прошли реальные тесты и сопровождаются подробным сравнением бесплатных и платных версий, что помогает авторам значительно повысить продуктивность. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть свой потенциал в области ИИ.
9 инструментов
xix.ai

2026: лучшие современные генераторы захватывающих заставок для короткометражных видео на базе ИИ для Reels, Shorts и кампаний по запуску продуктов! XIX.AI подбирает самые высокооцененные и мощные инструменты, способные кардинально изменить ситуацию, которые в ходе реальных тестов демонстрируют результаты, которые обязательно стоит попробовать. Эта страница, обновляемая еженедельно, предлагает сравнительные рейтинги бесплатных и платных инструментов, чтобы помочь вам найти идеальное решение для повышения креативности и продуктивности при создании контента. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть свой потенциал с помощью ИИ!
11 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для создания планов статей с помощью ИИ для написания длинных текстов! В эту тщательно подобранную подборку вошли мощные, революционные инструменты, которые генерируют точные и структурированные планы, прошедшие проверку на практике, что позволяет значительно повысить эффективность написания текстов. XIX.AI входит в эту элитную подборку. Получите сравнение бесплатных и платных версий, чтобы выбрать идеальный инструмент. Изучите их прямо сейчас и раскройте свой потенциал с помощью ИИ!
9 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
10 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai

2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai












