


 Lar
O Tongyi Lab, da Alibaba, torna o Fun-CineForge de código aberto e resolve o desafio da dublagem com vários locutores
A dublagem por IA tradicional muitas vezes fica aquém das expectativas em produções de alto nível, como filmes e animações, onde é fundamental captar nuances emocionais e sincronizar perfeitamente os movimentos labiais. Para enfrentar esse desafio central do setor, o Tongyi Lab lançou oficialmente e disponibilizou como código aberto o inovador modelo de dublagem multimodal para múltiplos cenários e de qualidade cinematográfica: o Fun-CineForge .
Preenchendo a lacuna audiovisual: uma estrutura de quatro pilares para sincronização perfeita
Em vez de depender da conversão básica de texto em fala, o Fun-CineForge foi projetado para dominar quatro dimensões críticas da dublagem profissional:
Sincronização labial: garante que a fala sintetizada se alinhe aos movimentos da boca dos personagens na tela com precisão excepcional.
Expressão emocional: infunde na voz emoções autênticas semelhantes às humanas, analisando sinais faciais e instruções contextuais.
Consistência vocal: mantém uma identidade vocal estável e reconhecível para personagens específicos em cenas complexas de diálogo com vários interlocutores.
Alinhamento temporal: permite a inserção de diálogos com precisão de milissegundos, mesmo quando o locutor está fora da tela ou parcialmente oculto.
Inovação central: pioneira na “modalidade temporal” e em um conjunto de dados de alta fidelidade
O salto técnico do Fun-CineForge decorre de sua filosofia única de co-projeto “dados + modelo”:
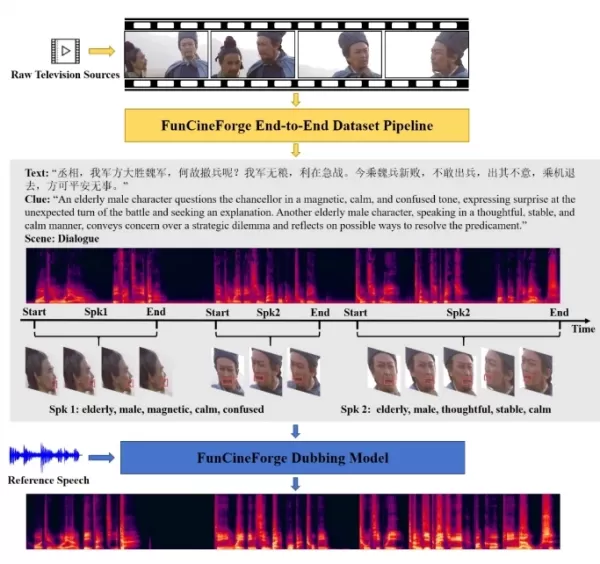
O Conjunto de Dados de Alta Qualidade CineDub: O Tongyi Lab também disponibilizou como código aberto o pipeline automatizado de construção do conjunto de dados CineDub. Utilizando um mecanismo de correção de erros de cadeia de pensamento, ele reduz as taxas de erro de transcrição para textos em chinês e inglês para aproximadamente 1% a 2% e reduz drasticamente os erros de diarização de falantes para até 1,2%.
Arquitetura de fusão de quatro modalidades: O modelo é pioneiro na integração de uma “modalidade temporal”, modelando conjuntamente entradas visuais (forma dos lábios e expressão), texto (diálogo e contexto emocional) e áudio (referência de voz). Essa fusão permite a sincronização exata em cenas desafiadoras, incluindo aquelas sem rostos visíveis.
Excelência comprovada: dublagem pioneira de diálogos autênticos com múltiplos personagens
Os resultados de benchmark demonstram que o Fun-CineForge supera substancialmente os modelos de referência, como o DeepDubber-V1, em métricas-chave: taxa de erro de palavras (WER/CER), sincronização labial (LSE-C/D) e similaridade de voz. Uma conquista marcante é sua capacidade inédita de lidar com diálogos em dueto e com múltiplos interlocutores com precisão, mostrando notável robustez em clipes de vídeo de até 30 segundos.
GitHub: https://github.com/FunAudioLLM/FunCineForge
HuggingFace: https://huggingface.co/FunAudioLLM/Fun-CineForge
ModelScope: https://www.modelscope.cn/models/FunAudioLLM/Fun-CineForge/
Artigo relacionado
 CEO da DeepMind, Hassabis: Durmo seis horas por dia, geralmente me sinto energético por volta da 1h
O Fortune recentemente publicou uma entrevista com Demis Hassabis, CEO da Google DeepMind, revelando sua abordagem incomum para descanso e produtividade. Hassabis revelou que dorme muito pouco, estruturando suas horas acordadas em dois blocos de trab
OpenAI e Anthropic disputam participação no mercado, apesar da queda na receita
Apesar de relatos recentes sugerirem que a OpenAI não atingiu suas metas de receita, o que gerou pressão sobre as ações do setor de tecnologia nesta terça-feira, os investidores privados em laboratóri
Conformidade com a regulamentação de veículos autônomos na Califórnia: uma nova era de multas, geocercas e 1 milhão de milhas
A Guident opera um veículo de transporte da AuveTech no sul da Flórida, administrando uma rota de quatro milhas em West Palm Beach e uma rota de uma milha em Boca Raton por meio de sua tecnologia de m
Recomendações de tópicos especiais relacionados
Criação de vídeo
 Geradores de ganchos para vídeos curtos com IA para Reels, Shorts e campanhas de lançamento de produtos
Os melhores geradores de ganchos para vídeos curtos com IA de 2026 para Reels, Shorts e campanhas de lançamento de produtos! A XIX.AI seleciona as ferramentas mais bem avaliadas, poderosas e revolucionárias, que oferecem resultados imperdíveis comprovados por testes reais. Esta página, atualizada semanalmente, apresenta rankings comparativos entre opções gratuitas e pagas para ajudar você a encontrar a solução perfeita para impulsionar a criatividade e a produtividade do seu conteúdo. Explore agora para descobrir sua vantagem com IA!
 11 ferramentas
 xix.ai
escrita
Ferramentas de IA para esboço de artigos em formato longo
2026: As melhores e mais bem avaliadas ferramentas de esboço com IA para redação de textos longos! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que geram esboços precisos e estruturados, comprovados em testes reais, para aumentar significativamente a eficiência na redação. A XIX.AI faz parte dessa seleção de elite. Veja uma comparação entre as versões gratuita e paga para ajudá-lo a escolher a ferramenta perfeita. Explore agora e descubra sua vantagem com a IA!
9 ferramentas
xix.ai
chatbot
Melhores aplicativos de chat de interpretação de papéis com IA para prática de idiomas, preparação para entrevistas e fluência diária
2026 Últimas Melhores Aplicativos de Chat de Interpretação de Papéis por IA Mais Bem Avaliados para Prática de Idiomas, Preparação para Entrevistas e Fluência Diária! O XIX.AI seleciona uma poderosa coleção revolucionária que oferece comparação entre gratuito e pago, testes do mundo real e classificações atualizadas semanalmente. Essas ferramentas imperdíveis ajudam você a aprimorar suas habilidades de escrita, superar desafios de fluência e melhorar a eficiência da comunicação em todos os cenários diários. Explore agora para descobrir sua ferramenta perfeita para o crescimento do idioma!
10 ferramentas
xix.ai
Composição musical
Ferramentas de separação de stems com IA para produção de remixes, preparação de samples e masters de karaokê
As melhores e mais bem avaliadas ferramentas de separação de faixas com IA de 2026, selecionadas especialmente para produção de remixes, preparação de samples e masters de karaokê. Essas ferramentas poderosas e revolucionárias passaram por testes práticos para oferecer isolamento de áudio preciso, aumentando significativamente a produtividade. A XIX.AI oferece um guia comparativo entre versões gratuitas e pagas, atualizado semanalmente, para ajudá-lo a encontrar a solução imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Análise de dados
Copilotos de IA para SQL voltados para painéis de receita, análise de funis e métricas de produtos
2026: Os melhores copilotos AI para SQL, atualizados e classificados entre os melhores! A XIX.AI reúne uma coleção poderosa e revolucionária, com testes em ambiente real atualizados semanalmente. Essas ferramentas indispensáveis ajudam a gerar painéis de controle de receita precisos, analisar funis de vendas e rastrear métricas de produtos de forma rápida, aumentando significativamente a produtividade. Explore agora e encontre a ferramenta perfeita para tomada de decisões baseadas em dados! 238 caracteres
9 ferramentas
xix.ai
Composição musical
Melhores Ferramentas de IA para Criação de Melodias para Rascunhos de Músicas
2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai

 Comentários (0)
A dublagem por IA tradicional muitas vezes fica aquém das expectativas em produções de alto nível, como filmes e animações, onde é fundamental captar nuances emocionais e sincronizar perfeitamente os movimentos labiais. Para enfrentar esse desafio central do setor, o Tongyi Lab lançou oficialmente e disponibilizou como código aberto o inovador modelo de dublagem multimodal para múltiplos cenários e de qualidade cinematográfica:
Preenchendo a lacuna audiovisual: uma estrutura de quatro pilares para sincronização perfeita
Em vez de depender da conversão básica de texto em fala, o Fun-CineForge foi projetado para dominar quatro dimensões críticas da dublagem profissional:
Sincronização labial: garante que a fala sintetizada se alinhe aos movimentos da boca dos personagens na tela com precisão excepcional.
Expressão emocional: infunde na voz emoções autênticas semelhantes às humanas, analisando sinais faciais e instruções contextuais.
Consistência vocal: mantém uma identidade vocal estável e reconhecível para personagens específicos em cenas complexas de diálogo com vários interlocutores.
Alinhamento temporal: permite a inserção de diálogos com precisão de milissegundos, mesmo quando o locutor está fora da tela ou parcialmente oculto.
Inovação central: pioneira na “modalidade temporal” e em um conjunto de dados de alta fidelidade
O salto técnico do Fun-CineForge decorre de sua filosofia única de co-projeto “dados + modelo”:
O Conjunto de Dados de Alta Qualidade CineDub: O Tongyi Lab também disponibilizou como código aberto o pipeline automatizado de construção do conjunto de dados CineDub. Utilizando um mecanismo de correção de erros de cadeia de pensamento, ele reduz as taxas de erro de transcrição para textos em chinês e inglês para aproximadamente 1% a 2% e reduz drasticamente os erros de diarização de falantes para até 1,2%.
Arquitetura de fusão de quatro modalidades: O modelo é pioneiro na integração de uma “modalidade temporal”, modelando conjuntamente entradas visuais (forma dos lábios e expressão), texto (diálogo e contexto emocional) e áudio (referência de voz). Essa fusão permite a sincronização exata em cenas desafiadoras, incluindo aquelas sem rostos visíveis.
Excelência comprovada: dublagem pioneira de diálogos autênticos com múltiplos personagens
Os resultados de benchmark demonstram que o Fun-CineForge supera substancialmente os modelos de referência, como o DeepDubber-V1, em métricas-chave: taxa de erro de palavras (WER/CER), sincronização labial (LSE-C/D) e similaridade de voz. Uma conquista marcante é sua capacidade inédita de lidar com diálogos em dueto e com múltiplos interlocutores com precisão, mostrando notável robustez em clipes de vídeo de até 30 segundos.
GitHub: https://github.com/FunAudioLLM/FunCineForge
HuggingFace: https://huggingface.co/FunAudioLLM/Fun-CineForge
ModelScope: https://www.modelscope.cn/models/FunAudioLLM/Fun-CineForge/








 CEO da DeepMind, Hassabis: Durmo seis horas por dia, geralmente me sinto energético por volta da 1h
O Fortune recentemente publicou uma entrevista com Demis Hassabis, CEO da Google DeepMind, revelando sua abordagem incomum para descanso e produtividade. Hassabis revelou que dorme muito pouco, estruturando suas horas acordadas em dois blocos de trab
 OpenAI e Anthropic disputam participação no mercado, apesar da queda na receita
Apesar de relatos recentes sugerirem que a OpenAI não atingiu suas metas de receita, o que gerou pressão sobre as ações do setor de tecnologia nesta terça-feira, os investidores privados em laboratóri
Conformidade com a regulamentação de veículos autônomos na Califórnia: uma nova era de multas, geocercas e 1 milhão de milhas
A Guident opera um veículo de transporte da AuveTech no sul da Flórida, administrando uma rota de quatro milhas em West Palm Beach e uma rota de uma milha em Boca Raton por meio de sua tecnologia de m

Os melhores geradores de ganchos para vídeos curtos com IA de 2026 para Reels, Shorts e campanhas de lançamento de produtos! A XIX.AI seleciona as ferramentas mais bem avaliadas, poderosas e revolucionárias, que oferecem resultados imperdíveis comprovados por testes reais. Esta página, atualizada semanalmente, apresenta rankings comparativos entre opções gratuitas e pagas para ajudar você a encontrar a solução perfeita para impulsionar a criatividade e a produtividade do seu conteúdo. Explore agora para descobrir sua vantagem com IA!
11 ferramentas
xix.ai

2026: As melhores e mais bem avaliadas ferramentas de esboço com IA para redação de textos longos! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que geram esboços precisos e estruturados, comprovados em testes reais, para aumentar significativamente a eficiência na redação. A XIX.AI faz parte dessa seleção de elite. Veja uma comparação entre as versões gratuita e paga para ajudá-lo a escolher a ferramenta perfeita. Explore agora e descubra sua vantagem com a IA!
9 ferramentas
xix.ai

2026 Últimas Melhores Aplicativos de Chat de Interpretação de Papéis por IA Mais Bem Avaliados para Prática de Idiomas, Preparação para Entrevistas e Fluência Diária! O XIX.AI seleciona uma poderosa coleção revolucionária que oferece comparação entre gratuito e pago, testes do mundo real e classificações atualizadas semanalmente. Essas ferramentas imperdíveis ajudam você a aprimorar suas habilidades de escrita, superar desafios de fluência e melhorar a eficiência da comunicação em todos os cenários diários. Explore agora para descobrir sua ferramenta perfeita para o crescimento do idioma!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de separação de faixas com IA de 2026, selecionadas especialmente para produção de remixes, preparação de samples e masters de karaokê. Essas ferramentas poderosas e revolucionárias passaram por testes práticos para oferecer isolamento de áudio preciso, aumentando significativamente a produtividade. A XIX.AI oferece um guia comparativo entre versões gratuitas e pagas, atualizado semanalmente, para ajudá-lo a encontrar a solução imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

2026: Os melhores copilotos AI para SQL, atualizados e classificados entre os melhores! A XIX.AI reúne uma coleção poderosa e revolucionária, com testes em ambiente real atualizados semanalmente. Essas ferramentas indispensáveis ajudam a gerar painéis de controle de receita precisos, analisar funis de vendas e rastrear métricas de produtos de forma rápida, aumentando significativamente a produtividade. Explore agora e encontre a ferramenta perfeita para tomada de decisões baseadas em dados! 238 caracteres
9 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai












