


 Heim
Alibabas Tongyi Lab veröffentlicht „Fun-CineForge“ als Open-Source-Software und löst damit das Problem der Synchronisation mit mehreren Sprechern
Herkömmliche KI-Synchronisation versagt oft bei anspruchsvollen Produktionen wie Filmen und Animationen, bei denen es entscheidend darauf ankommt, nuancierte emotionale Höhepunkte einzufangen und die Lippensynchronisation perfekt abzustimmen. Um diese zentrale Herausforderung der Branche zu bewältigen, hat Tongyi Lab das bahnbrechende, für den Filmbereich geeignete, szenarioübergreifende multimodale Synchronisationsmodell „Fun-CineForge “ offiziell vorgestellt und als Open-Source-Projekt veröffentlicht.
Die audiovisuelle Lücke schließen: Ein Vier-Säulen-Framework für nahtlose Synchronisation
Anstatt sich auf einfache Text-to-Speech-Technologie zu verlassen, wurde Fun-CineForge entwickelt, um vier entscheidende Dimensionen der professionellen Synchronisation zu meistern:
Lippensynchronisation: Stellt sicher, dass die synthetisierte Sprache mit außergewöhnlicher Präzision mit den Mundbewegungen der Figuren auf dem Bildschirm übereinstimmt.
Emotionaler Ausdruck: Verleiht der Stimme authentische, menschenähnliche Emotionen durch die Analyse von Gesichtsausdrücken und kontextbezogenen Anweisungen.
Stimmkonsistenz: Bewahrt eine stabile, wiedererkennbare stimmliche Identität für bestimmte Charaktere in komplexen Dialogszenen mit mehreren Sprechern.
Zeitliche Abstimmung: Ermöglicht die millisekundengenaue Einfügung von Dialogen, selbst wenn der Sprecher nicht im Bild ist oder teilweise verdeckt wird.
Kerninnovation: Wegweisende „Zeitmodalität“ und ein High-Fidelity-Datensatz
Der technische Sprung von Fun-CineForge beruht auf seiner einzigartigen „Daten + Modell“-Co-Design-Philosophie:
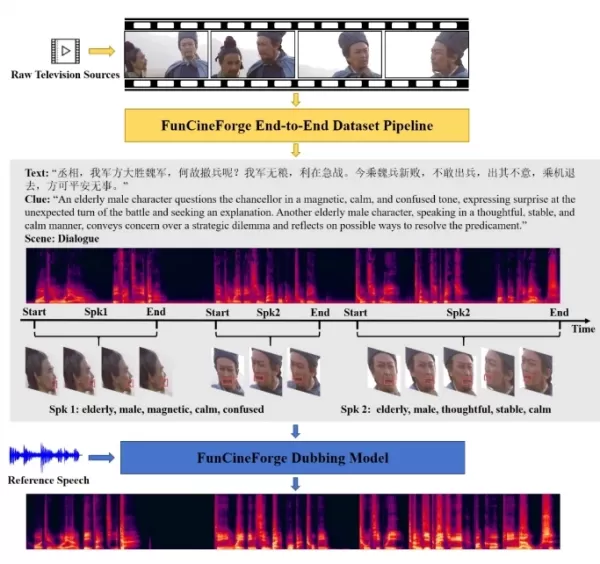
Der hochwertige CineDub-Datensatz: Das Tongyi Lab hat zudem die automatisierte Pipeline zur Erstellung des CineDub-Datensatzes als Open Source veröffentlicht. Durch den Einsatz eines „Chain-of-Thought“-Fehlerkorrekturmechanismus reduziert sie die Transkriptionsfehlerrate für chinesischen und englischen Text auf etwa 1 % bis 2 % und senkt die Fehler bei der Sprecherzuordnung auf bis zu 1,2 %.
Vier-Modalitäten-Fusionsarchitektur: Das Modell leistet Pionierarbeit bei der Integration einer „Zeitmodalität“, indem es visuelle Eingaben (Lippenform und Mimik), Text (Dialog und emotionaler Kontext) und Audio (Stimmreferenz) gemeinsam modelliert. Diese Fusion ermöglicht eine exakte Synchronisation in anspruchsvollen Szenen, einschließlich solcher ohne sichtbare Gesichter.
Nachgewiesene Exzellenz: Wegweisende authentische Synchronisation von Dialogen mit mehreren Charakteren
Benchmark-Ergebnisse zeigen, dass Fun-CineForge Basismodelle wie DeepDubber-V1 in allen wichtigen Metriken deutlich übertrifft: Wortfehlerrate (WER/CER), Lippensynchronisation (LSE-C/D) und Stimmähnlichkeit. Eine bahnbrechende Errungenschaft ist die in dieser Art einzigartige Fähigkeit, Duette und Dialoge mit mehreren Personen präzise zu verarbeiten, wobei es in Videoclips von bis zu 30 Sekunden bemerkenswerte Robustheit zeigt.
GitHub: https://github.com/FunAudioLLM/FunCineForge
HuggingFace: https://huggingface.co/FunAudioLLM/Fun-CineForge
ModelScope: https://www.modelscope.cn/models/FunAudioLLM/Fun-CineForge/
Verwandter Artikel
 DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter
Einhaltung der Vorschriften für autonome Fahrzeuge in Kalifornien: Eine neue Ära von Bußgeldern, Geofences und 1 Million Meilen
Guident betreibt einen AuveTech-Shuttle in Südflorida und verwaltet mithilfe seiner Fernüberwachungstechnologie eine vier Meilen lange Strecke in West Palm Beach sowie eine eine Meile lange Strecke in
Empfehlungen zu verwandten Spezialthemen
Schreiben
 KI-Tools zur Gliederung von Artikeln für das Verfassen langer Texte
2026: Die neuesten, besten und am besten bewerteten KI-Tools zur Erstellung von Gliederungen für lange Texte! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die präzise, strukturierte Gliederungen liefern – getestet unter realen Bedingungen –, um die Effizienz beim Schreiben deutlich zu steigern. XIX.AI gehört zu dieser Eliteauswahl. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen bei der Auswahl des perfekten Tools hilft. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
 9 Tools
 xix.ai
Chatbot
Die besten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprechflüssigkeit
2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
10 Tools
xix.ai
Musikkomposition
KI-Tools zur Stim-Trennung für die Remix-Produktion, die Vorbereitung von Samples und Karaoke-Master
Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai
Datenanalyse
KI-basierte SQL-Copiloten für Umsatz-Dashboards, Kanalanalysen sowie Produktmetriken
2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai
Musikkomposition
Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai
Chatbot
Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

 Kommentare (0)
Herkömmliche KI-Synchronisation versagt oft bei anspruchsvollen Produktionen wie Filmen und Animationen, bei denen es entscheidend darauf ankommt, nuancierte emotionale Höhepunkte einzufangen und die Lippensynchronisation perfekt abzustimmen. Um diese zentrale Herausforderung der Branche zu bewältigen, hat Tongyi Lab das bahnbrechende, für den Filmbereich geeignete, szenarioübergreifende multimodale Synchronisationsmodell „
Die audiovisuelle Lücke schließen: Ein Vier-Säulen-Framework für nahtlose Synchronisation
Anstatt sich auf einfache Text-to-Speech-Technologie zu verlassen, wurde Fun-CineForge entwickelt, um vier entscheidende Dimensionen der professionellen Synchronisation zu meistern:
Lippensynchronisation: Stellt sicher, dass die synthetisierte Sprache mit außergewöhnlicher Präzision mit den Mundbewegungen der Figuren auf dem Bildschirm übereinstimmt.
Emotionaler Ausdruck: Verleiht der Stimme authentische, menschenähnliche Emotionen durch die Analyse von Gesichtsausdrücken und kontextbezogenen Anweisungen.
Stimmkonsistenz: Bewahrt eine stabile, wiedererkennbare stimmliche Identität für bestimmte Charaktere in komplexen Dialogszenen mit mehreren Sprechern.
Zeitliche Abstimmung: Ermöglicht die millisekundengenaue Einfügung von Dialogen, selbst wenn der Sprecher nicht im Bild ist oder teilweise verdeckt wird.
Kerninnovation: Wegweisende „Zeitmodalität“ und ein High-Fidelity-Datensatz
Der technische Sprung von Fun-CineForge beruht auf seiner einzigartigen „Daten + Modell“-Co-Design-Philosophie:
Der hochwertige CineDub-Datensatz: Das Tongyi Lab hat zudem die automatisierte Pipeline zur Erstellung des CineDub-Datensatzes als Open Source veröffentlicht. Durch den Einsatz eines „Chain-of-Thought“-Fehlerkorrekturmechanismus reduziert sie die Transkriptionsfehlerrate für chinesischen und englischen Text auf etwa 1 % bis 2 % und senkt die Fehler bei der Sprecherzuordnung auf bis zu 1,2 %.
Vier-Modalitäten-Fusionsarchitektur: Das Modell leistet Pionierarbeit bei der Integration einer „Zeitmodalität“, indem es visuelle Eingaben (Lippenform und Mimik), Text (Dialog und emotionaler Kontext) und Audio (Stimmreferenz) gemeinsam modelliert. Diese Fusion ermöglicht eine exakte Synchronisation in anspruchsvollen Szenen, einschließlich solcher ohne sichtbare Gesichter.
Nachgewiesene Exzellenz: Wegweisende authentische Synchronisation von Dialogen mit mehreren Charakteren
Benchmark-Ergebnisse zeigen, dass Fun-CineForge Basismodelle wie DeepDubber-V1 in allen wichtigen Metriken deutlich übertrifft: Wortfehlerrate (WER/CER), Lippensynchronisation (LSE-C/D) und Stimmähnlichkeit. Eine bahnbrechende Errungenschaft ist die in dieser Art einzigartige Fähigkeit, Duette und Dialoge mit mehreren Personen präzise zu verarbeiten, wobei es in Videoclips von bis zu 30 Sekunden bemerkenswerte Robustheit zeigt.
GitHub: https://github.com/FunAudioLLM/FunCineForge
HuggingFace: https://huggingface.co/FunAudioLLM/Fun-CineForge
ModelScope: https://www.modelscope.cn/models/FunAudioLLM/Fun-CineForge/








 DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
 OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter
Einhaltung der Vorschriften für autonome Fahrzeuge in Kalifornien: Eine neue Ära von Bußgeldern, Geofences und 1 Million Meilen
Guident betreibt einen AuveTech-Shuttle in Südflorida und verwaltet mithilfe seiner Fernüberwachungstechnologie eine vier Meilen lange Strecke in West Palm Beach sowie eine eine Meile lange Strecke in

2026: Die neuesten, besten und am besten bewerteten KI-Tools zur Erstellung von Gliederungen für lange Texte! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die präzise, strukturierte Gliederungen liefern – getestet unter realen Bedingungen –, um die Effizienz beim Schreiben deutlich zu steigern. XIX.AI gehört zu dieser Eliteauswahl. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen bei der Auswahl des perfekten Tools hilft. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
9 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai












