


 Maison
Le laboratoire Tongyi d'Alibaba met Fun-CineForge en open source et relève le défi du doublage multilingue
Le doublage vocal traditionnel basé sur l'IA se révèle souvent insuffisant dans les productions à fort enjeu telles que les films et les animations, où il est primordial de saisir les nuances émotionnelles et d'assurer une synchronisation parfaite des mouvements des lèvres. Pour relever ce défi majeur du secteur, Tongyi Lab a officiellement lancé et mis en open source Fun-CineForge , un modèle de doublage multimodal révolutionnaire de qualité cinématographique, adapté à de multiples scénarios.
Combler le fossé audiovisuel : un cadre en quatre piliers pour une synchronisation parfaite
Plutôt que de s'appuyer sur une simple synthèse vocale, Fun-CineForge est conçu pour maîtriser quatre dimensions essentielles du doublage professionnel :
Synchronisation labiale : garantit que la parole synthétisée s'aligne avec une précision exceptionnelle sur les mouvements de la bouche des personnages à l'écran.
Expression émotionnelle : insuffle à la voix des émotions authentiques, semblables à celles d'un être humain, en analysant les expressions faciales et les instructions contextuelles.
Cohérence vocale : maintient une identité vocale stable et reconnaissable pour des personnages spécifiques dans des scènes de dialogue complexes impliquant plusieurs locuteurs.
Alignement temporel : permet l'insertion de dialogues avec une précision à la milliseconde près, même lorsque le locuteur est hors champ ou partiellement masqué.
Innovation fondamentale : la « modalité temporelle » pionnière et un ensemble de données haute fidélité
Le bond en avant technique de Fun-CineForge découle de sa philosophie unique de co-conception « données + modèle » :
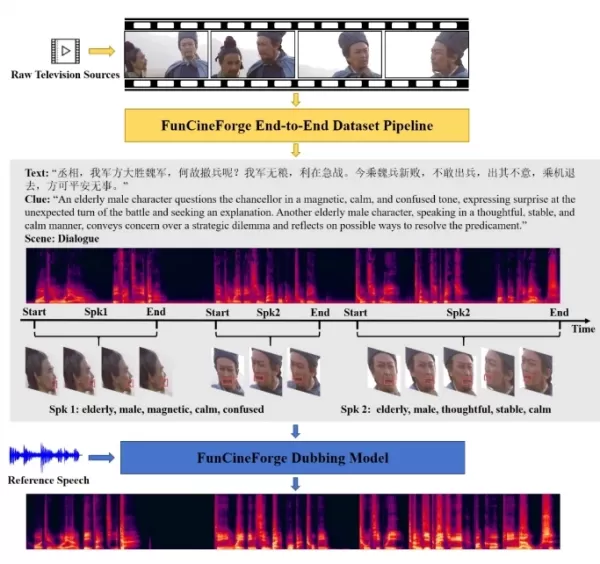
L'ensemble de données haute qualité CineDub : le laboratoire Tongyi a également mis en open source le pipeline automatisé de construction de l'ensemble de données CineDub. Grâce à un mécanisme de correction d'erreurs par chaîne de pensée, il réduit les taux d'erreurs de transcription pour les textes en chinois et en anglais à environ 1 % - 2 % et ramène les erreurs de diarisation des locuteurs à seulement 1,2 %.
Architecture de fusion à quatre modalités : le modèle est le premier à intégrer une « modalité temporelle », modélisant conjointement les entrées visuelles (forme des lèvres et expression), le texte (dialogue et contexte émotionnel) et l'audio (référence vocale). Cette fusion permet une synchronisation parfaite dans les scènes difficiles, y compris celles où les visages ne sont pas visibles.
Excellence démontrée : un doublage de dialogues à plusieurs personnages authentique et novateur
Les résultats des tests de performance montrent que Fun-CineForge surpasse largement les modèles de référence tels que DeepDubber-V1 sur des indicateurs clés : taux d'erreur sur les mots (WER/CER), synchronisation labiale (LSE-C/D) et similarité vocale. Une avancée majeure réside dans sa capacité unique à gérer avec précision les dialogues en duo et à plusieurs personnages, faisant preuve d'une robustesse remarquable sur des clips vidéo pouvant atteindre 30 secondes.
GitHub : https://github.com/FunAudioLLM/FunCineForge
HuggingFace : https://huggingface.co/FunAudioLLM/Fun-CineForge
ModelScope : https://www.modelscope.cn/models/FunAudioLLM/Fun-CineForge/
Article connexe
 PDG de DeepMind, Hassabis : Je dors six heures par jour et je me sens généralement plein d’énergie vers 1 h du matin.
Fortune a récemment publié une interview avec Demis Hassabis, PDG de Google DeepMind, révélant son approche non conventionnelle du repos et de la productivité. Hassabis a divulgué qu’il dort très peu, structurant ses heures d’éveil en deux blocs de t
OpenAI et Anthropic se disputent des parts de marché malgré des résultats en deçà des attentes
Bien que des informations récentes laissent entendre qu’OpenAI n’aurait pas atteint ses objectifs de chiffre d’affaires, ce qui a pesé sur les valeurs technologiques ce mardi, les investisseurs privés
Conformité des véhicules autonomes en Californie : une nouvelle ère marquée par les amendes, les zones de géolocalisation et 1 million de miles
Guident exploite une navette AuveTech dans le sud de la Floride, gérant un parcours de quatre miles à West Palm Beach et un parcours d’un mile à Boca Raton grâce à sa technologie de surveillance à dis
Recommandations de sujets spéciaux liés
Composition musicale
 Outils de séparation des pistes audio par IA pour la production de remix, la préparation de samples et les masters de karaoké
2026 : Les meilleures et plus récentes outils de séparation des pistes audio par IA, hautement notés, sélectionnés spécialement pour la production de remix, la préparation de samples et l’enregistrement de karaokés. Ces outils puissants et révolutionnaires, éprouvés dans des conditions réelles, permettent une isolation audio précise, ce qui améliore considérablement la productivité. XIX.AI propose un guide de comparaison gratuit mis à jour chaque semaine entre les versions payantes et gratuites, afin de vous aider à trouver la solution idéale adaptée à vos besoins. Découvrez-les dès maintenant pour tirer parti des avantages offerts par l’IA.
 8 outils
 xix.ai
Analyse des données
Copilotes SQL basés sur l’IA pour les tableaux de bord de chiffre d’affaires, l’analyse des funnels et les indicateurs de produits
2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
9 outils
xix.ai
Composition musicale
Meilleurs outils d’écriture de mélodies par IA pour les ébauches de chansons
2026 Derniers Meilleurs Outils d’Écriture de Mélodie par IA les Mieux Notés pour des Ébauches de Chansons ! XIX.AI a sélectionné une collection hautement puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles, afin d’offrir la meilleure expérience d’écriture. Vous pouvez y trouver des comparaisons détaillées entre versions gratuites et payantes, des classements précis, ainsi que des options incontournables conçues pour vous aider à créer sans effort des ébauches de chansons remarquables et à booster significativement votre productivité créative. Explorez dès maintenant pour découvrir l’outil qui vous correspond parfaitement !
8 outils
xix.ai
chatbot
Meilleurs outils d’entraînement à la conversation par IA pour la préparation aux entretiens
Les derniers outils de formation à la conversation par IA les mieux notés pour 2026 sont disponibles sur XIX.AI ! Cette sélection rigoureuse propose des outils puissants et révolutionnaires, testés rigoureusement dans des conditions réelles pour fournir des retours précis. Vous y trouverez une comparaison entre les versions gratuites et payantes, ainsi que des classements détaillés pour vous aider à choisir l’option incontournable qui renforce votre confiance et vos compétences. Explorez dès maintenant pour découvrir l’outil parfait pour réussir vos entretiens !
12 outils
xix.ai
Conception et art
Les meilleurs outils de transfert de style basés sur l'IA pour des expériences créatives
Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai
Création de bande dessinée
Les meilleurs outils d'IA pour créer des bulles de dialogue destinés à la narration visuelle
Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai

 commentaires (0)
Le doublage vocal traditionnel basé sur l'IA se révèle souvent insuffisant dans les productions à fort enjeu telles que les films et les animations, où il est primordial de saisir les nuances émotionnelles et d'assurer une synchronisation parfaite des mouvements des lèvres. Pour relever ce défi majeur du secteur, Tongyi Lab a officiellement lancé et mis en open source
Combler le fossé audiovisuel : un cadre en quatre piliers pour une synchronisation parfaite
Plutôt que de s'appuyer sur une simple synthèse vocale, Fun-CineForge est conçu pour maîtriser quatre dimensions essentielles du doublage professionnel :
Synchronisation labiale : garantit que la parole synthétisée s'aligne avec une précision exceptionnelle sur les mouvements de la bouche des personnages à l'écran.
Expression émotionnelle : insuffle à la voix des émotions authentiques, semblables à celles d'un être humain, en analysant les expressions faciales et les instructions contextuelles.
Cohérence vocale : maintient une identité vocale stable et reconnaissable pour des personnages spécifiques dans des scènes de dialogue complexes impliquant plusieurs locuteurs.
Alignement temporel : permet l'insertion de dialogues avec une précision à la milliseconde près, même lorsque le locuteur est hors champ ou partiellement masqué.
Innovation fondamentale : la « modalité temporelle » pionnière et un ensemble de données haute fidélité
Le bond en avant technique de Fun-CineForge découle de sa philosophie unique de co-conception « données + modèle » :
L'ensemble de données haute qualité CineDub : le laboratoire Tongyi a également mis en open source le pipeline automatisé de construction de l'ensemble de données CineDub. Grâce à un mécanisme de correction d'erreurs par chaîne de pensée, il réduit les taux d'erreurs de transcription pour les textes en chinois et en anglais à environ 1 % - 2 % et ramène les erreurs de diarisation des locuteurs à seulement 1,2 %.
Architecture de fusion à quatre modalités : le modèle est le premier à intégrer une « modalité temporelle », modélisant conjointement les entrées visuelles (forme des lèvres et expression), le texte (dialogue et contexte émotionnel) et l'audio (référence vocale). Cette fusion permet une synchronisation parfaite dans les scènes difficiles, y compris celles où les visages ne sont pas visibles.
Excellence démontrée : un doublage de dialogues à plusieurs personnages authentique et novateur
Les résultats des tests de performance montrent que Fun-CineForge surpasse largement les modèles de référence tels que DeepDubber-V1 sur des indicateurs clés : taux d'erreur sur les mots (WER/CER), synchronisation labiale (LSE-C/D) et similarité vocale. Une avancée majeure réside dans sa capacité unique à gérer avec précision les dialogues en duo et à plusieurs personnages, faisant preuve d'une robustesse remarquable sur des clips vidéo pouvant atteindre 30 secondes.
GitHub : https://github.com/FunAudioLLM/FunCineForge
HuggingFace : https://huggingface.co/FunAudioLLM/Fun-CineForge
ModelScope : https://www.modelscope.cn/models/FunAudioLLM/Fun-CineForge/








 PDG de DeepMind, Hassabis : Je dors six heures par jour et je me sens généralement plein d’énergie vers 1 h du matin.
Fortune a récemment publié une interview avec Demis Hassabis, PDG de Google DeepMind, révélant son approche non conventionnelle du repos et de la productivité. Hassabis a divulgué qu’il dort très peu, structurant ses heures d’éveil en deux blocs de t
 OpenAI et Anthropic se disputent des parts de marché malgré des résultats en deçà des attentes
Bien que des informations récentes laissent entendre qu’OpenAI n’aurait pas atteint ses objectifs de chiffre d’affaires, ce qui a pesé sur les valeurs technologiques ce mardi, les investisseurs privés
Conformité des véhicules autonomes en Californie : une nouvelle ère marquée par les amendes, les zones de géolocalisation et 1 million de miles
Guident exploite une navette AuveTech dans le sud de la Floride, gérant un parcours de quatre miles à West Palm Beach et un parcours d’un mile à Boca Raton grâce à sa technologie de surveillance à dis

2026 : Les meilleures et plus récentes outils de séparation des pistes audio par IA, hautement notés, sélectionnés spécialement pour la production de remix, la préparation de samples et l’enregistrement de karaokés. Ces outils puissants et révolutionnaires, éprouvés dans des conditions réelles, permettent une isolation audio précise, ce qui améliore considérablement la productivité. XIX.AI propose un guide de comparaison gratuit mis à jour chaque semaine entre les versions payantes et gratuites, afin de vous aider à trouver la solution idéale adaptée à vos besoins. Découvrez-les dès maintenant pour tirer parti des avantages offerts par l’IA.
8 outils
xix.ai

2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
9 outils
xix.ai

2026 Derniers Meilleurs Outils d’Écriture de Mélodie par IA les Mieux Notés pour des Ébauches de Chansons ! XIX.AI a sélectionné une collection hautement puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles, afin d’offrir la meilleure expérience d’écriture. Vous pouvez y trouver des comparaisons détaillées entre versions gratuites et payantes, des classements précis, ainsi que des options incontournables conçues pour vous aider à créer sans effort des ébauches de chansons remarquables et à booster significativement votre productivité créative. Explorez dès maintenant pour découvrir l’outil qui vous correspond parfaitement !
8 outils
xix.ai

Les derniers outils de formation à la conversation par IA les mieux notés pour 2026 sont disponibles sur XIX.AI ! Cette sélection rigoureuse propose des outils puissants et révolutionnaires, testés rigoureusement dans des conditions réelles pour fournir des retours précis. Vous y trouverez une comparaison entre les versions gratuites et payantes, ainsi que des classements détaillés pour vous aider à choisir l’option incontournable qui renforce votre confiance et vos compétences. Explorez dès maintenant pour découvrir l’outil parfait pour réussir vos entretiens !
12 outils
xix.ai

Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai

Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai












