


 Lar
A Tencent e a Tsinghua lançam o SongGeneration 2, com taxa de erro de 8,55%, intensificando a pressão sobre a Suno
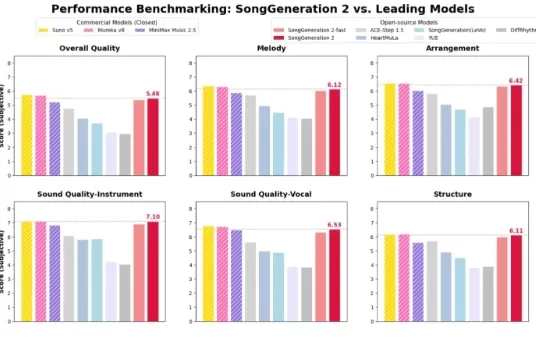
O cenário da música baseada em IA passou por outra mudança significativa no início de 2026. Em 9 de março, foi lançado oficialmente o modelo de base musical SongGeneration2, desenvolvido em parceria pela Tencent e pelo Laboratório de Interação Humano-Computador em Fala da Universidade de Tsinghua . Esse modelo não apenas representou um salto qualitativo na arquitetura técnica, mas também superou os modelos de código aberto mais difundidos atualmente em várias dimensões essenciais, chegando até a rivalizar com os principais modelos comerciais em termos de qualidade geral.
Três avanços: chega de música com IA “artificial”
As principais vantagens do SongGeneration2 derivam de uma atualização abrangente de sua arquitetura subjacente, que resolve três pontos críticos que atormentavam a música gerada por IA anteriormente:
Alta musicalidade: ao contrário do simples empilhamento de melodias, este modelo lida com arranjos complexos de múltiplas faixas com impressionante profundidade espacial.
Alta precisão nas letras: pronúncia pouco clara e mudanças de tom alucinadas agora são coisa do passado. Sua taxa de erro de fonema (PER) é de apenas 8,55%, superando notavelmente o modelo comercial líder Suno v5 (12,4%) e ficando atrás apenas do MiniMax2.5 .
Forte controlabilidade: seja por meio de descrições de texto ou comandos de áudio, ele segue as instruções com precisão, permitindo uma personalização profunda de estilo e emoção.
Impulso “Dual-Core”: uma colaboração dos sonhos entre modelos LLM e de difusão
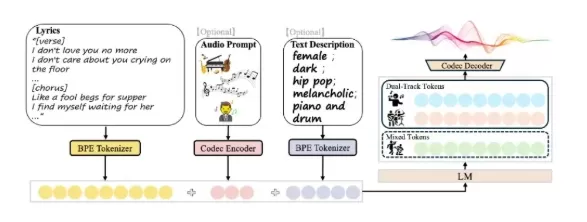
Em termos de arquitetura, o SongGeneration2 emprega uma inovadora arquitetura híbrida de LLM e difusão:
Composing Brain (LeLM): Lida com o planejamento da estrutura global e os detalhes vocais, resolvendo o desafio de “como cantar”.
Renderizador de alta fidelidade (difusão): sintetiza detalhes acústicos extremamente complexos sob a orientação do modelo de linguagem.
Representação hierárquica: O primeiro a adotar a modelagem paralela de representações mistas e multitrilha, equilibrando a estabilidade melódica com o refinamento da qualidade sonora.
Verdadeiro código aberto, baixo nível de dificuldade: computadores comuns também podem “compor músicas”
O que mais empolgou os desenvolvedores foi a notável abertura da Tencent. O modelo SongGeneration-v2-large, com 4 bilhões de parâmetros, agora é totalmente de código aberto, suportando geração multilíngue, incluindo chinês e inglês. Notavelmente, ele roda sem problemas em hardware de consumo com apenas 22 GB de VRAM, possibilitando a criação musical local e privada.
Para permitir que os usuários experimentem imediatamente, a equipe também lançou a versão SongGeneration-v2-Fast no HuggingFace, trocando uma queda mínima na qualidade de áudio por uma geração ultrarrápida — produzindo uma música completa em menos de um minuto.
Com base no desempenho do SongGeneration2 , a música gerada por IA evoluiu oficialmente de um “brinquedo de geeks” para o âmbito das “aplicações de nível comercial”. Com a próxima disponibilização em código aberto de um modelo Medium compatível com 12 GB de VRAM e uma estrutura de avaliação automatizada, a era em que todos se tornarão “compositores” pode finalmente estar chegando.
Artigo relacionado
 CEO da DeepMind, Hassabis: Durmo seis horas por dia, geralmente me sinto energético por volta da 1h
O Fortune recentemente publicou uma entrevista com Demis Hassabis, CEO da Google DeepMind, revelando sua abordagem incomum para descanso e produtividade. Hassabis revelou que dorme muito pouco, estruturando suas horas acordadas em dois blocos de trab
OpenAI e Anthropic disputam participação no mercado, apesar da queda na receita
Apesar de relatos recentes sugerirem que a OpenAI não atingiu suas metas de receita, o que gerou pressão sobre as ações do setor de tecnologia nesta terça-feira, os investidores privados em laboratóri
Conformidade com a regulamentação de veículos autônomos na Califórnia: uma nova era de multas, geocercas e 1 milhão de milhas
A Guident opera um veículo de transporte da AuveTech no sul da Flórida, administrando uma rota de quatro milhas em West Palm Beach e uma rota de uma milha em Boca Raton por meio de sua tecnologia de m
Recomendações de tópicos especiais relacionados
escrita
 Ferramentas de IA para esboço de artigos em formato longo
2026: As melhores e mais bem avaliadas ferramentas de esboço com IA para redação de textos longos! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que geram esboços precisos e estruturados, comprovados em testes reais, para aumentar significativamente a eficiência na redação. A XIX.AI faz parte dessa seleção de elite. Veja uma comparação entre as versões gratuita e paga para ajudá-lo a escolher a ferramenta perfeita. Explore agora e descubra sua vantagem com a IA!
 9 ferramentas
 xix.ai
chatbot
Melhores aplicativos de chat de interpretação de papéis com IA para prática de idiomas, preparação para entrevistas e fluência diária
2026 Últimas Melhores Aplicativos de Chat de Interpretação de Papéis por IA Mais Bem Avaliados para Prática de Idiomas, Preparação para Entrevistas e Fluência Diária! O XIX.AI seleciona uma poderosa coleção revolucionária que oferece comparação entre gratuito e pago, testes do mundo real e classificações atualizadas semanalmente. Essas ferramentas imperdíveis ajudam você a aprimorar suas habilidades de escrita, superar desafios de fluência e melhorar a eficiência da comunicação em todos os cenários diários. Explore agora para descobrir sua ferramenta perfeita para o crescimento do idioma!
10 ferramentas
xix.ai
Composição musical
Ferramentas de separação de stems com IA para produção de remixes, preparação de samples e masters de karaokê
As melhores e mais bem avaliadas ferramentas de separação de faixas com IA de 2026, selecionadas especialmente para produção de remixes, preparação de samples e masters de karaokê. Essas ferramentas poderosas e revolucionárias passaram por testes práticos para oferecer isolamento de áudio preciso, aumentando significativamente a produtividade. A XIX.AI oferece um guia comparativo entre versões gratuitas e pagas, atualizado semanalmente, para ajudá-lo a encontrar a solução imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Análise de dados
Copilotos de IA para SQL voltados para painéis de receita, análise de funis e métricas de produtos
2026: Os melhores copilotos AI para SQL, atualizados e classificados entre os melhores! A XIX.AI reúne uma coleção poderosa e revolucionária, com testes em ambiente real atualizados semanalmente. Essas ferramentas indispensáveis ajudam a gerar painéis de controle de receita precisos, analisar funis de vendas e rastrear métricas de produtos de forma rápida, aumentando significativamente a produtividade. Explore agora e encontre a ferramenta perfeita para tomada de decisões baseadas em dados! 238 caracteres
9 ferramentas
xix.ai
Composição musical
Melhores Ferramentas de IA para Criação de Melodias para Rascunhos de Músicas
2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai
chatbot
Melhores ferramentas de treinamento de conversação com IA para prática de entrevistas
As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai

 Comentários (0)
O cenário da música baseada em IA passou por outra mudança significativa no início de 2026. Em 9 de março, foi lançado oficialmente o modelo de base musical SongGeneration2, desenvolvido em parceria pela
Três avanços: chega de música com IA “artificial”
As principais vantagens do
Alta musicalidade: ao contrário do simples empilhamento de melodias, este modelo lida com arranjos complexos de múltiplas faixas com impressionante profundidade espacial.
Alta precisão nas letras: pronúncia pouco clara e mudanças de tom alucinadas agora são coisa do passado. Sua taxa de erro de fonema (PER) é de apenas 8,55%, superando notavelmente o modelo comercial líder
Forte controlabilidade: seja por meio de descrições de texto ou comandos de áudio, ele segue as instruções com precisão, permitindo uma personalização profunda de estilo e emoção.
Impulso “Dual-Core”: uma colaboração dos sonhos entre modelos LLM e de difusão
Em termos de arquitetura,
Composing Brain (LeLM): Lida com o planejamento da estrutura global e os detalhes vocais, resolvendo o desafio de “como cantar”.
Renderizador de alta fidelidade (difusão): sintetiza detalhes acústicos extremamente complexos sob a orientação do modelo de linguagem.
Representação hierárquica: O primeiro a adotar a modelagem paralela de representações mistas e multitrilha, equilibrando a estabilidade melódica com o refinamento da qualidade sonora.
Verdadeiro código aberto, baixo nível de dificuldade: computadores comuns também podem “compor músicas”
O que mais empolgou os desenvolvedores foi a notável abertura da Tencent. O modelo SongGeneration-v2-large, com 4 bilhões de parâmetros, agora é totalmente de código aberto, suportando geração multilíngue, incluindo chinês e inglês. Notavelmente, ele roda sem problemas em hardware de consumo com apenas 22 GB de VRAM, possibilitando a criação musical local e privada.
Para permitir que os usuários experimentem imediatamente, a equipe também lançou a versão SongGeneration-v2-Fast no HuggingFace, trocando uma queda mínima na qualidade de áudio por uma geração ultrarrápida — produzindo uma música completa em menos de um minuto.
Com base no desempenho do








 CEO da DeepMind, Hassabis: Durmo seis horas por dia, geralmente me sinto energético por volta da 1h
O Fortune recentemente publicou uma entrevista com Demis Hassabis, CEO da Google DeepMind, revelando sua abordagem incomum para descanso e produtividade. Hassabis revelou que dorme muito pouco, estruturando suas horas acordadas em dois blocos de trab
 OpenAI e Anthropic disputam participação no mercado, apesar da queda na receita
Apesar de relatos recentes sugerirem que a OpenAI não atingiu suas metas de receita, o que gerou pressão sobre as ações do setor de tecnologia nesta terça-feira, os investidores privados em laboratóri
Conformidade com a regulamentação de veículos autônomos na Califórnia: uma nova era de multas, geocercas e 1 milhão de milhas
A Guident opera um veículo de transporte da AuveTech no sul da Flórida, administrando uma rota de quatro milhas em West Palm Beach e uma rota de uma milha em Boca Raton por meio de sua tecnologia de m

2026: As melhores e mais bem avaliadas ferramentas de esboço com IA para redação de textos longos! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que geram esboços precisos e estruturados, comprovados em testes reais, para aumentar significativamente a eficiência na redação. A XIX.AI faz parte dessa seleção de elite. Veja uma comparação entre as versões gratuita e paga para ajudá-lo a escolher a ferramenta perfeita. Explore agora e descubra sua vantagem com a IA!
9 ferramentas
xix.ai

2026 Últimas Melhores Aplicativos de Chat de Interpretação de Papéis por IA Mais Bem Avaliados para Prática de Idiomas, Preparação para Entrevistas e Fluência Diária! O XIX.AI seleciona uma poderosa coleção revolucionária que oferece comparação entre gratuito e pago, testes do mundo real e classificações atualizadas semanalmente. Essas ferramentas imperdíveis ajudam você a aprimorar suas habilidades de escrita, superar desafios de fluência e melhorar a eficiência da comunicação em todos os cenários diários. Explore agora para descobrir sua ferramenta perfeita para o crescimento do idioma!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de separação de faixas com IA de 2026, selecionadas especialmente para produção de remixes, preparação de samples e masters de karaokê. Essas ferramentas poderosas e revolucionárias passaram por testes práticos para oferecer isolamento de áudio preciso, aumentando significativamente a produtividade. A XIX.AI oferece um guia comparativo entre versões gratuitas e pagas, atualizado semanalmente, para ajudá-lo a encontrar a solução imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

2026: Os melhores copilotos AI para SQL, atualizados e classificados entre os melhores! A XIX.AI reúne uma coleção poderosa e revolucionária, com testes em ambiente real atualizados semanalmente. Essas ferramentas indispensáveis ajudam a gerar painéis de controle de receita precisos, analisar funis de vendas e rastrear métricas de produtos de forma rápida, aumentando significativamente a produtividade. Explore agora e encontre a ferramenta perfeita para tomada de decisões baseadas em dados! 238 caracteres
9 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai

As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai












