


 Maison
Tencent et Tsinghua lancent SongGeneration 2, avec un taux d'erreur de 8,55 %, ce qui accentue la pression sur Suno
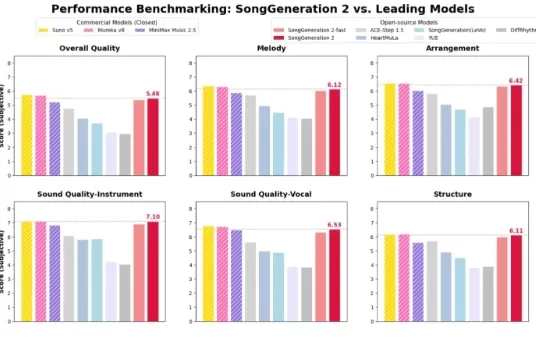
Le paysage de la musique générée par l'IA a connu un nouveau tournant majeur début 2026. Le 9 mars, le modèle de base musical SongGeneration2, développé conjointement par Tencent et le laboratoire d'interaction homme-machine en synthèse vocale de l'université de Tsinghua , a été officiellement lancé. Ce modèle a non seulement marqué un bond qualitatif en matière d’architecture technique, mais il a également surpassé les modèles open source courants sur plusieurs aspects essentiels, rivalisant même avec les meilleurs modèles commerciaux en termes de qualité globale.
Trois avancées majeures : finie la musique IA « artificielle »
Les principaux atouts de SongGeneration2 découlent d’une mise à niveau complète de son architecture sous-jacente, qui résout trois problèmes majeurs qui affectaient la musique générée par l’IA jusqu’à présent :
Une musicalité élevée : contrairement au simple empilement de mélodies, ce modèle gère des arrangements multipistes complexes avec une profondeur spatiale impressionnante.
Précision élevée des paroles : la prononciation imprécise et les variations de hauteur de son fantomatiques appartiennent désormais au passé. Son taux d’erreur phonémique (PER) n’est que de 8,55 %, surpassant nettement le modèle commercial de référence Suno v5 (12,4 %) et n’étant devancé que par MiniMax2.5 .
Grande contrôlabilité : que ce soit par le biais de descriptions textuelles ou de consignes audio, il suit les instructions avec précision, permettant une personnalisation approfondie du style et des émotions.
Moteur « Dual-Core » : une collaboration de rêve entre les modèles LLM et les modèles de diffusion
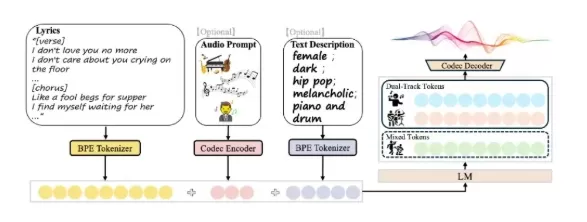
Sur le plan architectural, SongGeneration2 utilise une architecture hybride innovante combinant LLM et diffusion :
Composing Brain (LeLM) : gère la planification de la structure globale et les détails vocaux, résolvant ainsi le défi de « comment chanter ».
Renderer haute fidélité (diffusion) : synthétise des détails acoustiques extrêmement complexes sous la direction du modèle linguistique.
Représentation hiérarchique : le premier à adopter la modélisation parallèle de représentations mixtes et multipistes, conciliant la stabilité mélodique et le raffinement de la qualité sonore.
Véritable open source, accessible à tous : même les ordinateurs ordinaires peuvent désormais « composer des chansons »
Ce qui a le plus enthousiasmé les développeurs, c’est la remarquable ouverture d’esprit de Tencent. Le modèle SongGeneration-v2-large, doté de 4 milliards de paramètres, est désormais entièrement open source et prend en charge la génération multilingue, notamment en chinois et en anglais. Fait remarquable, il fonctionne sans problème sur du matériel grand public disposant de seulement 22 Go de VRAM, ce qui permet la création musicale locale et privée.
Pour permettre aux utilisateurs de l’essayer immédiatement, l’équipe a également publié la version SongGeneration-v2-Fast sur HuggingFace, qui sacrifie une légère baisse de la qualité audio au profit d’une génération ultra-rapide — produisant une chanson complète en moins d’une minute.
Au vu des performances de SongGeneration2 , la musique générée par IA est officiellement passée du statut de « jouet de geek » à celui d’« application de niveau commercial ». Avec la mise en open source prochaine d’un modèle Medium prenant en charge 12 Go de VRAM et d’un cadre d’évaluation automatisé, l’ère où chacun pourra devenir « compositeur » pourrait bien être enfin à nos portes.
Article connexe
 Meta supprime la fonction de retouche photo par IA suite aux critiques des utilisateurs
Meta, le géant des réseaux sociaux, est une fois de plus au cœur d’un débat public concernant l’équilibre délicat entre l’intelligence artificielle et la vie privée des utilisateurs. Selon TechCrunch, les Superintelligence Labs de Meta ont présenté u
PDG de DeepMind, Hassabis : Je dors six heures par jour et je me sens généralement plein d’énergie vers 1 h du matin.
Fortune a récemment publié une interview avec Demis Hassabis, PDG de Google DeepMind, révélant son approche non conventionnelle du repos et de la productivité. Hassabis a divulgué qu’il dort très peu, structurant ses heures d’éveil en deux blocs de t
OpenAI et Anthropic se disputent des parts de marché malgré des résultats en deçà des attentes
Bien que des informations récentes laissent entendre qu’OpenAI n’aurait pas atteint ses objectifs de chiffre d’affaires, ce qui a pesé sur les valeurs technologiques ce mardi, les investisseurs privés
Recommandations de sujets spéciaux liés
Création vidéo
 Générateurs d'accroches pour vidéos courtes basés sur l'IA, destinés aux Reels, aux Shorts et aux campagnes de lancement de produits
Les meilleurs générateurs de accroches pour vidéos courtes basées sur l'IA en 2026 : pour Reels, Shorts et campagnes de lancement de produits ! XIX.AI sélectionne les outils les mieux notés, puissants et révolutionnaires, qui offrent des résultats incontournables grâce à des tests en conditions réelles. Cette page, mise à jour chaque semaine, propose des classements comparatifs entre les solutions gratuites et payantes pour vous aider à trouver la solution idéale afin de booster votre créativité et votre productivité en matière de contenu. Découvrez-la dès maintenant pour exploiter pleinement le potentiel de l’IA !
 11 outils
 xix.ai
en écrivant
Outils d'IA pour la structuration d'articles destinés à la rédaction de textes longs
2026 : les meilleurs outils d'aide à la rédaction de plans pour les textes longs, sélectionnés parmi les mieux notés ! Cette sélection rigoureuse regroupe des outils puissants et révolutionnaires qui fournissent des plans précis et structurés, validés par des tests concrets, afin d'améliorer considérablement l'efficacité de la rédaction. XIX.AI fait partie de cette sélection d'élite. Consultez notre comparatif entre les versions gratuites et payantes pour vous aider à choisir l'outil idéal. Découvrez-les dès maintenant et tirez parti de l'IA !
9 outils
xix.ai
chatbot
Meilleures applications de chat de jeu de rôle par IA pour la pratique des langues, la préparation aux entretiens et la fluidité quotidienne
2026 Dernières Meilleures Applications de Chat IA pour le Jeu de Rôle, les plus bien notées pour la Pratique des Langues, la Préparation aux Entretiens et la Fluidité Quotidienne ! XIX.AI sélectionne une collection puissante et révolutionnaire qui propose une comparaison gratuit vs payant, des tests en conditions réelles et des classements mis à jour chaque semaine. Ces outils à essayer absolument vous aident à améliorer vos compétences en écriture, à surmonter les défis de fluidité et à optimiser l’efficacité de la communication dans tous les scénarios quotidiens. Explorez dès maintenant pour découvrir l’outil parfait pour votre progression linguistique !
10 outils
xix.ai
Composition musicale
Outils de séparation des pistes audio par IA pour la production de remix, la préparation de samples et les masters de karaoké
2026 : Les meilleures et plus récentes outils de séparation des pistes audio par IA, hautement notés, sélectionnés spécialement pour la production de remix, la préparation de samples et l’enregistrement de karaokés. Ces outils puissants et révolutionnaires, éprouvés dans des conditions réelles, permettent une isolation audio précise, ce qui améliore considérablement la productivité. XIX.AI propose un guide de comparaison gratuit mis à jour chaque semaine entre les versions payantes et gratuites, afin de vous aider à trouver la solution idéale adaptée à vos besoins. Découvrez-les dès maintenant pour tirer parti des avantages offerts par l’IA.
8 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l’IA pour les tableaux de bord de chiffre d’affaires, l’analyse des funnels et les indicateurs de produits
2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
9 outils
xix.ai
Composition musicale
Meilleurs outils d’écriture de mélodies par IA pour les ébauches de chansons
2026 Derniers Meilleurs Outils d’Écriture de Mélodie par IA les Mieux Notés pour des Ébauches de Chansons ! XIX.AI a sélectionné une collection hautement puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles, afin d’offrir la meilleure expérience d’écriture. Vous pouvez y trouver des comparaisons détaillées entre versions gratuites et payantes, des classements précis, ainsi que des options incontournables conçues pour vous aider à créer sans effort des ébauches de chansons remarquables et à booster significativement votre productivité créative. Explorez dès maintenant pour découvrir l’outil qui vous correspond parfaitement !
8 outils
xix.ai

 commentaires (0)
Le paysage de la musique générée par l'IA a connu un nouveau tournant majeur début 2026. Le 9 mars, le modèle de base musical SongGeneration2, développé conjointement par
Trois avancées majeures : finie la musique IA « artificielle »
Les principaux atouts de
Une musicalité élevée : contrairement au simple empilement de mélodies, ce modèle gère des arrangements multipistes complexes avec une profondeur spatiale impressionnante.
Précision élevée des paroles : la prononciation imprécise et les variations de hauteur de son fantomatiques appartiennent désormais au passé. Son taux d’erreur phonémique (PER) n’est que de 8,55 %, surpassant nettement le modèle commercial de référence
Grande contrôlabilité : que ce soit par le biais de descriptions textuelles ou de consignes audio, il suit les instructions avec précision, permettant une personnalisation approfondie du style et des émotions.
Moteur « Dual-Core » : une collaboration de rêve entre les modèles LLM et les modèles de diffusion
Sur le plan architectural,
Composing Brain (LeLM) : gère la planification de la structure globale et les détails vocaux, résolvant ainsi le défi de « comment chanter ».
Renderer haute fidélité (diffusion) : synthétise des détails acoustiques extrêmement complexes sous la direction du modèle linguistique.
Représentation hiérarchique : le premier à adopter la modélisation parallèle de représentations mixtes et multipistes, conciliant la stabilité mélodique et le raffinement de la qualité sonore.
Véritable open source, accessible à tous : même les ordinateurs ordinaires peuvent désormais « composer des chansons »
Ce qui a le plus enthousiasmé les développeurs, c’est la remarquable ouverture d’esprit de Tencent. Le modèle SongGeneration-v2-large, doté de 4 milliards de paramètres, est désormais entièrement open source et prend en charge la génération multilingue, notamment en chinois et en anglais. Fait remarquable, il fonctionne sans problème sur du matériel grand public disposant de seulement 22 Go de VRAM, ce qui permet la création musicale locale et privée.
Pour permettre aux utilisateurs de l’essayer immédiatement, l’équipe a également publié la version SongGeneration-v2-Fast sur HuggingFace, qui sacrifie une légère baisse de la qualité audio au profit d’une génération ultra-rapide — produisant une chanson complète en moins d’une minute.
Au vu des performances de








 Meta supprime la fonction de retouche photo par IA suite aux critiques des utilisateurs
Meta, le géant des réseaux sociaux, est une fois de plus au cœur d’un débat public concernant l’équilibre délicat entre l’intelligence artificielle et la vie privée des utilisateurs. Selon TechCrunch, les Superintelligence Labs de Meta ont présenté u
 PDG de DeepMind, Hassabis : Je dors six heures par jour et je me sens généralement plein d’énergie vers 1 h du matin.
Fortune a récemment publié une interview avec Demis Hassabis, PDG de Google DeepMind, révélant son approche non conventionnelle du repos et de la productivité. Hassabis a divulgué qu’il dort très peu, structurant ses heures d’éveil en deux blocs de t
 OpenAI et Anthropic se disputent des parts de marché malgré des résultats en deçà des attentes
Bien que des informations récentes laissent entendre qu’OpenAI n’aurait pas atteint ses objectifs de chiffre d’affaires, ce qui a pesé sur les valeurs technologiques ce mardi, les investisseurs privés

Les meilleurs générateurs de accroches pour vidéos courtes basées sur l'IA en 2026 : pour Reels, Shorts et campagnes de lancement de produits ! XIX.AI sélectionne les outils les mieux notés, puissants et révolutionnaires, qui offrent des résultats incontournables grâce à des tests en conditions réelles. Cette page, mise à jour chaque semaine, propose des classements comparatifs entre les solutions gratuites et payantes pour vous aider à trouver la solution idéale afin de booster votre créativité et votre productivité en matière de contenu. Découvrez-la dès maintenant pour exploiter pleinement le potentiel de l’IA !
11 outils
xix.ai

2026 : les meilleurs outils d'aide à la rédaction de plans pour les textes longs, sélectionnés parmi les mieux notés ! Cette sélection rigoureuse regroupe des outils puissants et révolutionnaires qui fournissent des plans précis et structurés, validés par des tests concrets, afin d'améliorer considérablement l'efficacité de la rédaction. XIX.AI fait partie de cette sélection d'élite. Consultez notre comparatif entre les versions gratuites et payantes pour vous aider à choisir l'outil idéal. Découvrez-les dès maintenant et tirez parti de l'IA !
9 outils
xix.ai

2026 Dernières Meilleures Applications de Chat IA pour le Jeu de Rôle, les plus bien notées pour la Pratique des Langues, la Préparation aux Entretiens et la Fluidité Quotidienne ! XIX.AI sélectionne une collection puissante et révolutionnaire qui propose une comparaison gratuit vs payant, des tests en conditions réelles et des classements mis à jour chaque semaine. Ces outils à essayer absolument vous aident à améliorer vos compétences en écriture, à surmonter les défis de fluidité et à optimiser l’efficacité de la communication dans tous les scénarios quotidiens. Explorez dès maintenant pour découvrir l’outil parfait pour votre progression linguistique !
10 outils
xix.ai

2026 : Les meilleures et plus récentes outils de séparation des pistes audio par IA, hautement notés, sélectionnés spécialement pour la production de remix, la préparation de samples et l’enregistrement de karaokés. Ces outils puissants et révolutionnaires, éprouvés dans des conditions réelles, permettent une isolation audio précise, ce qui améliore considérablement la productivité. XIX.AI propose un guide de comparaison gratuit mis à jour chaque semaine entre les versions payantes et gratuites, afin de vous aider à trouver la solution idéale adaptée à vos besoins. Découvrez-les dès maintenant pour tirer parti des avantages offerts par l’IA.
8 outils
xix.ai

2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
9 outils
xix.ai

2026 Derniers Meilleurs Outils d’Écriture de Mélodie par IA les Mieux Notés pour des Ébauches de Chansons ! XIX.AI a sélectionné une collection hautement puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles, afin d’offrir la meilleure expérience d’écriture. Vous pouvez y trouver des comparaisons détaillées entre versions gratuites et payantes, des classements précis, ainsi que des options incontournables conçues pour vous aider à créer sans effort des ébauches de chansons remarquables et à booster significativement votre productivité créative. Explorez dès maintenant pour découvrir l’outil qui vous correspond parfaitement !
8 outils
xix.ai












