


 Hogar
Tencent y Tsinghua lanzan SongGeneration 2, con una tasa de error del 8,55 %, lo que intensifica la presión sobre Suno
El panorama de la música generada por IA experimentó otro cambio significativo a principios de 2026. El 9 de marzo se presentó oficialmente el modelo base musical SongGeneration2, desarrollado conjuntamente por Tencent y el Laboratorio de Interacción Voz-Ordenador de la Universidad de Tsinghua . Este modelo no solo supuso un salto cualitativo en la arquitectura técnica, sino que también superó a los modelos de código abierto más extendidos actualmente en múltiples aspectos fundamentales, llegando incluso a rivalizar con los mejores modelos comerciales en cuanto a calidad general.
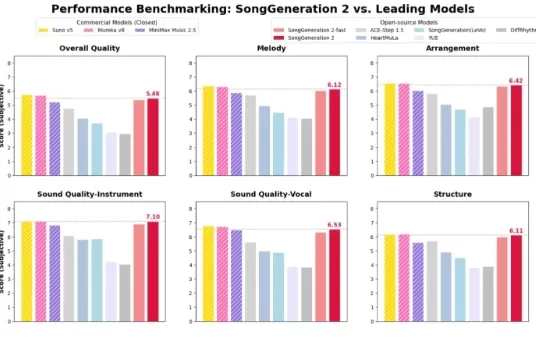
Tres avances decisivos: se acabó la música generada por IA «artificial»
Las principales ventajas de SongGeneration2 provienen de una actualización integral de su arquitectura subyacente, que aborda tres puntos débiles clave que afectaban a la música generada por IA anteriormente:
Alta musicalidad: a diferencia de la simple superposición de melodías, este modelo gestiona arreglos complejos de varias pistas con una profundidad espacial impresionante.
Alta precisión en las letras: la pronunciación poco clara y los cambios de tono «alucinados» ya son cosa del pasado. Su tasa de error de fonemas (PER) es de tan solo el 8,55 %, superando notablemente al modelo comercial líder, Suno v5 (12,4 %), y solo por detrás de MiniMax2.5 .
Gran capacidad de control: ya sea a través de descripciones de texto o indicaciones de audio, sigue las instrucciones con precisión, lo que permite una personalización profunda del estilo y la emoción.
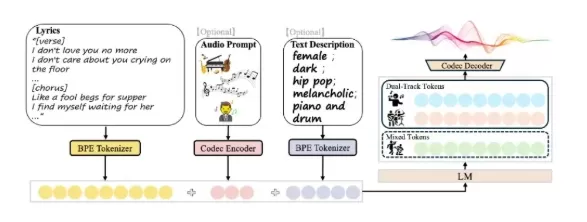
Impulso «Dual-Core»: una colaboración de ensueño entre los modelos LLM y de difusión
Desde el punto de vista arquitectónico, SongGeneration2 emplea una innovadora arquitectura híbrida de LLM y difusión:
Composing Brain (LeLM): se encarga de la planificación de la estructura global y de los detalles vocales, resolviendo el reto de «cómo cantar».
Renderizador de alta fidelidad (difusión): sintetiza detalles acústicos extremadamente complejos bajo la guía del modelo de lenguaje.
Representación jerárquica: es el primero en adoptar el modelado paralelo de representaciones mixtas y multipista, equilibrando la estabilidad melódica con el refinamiento de la calidad del sonido.
Verdadero código abierto, fácil acceso: incluso los ordenadores normales pueden «escribir canciones»
Lo que más entusiasmó a los desarrolladores fue la notable apertura de Tencent. El modelo SongGeneration-v2-large, con 4.000 millones de parámetros, es ahora totalmente de código abierto y admite la generación multilingüe, incluyendo el chino y el inglés. Sorprendentemente, funciona a la perfección en hardware de consumo con tan solo 22 GB de VRAM, lo que permite la creación musical local y privada.
Para que los usuarios puedan probarlo de inmediato, el equipo también ha lanzado la versión SongGeneration-v2-Fast en HuggingFace, que sacrifica una mínima pérdida de calidad de audio a cambio de una generación ultrarrápida, capaz de producir una canción completa en menos de un minuto.
A juzgar por el rendimiento de SongGeneration2 , la música generada por IA ha pasado oficialmente de ser un «juguete para frikis» a entrar en el ámbito de las «aplicaciones de nivel comercial». Con la próxima publicación en código abierto de un modelo Medium compatible con 12 GB de VRAM y un marco de evaluación automatizado, la era en la que todo el mundo se convierta en «compositor» podría estar finalmente a la vuelta de la esquina.
Artículo relacionado
 CEO de DeepMind, Hassabis: Duermo seis horas al día y generalmente me siento con energía alrededor de la 1 a. m.
Fortune ha presentado recientemente una entrevista con Demis Hassabis, director ejecutivo de Google DeepMind, en la que revela su enfoque poco convencional para el descanso y la productividad. Hassabis ha revelado que duerme muy poco, estructurando s
OpenAI y Anthropic compiten por la cuota de mercado a pesar de la caída de los ingresos
A pesar de los recientes informes que sugieren que OpenAI no ha alcanzado sus objetivos de ingresos —lo que ha generado presión sobre las acciones tecnológicas este martes—, los inversores privados en
Cumplimiento de la normativa sobre vehículos autónomos en California: una nueva era de multas, geovallas y 1 millón de millas
Guident opera un servicio de transporte de AuveTech en el sur de Florida, gestionando una ruta de cuatro millas en West Palm Beach y otra de una milla en Boca Ratón mediante su tecnología de monitoriz
Recomendaciones de temas especiales relacionados
Creación de vídeos
 Generadores de ganchos para vídeos cortos basados en IA, para Reels, Shorts y campañas de lanzamiento de productos
¡Los mejores generadores de ganchos para vídeos cortos con IA de 2026 para Reels, Shorts y campañas de lanzamiento de productos! XIX.AI selecciona las herramientas más valoradas, potentes y revolucionarias que ofrecen resultados que no te puedes perder, contrastados mediante pruebas en el mundo real. Esta página, que se actualiza semanalmente, ofrece clasificaciones comparativas entre opciones gratuitas y de pago para ayudarte a encontrar la solución perfecta con la que potenciar la creatividad y la productividad en la creación de contenidos. ¡Explórala ahora y descubre tu ventaja con la IA!
 11 herramientas
 xix.ai
escribiendo
Herramientas de IA para la estructura de artículos en la redacción de textos extensos
¡Las mejores herramientas de 2026 para crear esquemas de artículos con IA, mejor valoradas para la redacción de textos largos! Esta selección incluye potentes herramientas revolucionarias que ofrecen esquemas precisos y estructurados, probados en la práctica, para aumentar significativamente la eficiencia en la redacción. XIX.AI forma parte de esta selección de élite. Consigue una comparación entre las versiones gratuitas y de pago que te ayudará a elegir la herramienta perfecta. ¡Explora ahora y aprovecha tu ventaja con la IA!
9 herramientas
xix.ai
chatbot
Las mejores aplicaciones de chat de roleplay con IA para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria
¡Las mejores aplicaciones de chat de roleplay con IA de 2026, mejor valoradas, para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria! XIX.AI selecciona una poderosa colección revolucionaria que ofrece comparaciones entre versiones gratuitas y de pago, pruebas del mundo real y clasificaciones actualizadas semanalmente. Estas herramientas imprescindibles te ayudan a mejorar tus habilidades de escritura, superar los desafíos de fluidez y aumentar la eficiencia comunicativa en todas las situaciones cotidianas. ¡Explora ahora para descubrir tu herramienta perfecta para el crecimiento lingüístico!
10 herramientas
xix.ai
composicion musical
Herramientas de separación de pistas con IA para la producción de remezclas, la preparación de samples y las pistas maestras de karaoke
Las mejores herramientas de separación de pistas con IA de 2026, seleccionadas para la producción de remixes, la preparación de samples y la creación de temas de karaoke. Estas potentes herramientas revolucionarias se han sometido a pruebas en condiciones reales para ofrecer un aislamiento de audio preciso, lo que aumenta significativamente la productividad. XIX.AI ofrece una guía comparativa entre versiones gratuitas y de pago, actualizada semanalmente, para ayudarte a encontrar la solución imprescindible que mejor se adapte a tus necesidades. Explórala ahora para sacar el máximo partido a la IA.
8 herramientas
xix.ai
Análisis de datos
Copilotos de AI para SQL destinados a paneles de ingresos, análisis de embudos y métricas de productos
¡Los mejores copilotos de SQL basados en IA de 2026, clasificados entre los más destacados! XIX.AI reúne una poderosa colección que evoluciona constantemente, con pruebas en el mundo real actualizadas semanalmente. Estas herramientas indispensables le permiten generar paneles de control de ingresos precisos, analizar los canales de venta y seguir de cerca las métricas de los productos de manera rápida, lo que aumenta significativamente su productividad. ¡Explórelas ahora para encontrar la herramienta perfecta para tomar decisiones basadas en datos! 238 caracteres
9 herramientas
xix.ai
composicion musical
Mejores herramientas de IA para escribir melodías en borradores de canciones
2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai

 comentario (0)
0/500
El panorama de la música generada por IA experimentó otro cambio significativo a principios de 2026. El 9 de marzo se presentó oficialmente el modelo base musical SongGeneration2, desarrollado conjuntamente por
Tres avances decisivos: se acabó la música generada por IA «artificial»
Las principales ventajas de
Alta musicalidad: a diferencia de la simple superposición de melodías, este modelo gestiona arreglos complejos de varias pistas con una profundidad espacial impresionante.
Alta precisión en las letras: la pronunciación poco clara y los cambios de tono «alucinados» ya son cosa del pasado. Su tasa de error de fonemas (PER) es de tan solo el 8,55 %, superando notablemente al modelo comercial líder,
Gran capacidad de control: ya sea a través de descripciones de texto o indicaciones de audio, sigue las instrucciones con precisión, lo que permite una personalización profunda del estilo y la emoción.
Impulso «Dual-Core»: una colaboración de ensueño entre los modelos LLM y de difusión
Desde el punto de vista arquitectónico,
Composing Brain (LeLM): se encarga de la planificación de la estructura global y de los detalles vocales, resolviendo el reto de «cómo cantar».
Renderizador de alta fidelidad (difusión): sintetiza detalles acústicos extremadamente complejos bajo la guía del modelo de lenguaje.
Representación jerárquica: es el primero en adoptar el modelado paralelo de representaciones mixtas y multipista, equilibrando la estabilidad melódica con el refinamiento de la calidad del sonido.
Verdadero código abierto, fácil acceso: incluso los ordenadores normales pueden «escribir canciones»
Lo que más entusiasmó a los desarrolladores fue la notable apertura de Tencent. El modelo SongGeneration-v2-large, con 4.000 millones de parámetros, es ahora totalmente de código abierto y admite la generación multilingüe, incluyendo el chino y el inglés. Sorprendentemente, funciona a la perfección en hardware de consumo con tan solo 22 GB de VRAM, lo que permite la creación musical local y privada.
Para que los usuarios puedan probarlo de inmediato, el equipo también ha lanzado la versión SongGeneration-v2-Fast en HuggingFace, que sacrifica una mínima pérdida de calidad de audio a cambio de una generación ultrarrápida, capaz de producir una canción completa en menos de un minuto.
A juzgar por el rendimiento de








 CEO de DeepMind, Hassabis: Duermo seis horas al día y generalmente me siento con energía alrededor de la 1 a. m.
Fortune ha presentado recientemente una entrevista con Demis Hassabis, director ejecutivo de Google DeepMind, en la que revela su enfoque poco convencional para el descanso y la productividad. Hassabis ha revelado que duerme muy poco, estructurando s
 OpenAI y Anthropic compiten por la cuota de mercado a pesar de la caída de los ingresos
A pesar de los recientes informes que sugieren que OpenAI no ha alcanzado sus objetivos de ingresos —lo que ha generado presión sobre las acciones tecnológicas este martes—, los inversores privados en
Cumplimiento de la normativa sobre vehículos autónomos en California: una nueva era de multas, geovallas y 1 millón de millas
Guident opera un servicio de transporte de AuveTech en el sur de Florida, gestionando una ruta de cuatro millas en West Palm Beach y otra de una milla en Boca Ratón mediante su tecnología de monitoriz

¡Los mejores generadores de ganchos para vídeos cortos con IA de 2026 para Reels, Shorts y campañas de lanzamiento de productos! XIX.AI selecciona las herramientas más valoradas, potentes y revolucionarias que ofrecen resultados que no te puedes perder, contrastados mediante pruebas en el mundo real. Esta página, que se actualiza semanalmente, ofrece clasificaciones comparativas entre opciones gratuitas y de pago para ayudarte a encontrar la solución perfecta con la que potenciar la creatividad y la productividad en la creación de contenidos. ¡Explórala ahora y descubre tu ventaja con la IA!
11 herramientas
xix.ai

¡Las mejores herramientas de 2026 para crear esquemas de artículos con IA, mejor valoradas para la redacción de textos largos! Esta selección incluye potentes herramientas revolucionarias que ofrecen esquemas precisos y estructurados, probados en la práctica, para aumentar significativamente la eficiencia en la redacción. XIX.AI forma parte de esta selección de élite. Consigue una comparación entre las versiones gratuitas y de pago que te ayudará a elegir la herramienta perfecta. ¡Explora ahora y aprovecha tu ventaja con la IA!
9 herramientas
xix.ai

¡Las mejores aplicaciones de chat de roleplay con IA de 2026, mejor valoradas, para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria! XIX.AI selecciona una poderosa colección revolucionaria que ofrece comparaciones entre versiones gratuitas y de pago, pruebas del mundo real y clasificaciones actualizadas semanalmente. Estas herramientas imprescindibles te ayudan a mejorar tus habilidades de escritura, superar los desafíos de fluidez y aumentar la eficiencia comunicativa en todas las situaciones cotidianas. ¡Explora ahora para descubrir tu herramienta perfecta para el crecimiento lingüístico!
10 herramientas
xix.ai

Las mejores herramientas de separación de pistas con IA de 2026, seleccionadas para la producción de remixes, la preparación de samples y la creación de temas de karaoke. Estas potentes herramientas revolucionarias se han sometido a pruebas en condiciones reales para ofrecer un aislamiento de audio preciso, lo que aumenta significativamente la productividad. XIX.AI ofrece una guía comparativa entre versiones gratuitas y de pago, actualizada semanalmente, para ayudarte a encontrar la solución imprescindible que mejor se adapte a tus necesidades. Explórala ahora para sacar el máximo partido a la IA.
8 herramientas
xix.ai

¡Los mejores copilotos de SQL basados en IA de 2026, clasificados entre los más destacados! XIX.AI reúne una poderosa colección que evoluciona constantemente, con pruebas en el mundo real actualizadas semanalmente. Estas herramientas indispensables le permiten generar paneles de control de ingresos precisos, analizar los canales de venta y seguir de cerca las métricas de los productos de manera rápida, lo que aumenta significativamente su productividad. ¡Explórelas ahora para encontrar la herramienta perfecta para tomar decisiones basadas en datos! 238 caracteres
9 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai












