


 Heim
Tencent und Tsinghua bringen „SongGeneration 2“ mit einer Fehlerquote von 8,55 % auf den Markt und verstärken damit den Druck auf Suno
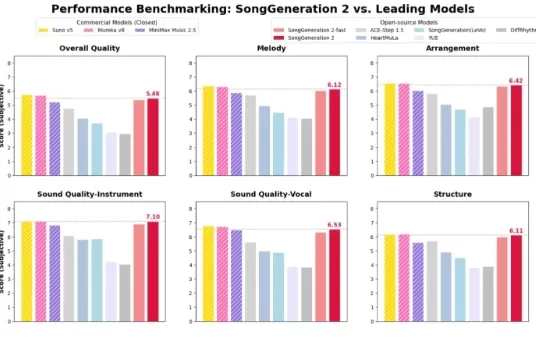
Anfang 2026 erlebte die KI-Musikbranche einen weiteren bedeutenden Wandel. Am 9. März wurde das Musik-Grundmodell „SongGeneration2“, das gemeinsam von Tencent und dem Human-Computer Speech Interaction Lab der Tsinghua-Universität entwickelt wurde, offiziell vorgestellt. Dieses Modell stellte nicht nur einen qualitativen Sprung in der technischen Architektur dar, sondern übertraf auch die derzeit gängigen Open-Source-Modelle in mehreren Kernbereichen und konnte in puncto Gesamtqualität sogar mit den besten kommerziellen Modellen mithalten.
Drei Durchbrüche: Schluss mit „plastischer“ KI-Musik
Die zentralen Vorteile von SongGeneration2 beruhen auf einer umfassenden Weiterentwicklung der zugrunde liegenden Architektur, die drei wesentliche Schwachstellen früherer KI-Musik löst:
Hohe Musikalität: Im Gegensatz zum einfachen Aneinanderreihen von Melodien bewältigt dieses Modell komplexe Mehrspur-Arrangements mit beeindruckender räumlicher Tiefe.
Hohe Textgenauigkeit: Unklare Aussprache und halluzinierte Tonhöhenverschiebungen gehören nun der Vergangenheit an. Die Phonemfehlerrate (PER) liegt bei nur 8,55 % und übertrifft damit deutlich das führende kommerzielle Modell Suno v5 (12,4 %), wobei es nur von MiniMax2.5 übertroffen wird.
Hohe Steuerbarkeit: Ob durch Textbeschreibungen oder Audio-Eingaben – das Modell folgt Anweisungen präzise und ermöglicht so eine tiefgehende Anpassung von Stil und Emotion.
„Dual-Core“-Antrieb: Eine Traumkollaboration zwischen LLM- und Diffusionsmodellen
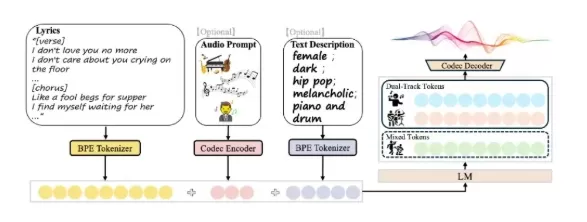
Architektonisch nutzt SongGeneration2 eine innovative hybride LLM-Diffusions-Architektur:
Composing Brain (LeLM): Übernimmt die Planung der Gesamtstruktur und die stimmlichen Details und löst damit die Herausforderung, „wie man singt“.
High-Fidelity-Renderer (Diffusion): Synthetisiert unter Anleitung des Sprachmodells äußerst komplexe akustische Details.
Hierarchische Darstellung: Als erstes System nutzt es die parallele Modellierung gemischter und mehrspuriger Darstellungen und schafft so ein Gleichgewicht zwischen melodischer Stabilität und Verfeinerung der Klangqualität.
Echte Open Source, niedrige Einstiegshürde: Auch gewöhnliche Computer können „Songs schreiben“
Was die Entwickler am meisten begeisterte, war die bemerkenswerte Offenheit von Tencent. Das Modell „SongGeneration-v2-large“ mit 4 Milliarden Parametern ist nun vollständig Open Source und unterstützt die mehrsprachige Generierung, darunter Chinesisch und Englisch. Bemerkenswerterweise läuft es reibungslos auf handelsüblicher Hardware mit nur 22 GB VRAM und ermöglicht so die lokale und private Musikproduktion.
Damit Nutzer es sofort ausprobieren können, hat das Team außerdem die Version „SongGeneration-v2-Fast“ auf HuggingFace veröffentlicht, bei der ein minimaler Verlust an Audioqualität gegen eine ultraschnelle Generierung eingetauscht wird – so entsteht ein kompletter Song in weniger als einer Minute.
Basierend auf der Leistung von SongGeneration2 hat sich KI-Musik offiziell von einem „Geek-Spielzeug“ in den Bereich „kommerziell nutzbarer Anwendungen“ weiterentwickelt. Mit der bevorstehenden Veröffentlichung eines Medium-Modells, das 12 GB VRAM unterstützt, sowie eines automatisierten Bewertungsframeworks könnte nun endlich die Ära anbrechen, in der jeder zum „Komponisten“ wird.
Verwandter Artikel
 DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter
Einhaltung der Vorschriften für autonome Fahrzeuge in Kalifornien: Eine neue Ära von Bußgeldern, Geofences und 1 Million Meilen
Guident betreibt einen AuveTech-Shuttle in Südflorida und verwaltet mithilfe seiner Fernüberwachungstechnologie eine vier Meilen lange Strecke in West Palm Beach sowie eine eine Meile lange Strecke in
Empfehlungen zu verwandten Spezialthemen
Videoerstellung
 KI-Generatoren für ansprechende Kurzvideos für Reels, Shorts und Produkteinführungskampagnen
Die besten KI-Generatoren für kurze Video-Hooks des Jahres 2026 für Reels, Shorts und Produkteinführungskampagnen! XIX.AI stellt erstklassige, leistungsstarke und bahnbrechende Tools zusammen, die in Praxistests überzeugende Ergebnisse liefern, die Sie unbedingt ausprobieren sollten. Diese wöchentlich aktualisierte Seite bietet Vergleichsrankings zwischen kostenlosen und kostenpflichtigen Angeboten, damit Sie die perfekte Lösung finden, um Ihre Kreativität und Produktivität bei der Erstellung von Inhalten zu steigern. Entdecken Sie jetzt die Seite und sichern Sie sich Ihren KI-Vorteil!
 11 Tools
 xix.ai
Schreiben
KI-Tools zur Gliederung von Artikeln für das Verfassen langer Texte
2026: Die neuesten, besten und am besten bewerteten KI-Tools zur Erstellung von Gliederungen für lange Texte! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die präzise, strukturierte Gliederungen liefern – getestet unter realen Bedingungen –, um die Effizienz beim Schreiben deutlich zu steigern. XIX.AI gehört zu dieser Eliteauswahl. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen bei der Auswahl des perfekten Tools hilft. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
9 Tools
xix.ai
Chatbot
Die besten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprechflüssigkeit
2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
10 Tools
xix.ai
Musikkomposition
KI-Tools zur Stim-Trennung für die Remix-Produktion, die Vorbereitung von Samples und Karaoke-Master
Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai
Datenanalyse
KI-basierte SQL-Copiloten für Umsatz-Dashboards, Kanalanalysen sowie Produktmetriken
2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai
Musikkomposition
Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

 Kommentare (0)
Anfang 2026 erlebte die KI-Musikbranche einen weiteren bedeutenden Wandel. Am 9. März wurde das Musik-Grundmodell „SongGeneration2“, das gemeinsam von
Drei Durchbrüche: Schluss mit „plastischer“ KI-Musik
Die zentralen Vorteile von
Hohe Musikalität: Im Gegensatz zum einfachen Aneinanderreihen von Melodien bewältigt dieses Modell komplexe Mehrspur-Arrangements mit beeindruckender räumlicher Tiefe.
Hohe Textgenauigkeit: Unklare Aussprache und halluzinierte Tonhöhenverschiebungen gehören nun der Vergangenheit an. Die Phonemfehlerrate (PER) liegt bei nur 8,55 % und übertrifft damit deutlich das führende kommerzielle Modell
Hohe Steuerbarkeit: Ob durch Textbeschreibungen oder Audio-Eingaben – das Modell folgt Anweisungen präzise und ermöglicht so eine tiefgehende Anpassung von Stil und Emotion.
„Dual-Core“-Antrieb: Eine Traumkollaboration zwischen LLM- und Diffusionsmodellen
Architektonisch nutzt
Composing Brain (LeLM): Übernimmt die Planung der Gesamtstruktur und die stimmlichen Details und löst damit die Herausforderung, „wie man singt“.
High-Fidelity-Renderer (Diffusion): Synthetisiert unter Anleitung des Sprachmodells äußerst komplexe akustische Details.
Hierarchische Darstellung: Als erstes System nutzt es die parallele Modellierung gemischter und mehrspuriger Darstellungen und schafft so ein Gleichgewicht zwischen melodischer Stabilität und Verfeinerung der Klangqualität.
Echte Open Source, niedrige Einstiegshürde: Auch gewöhnliche Computer können „Songs schreiben“
Was die Entwickler am meisten begeisterte, war die bemerkenswerte Offenheit von Tencent. Das Modell „SongGeneration-v2-large“ mit 4 Milliarden Parametern ist nun vollständig Open Source und unterstützt die mehrsprachige Generierung, darunter Chinesisch und Englisch. Bemerkenswerterweise läuft es reibungslos auf handelsüblicher Hardware mit nur 22 GB VRAM und ermöglicht so die lokale und private Musikproduktion.
Damit Nutzer es sofort ausprobieren können, hat das Team außerdem die Version „SongGeneration-v2-Fast“ auf HuggingFace veröffentlicht, bei der ein minimaler Verlust an Audioqualität gegen eine ultraschnelle Generierung eingetauscht wird – so entsteht ein kompletter Song in weniger als einer Minute.
Basierend auf der Leistung von








 DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
 OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter
Einhaltung der Vorschriften für autonome Fahrzeuge in Kalifornien: Eine neue Ära von Bußgeldern, Geofences und 1 Million Meilen
Guident betreibt einen AuveTech-Shuttle in Südflorida und verwaltet mithilfe seiner Fernüberwachungstechnologie eine vier Meilen lange Strecke in West Palm Beach sowie eine eine Meile lange Strecke in

Die besten KI-Generatoren für kurze Video-Hooks des Jahres 2026 für Reels, Shorts und Produkteinführungskampagnen! XIX.AI stellt erstklassige, leistungsstarke und bahnbrechende Tools zusammen, die in Praxistests überzeugende Ergebnisse liefern, die Sie unbedingt ausprobieren sollten. Diese wöchentlich aktualisierte Seite bietet Vergleichsrankings zwischen kostenlosen und kostenpflichtigen Angeboten, damit Sie die perfekte Lösung finden, um Ihre Kreativität und Produktivität bei der Erstellung von Inhalten zu steigern. Entdecken Sie jetzt die Seite und sichern Sie sich Ihren KI-Vorteil!
11 Tools
xix.ai

2026: Die neuesten, besten und am besten bewerteten KI-Tools zur Erstellung von Gliederungen für lange Texte! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die präzise, strukturierte Gliederungen liefern – getestet unter realen Bedingungen –, um die Effizienz beim Schreiben deutlich zu steigern. XIX.AI gehört zu dieser Eliteauswahl. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen bei der Auswahl des perfekten Tools hilft. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
9 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai












